编者按:
8 月 22 日,2026 时序数据技术创新大会在北京成功举办,引发广泛关注。本次大会以「DB × AI」为主题,多位院士专家领衔,超 30 位嘉宾齐聚一堂,共同探讨数据库与人工智能融合发展的新趋势、新技术与新实践。
天谋科技数据库内核研发工程师、*Apache TsFile PMC Member 李烁麟在技术分论坛发表*“文件基座:Apache TsFile 如何融入 AI 数据生态”主题演讲。
TsFile 也更新了2.5.0 版本,增加了对 go 语言的支持、提升了 TsFileDataFrame 随机读取的性能,修复了若干兼容bug,欢迎大家更新使用,提出意见。
全文 4 千余字,阅读约需 8 分钟,以下是来自李烁麟的演讲内容:
从数据采集到模型训练:TsFile 的角色
这次分享,我主要会介绍我们如何提升了 TsFile 的读写性能,以及如何用 TsFile 组织文件集合,并将其应用于大模型训练。
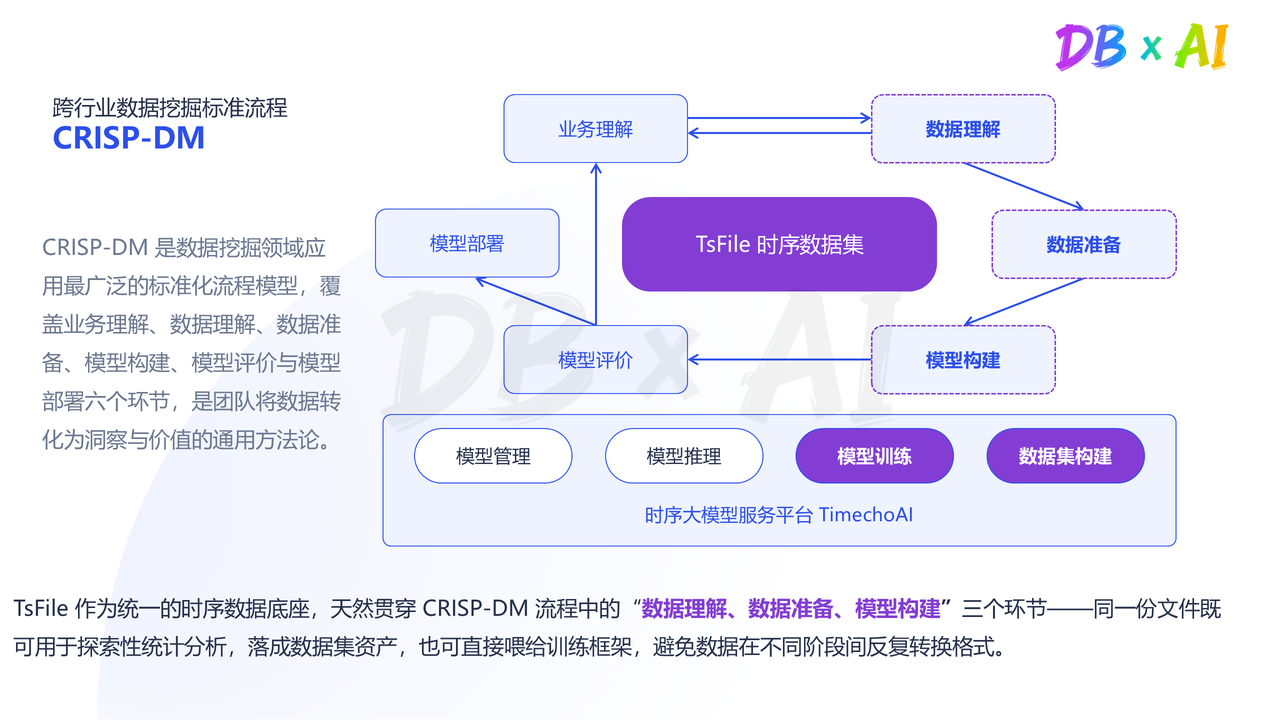
来看数据挖掘领域的 CRISP-DM 模型。该模型将数据挖掘过程划分为业务理解、数据理解、数据准备、模型构建、模型评估和模型部署等环节。在这一流程中,TsFile 主要参与数据理解、数据准备和模型构建阶段,并作为数据的承载介质,支撑数据从采集、治理到训练的持续流转。
如下图所示,终端和传感器产生的数据持续汇入数据系统,经过质量评估、元数据管理和标准化处理,并通过统一组织和管理,逐步形成可复用、可共享的数据资产,为构建高质量时序数据集、开展时序大模型训练提供支撑。
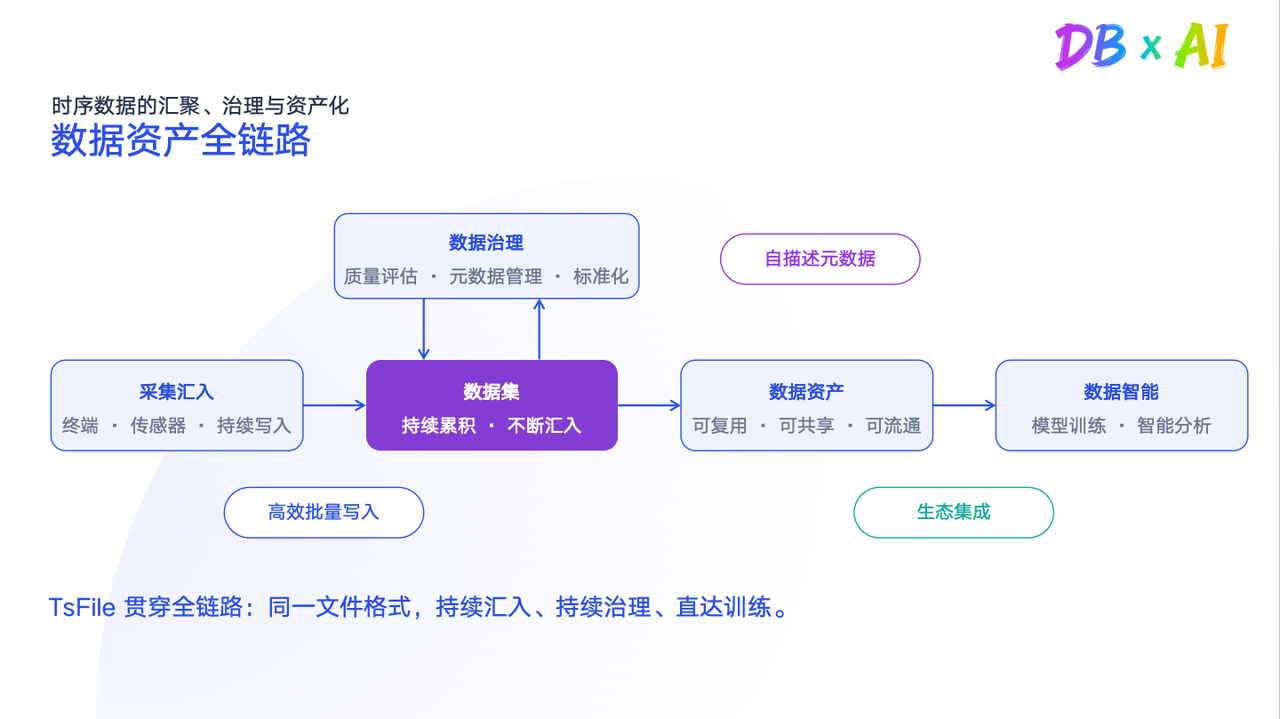
在此过程中,TsFile 作为统一的时序数据文件格式,配合数据组织与访问工具,为数据的长期保存、按需读取及跨环节复用提供支持,帮助减少数据流转中的重复转换与处理开销。
天谋科技在 Timer 时序大模型的研发与训练过程中,也使用 TsFile 存储和组织大规模时序数据,以支持时序大模型训练。
围绕这一数据闭环,我们重点开展了以下四方面工作:
增强了 TsFile 的批量读写能力,提升数据获取和存储效率。
将 TsFile 集成到模型训练和智能分析流程中,并设计新的数据抽象,提升模型训练过程中的数据访问能力。
推出了 TsFile CLI 和相关 skills,帮助用户更加便捷地理解和处理数据。
通过 PyPI、APT 等渠道持续完善 TsFile 的工具与生态集成,让数据处理和模型训练更加顺畅、可靠。
欢迎大家星标支持 TsFile
传送门:
https://github.com/apache/tsfile
高效读写:从批量接口到内核性能优化
在 TsFile 接口方面,我将重点介绍目前支持的高效读取和写入方式。
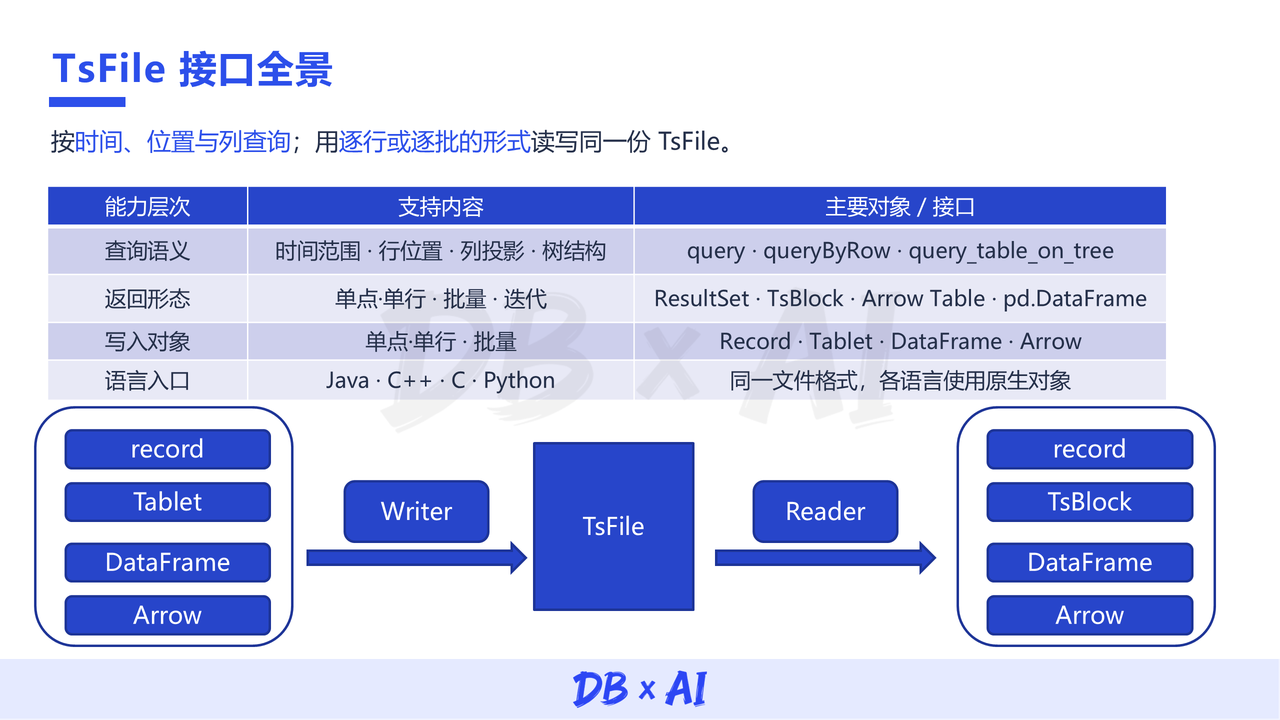
TsFile 的语言支持范围也在不断扩展,目前已支持 Java、C++、 Python 和 Go。不同语言的接口可以基于同一种文件格式,以不同粒度完成数据写入和读取,用户也可以根据实际需求灵活组合 TsFile 的读写接口。
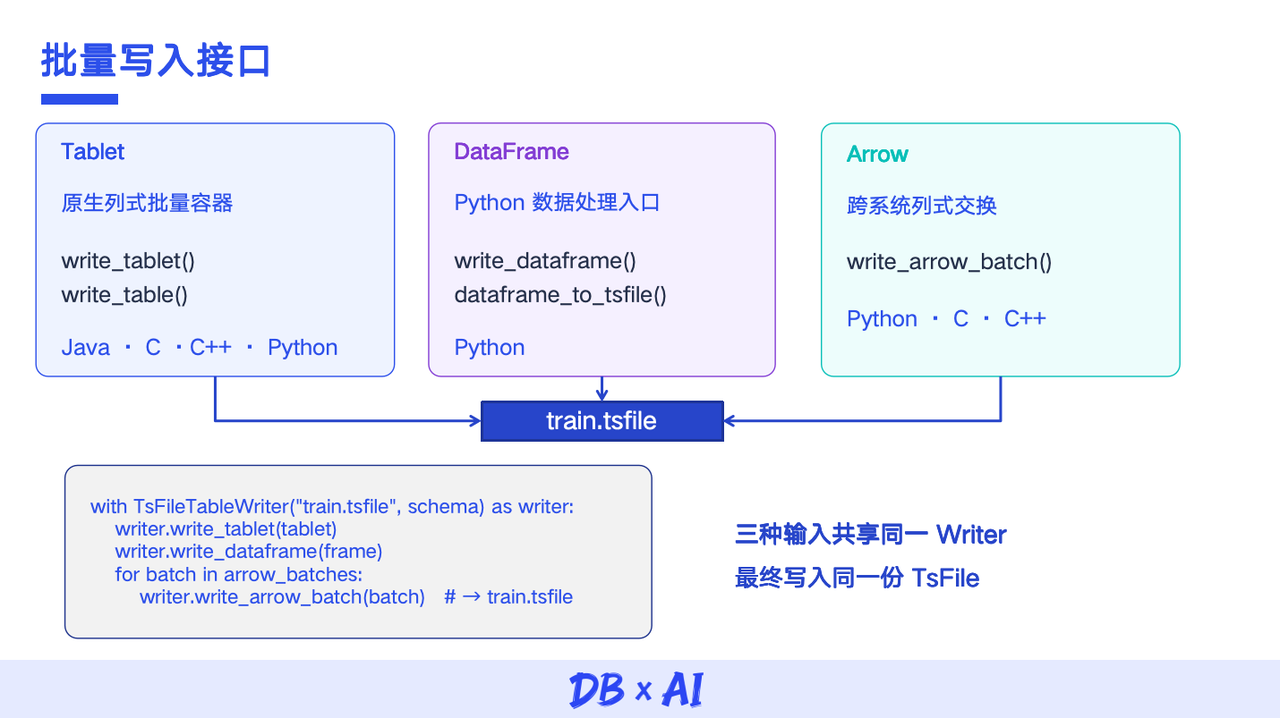
在写入方面,我们提供了多种批量接口。Tablet 是各语言原生支持的批量写入容器;在 Python 中,我们还实现了 DataFrame 对象的写入和读取机制。此外,TsFile 也支持 Apache Arrow 相关接口,便于与采用 Arrow 列式内存格式的数据分析和计算工具交换批量数据,减少不必要的数据转换开销实现高性能、跨源和跨系统读写。
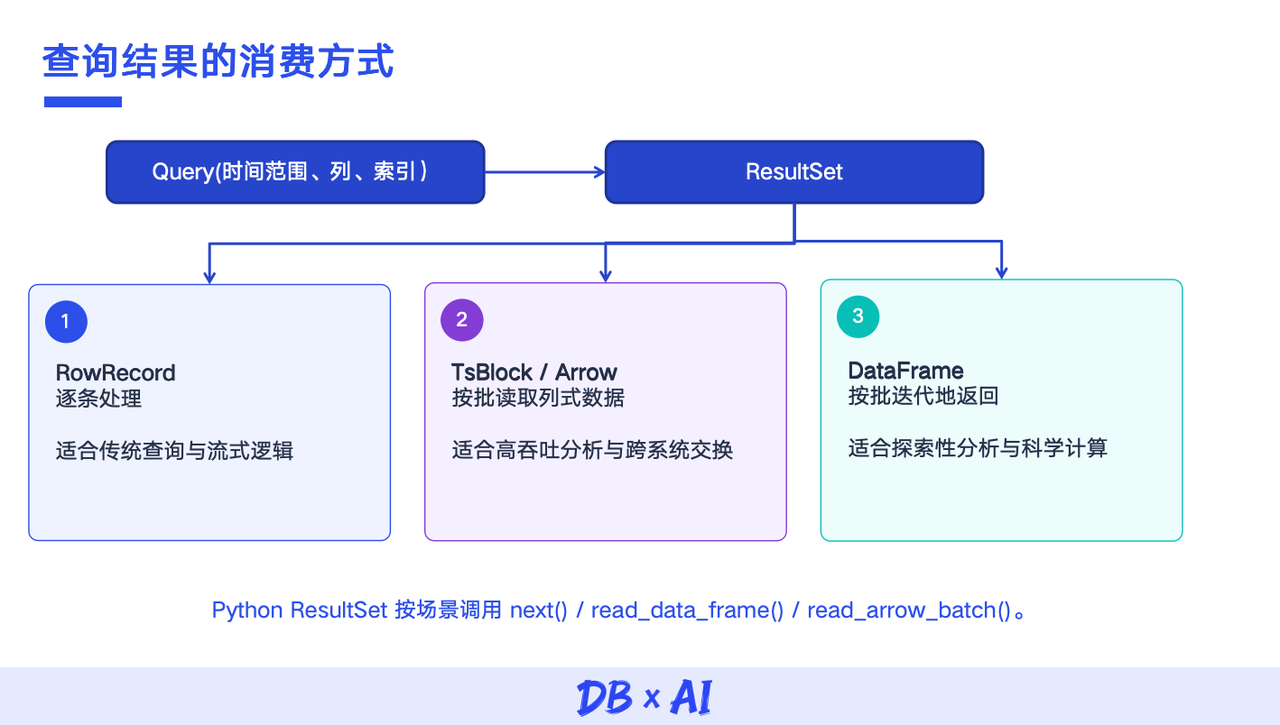
在查询方面,TsFile 支持按时间范围、指定列或行位置访问数据。 查询结果既可以逐行遍历,也可以按批次读取,分别满足逐条处理和批量分析的需求。在 Python 中,用户还可以将查询结果按批次读取为 pandas DataFrame 或 Arrow 表,便于接入后续的数据分析和模型训练流程。
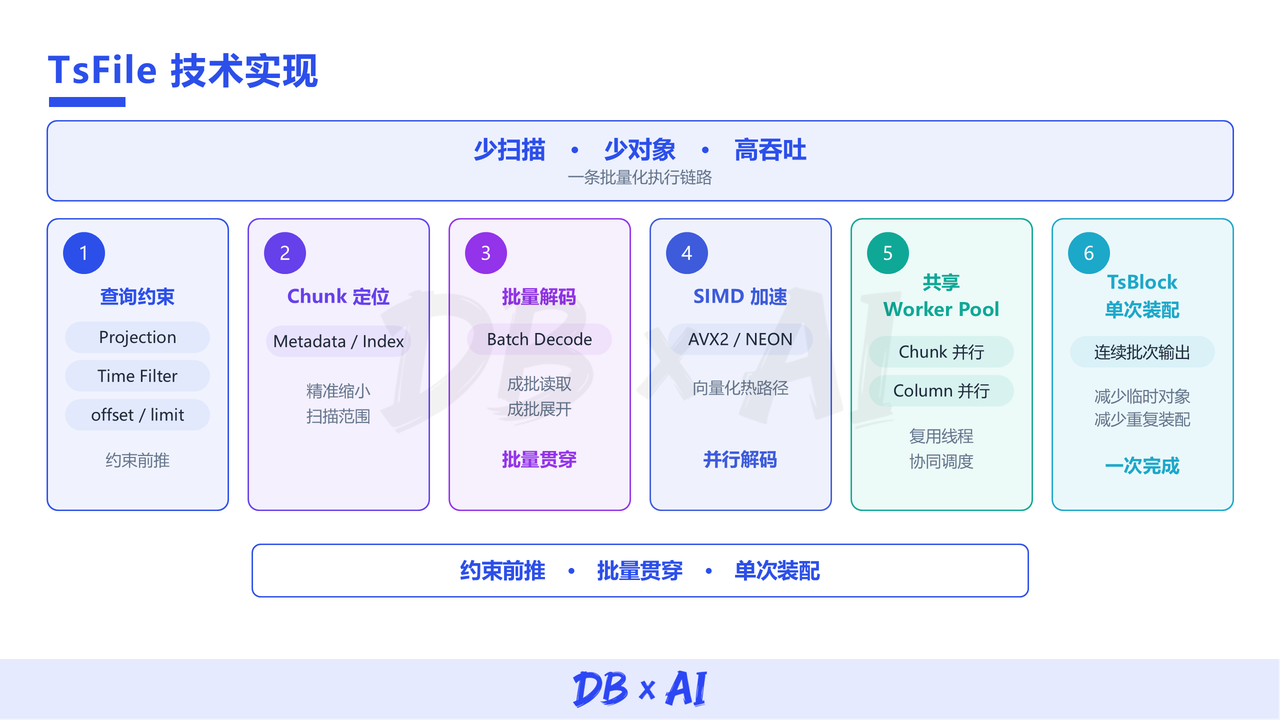
在内核层面,我们围绕查询裁剪、批量编解码和并行调度优化读写链路。 通过下推列投影、时间过滤和行偏移等约束,结合 Chunk、Page 的元数据与统计信息减少无效扫描和解码;编解码与过滤采用批量处理,并在适合的热路径上利用 SIMD 加速。读写任务统一由共享线程池调度,分别支持 Chunk Writer 并行编码和多列并行解码;结果以 TsBlock 按批次组织,减少行对象构造、重复装配及不必要的内存拷贝。得益于上述优化,TsFile 的读写性能相较之前的版本实现了大幅提升。
跨文件访问:TsFileDataFrame 统一组织文件、分片与时间序列
第二方面我们介绍 TsFileDataFrame。它主要解决跨文件数据读取和组织的问题。
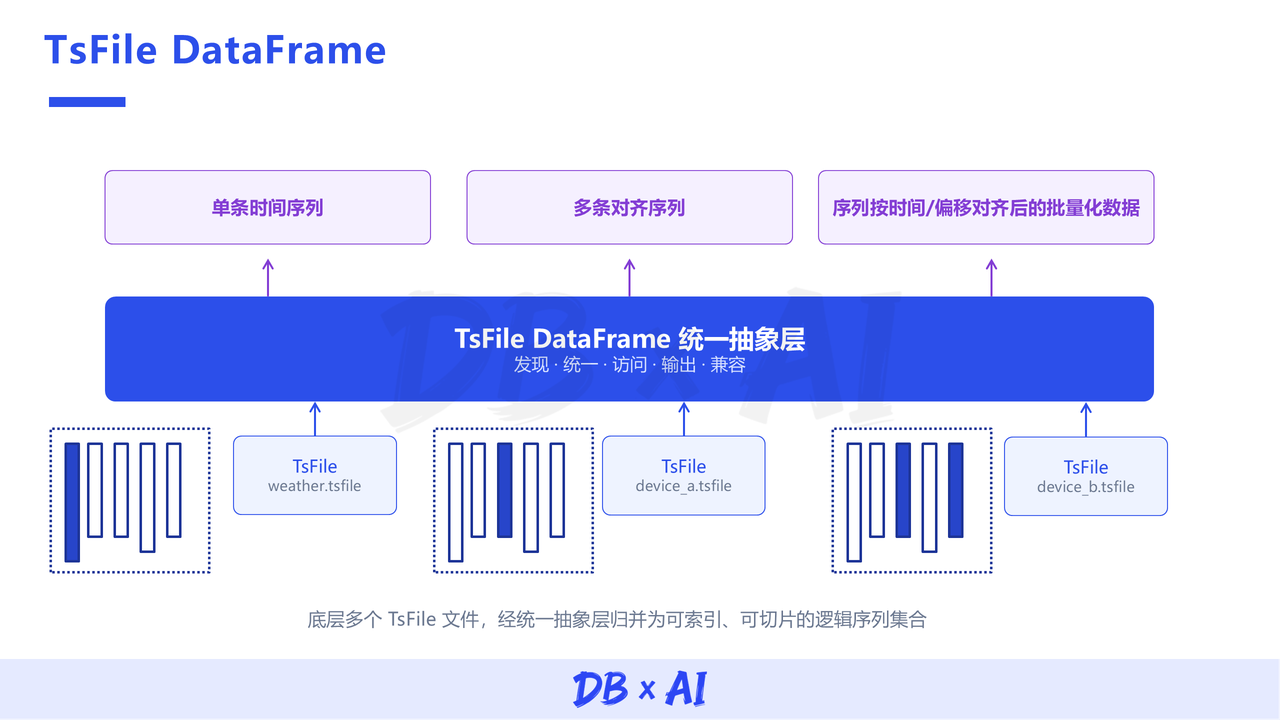
在实际场景中,数据会持续产生,同一台或多台设备可能不断生成新的 TsFile。当我们拿到包含多个 TsFile 的文件夹时,如果每次都需要逐个打开文件、查找序列并读取数据,就会增加数据准备和访问的复杂度,因此不应逐个处理文件,而是需要将整个文件夹视为一个统一的逻辑对象。
为此,TsFileDataFrame 对分散在不同文件中的时间序列进行统一组织,为后续的数据访问和分析提供了一致的操作入口。
一个 TsFileDataFrame 可以访问文件夹中的所有 TsFile,并将其中的逻辑对象汇集为一条或多条时间序列。在这个统一的逻辑对象上,我们可以按照序列名称、偏移量或时间范围进行索引和窗口过滤,输出适合后续分析的时间对齐数据结构。
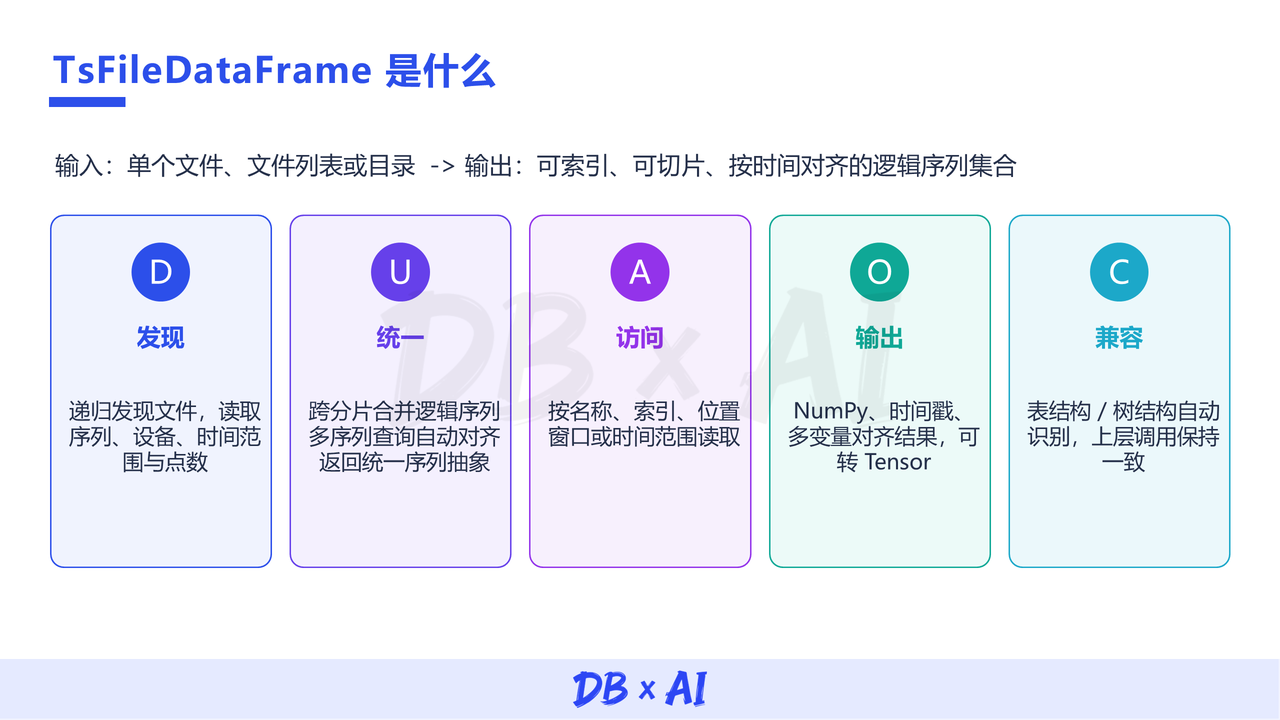
这项能力在多变量场景下尤为重要:在预训练和后训练中,相关变量可能分散在不同文件或设备中。TsFileDataFrame 支持按时间戳对这些序列进行归并与对齐,将相关变量组织到共同的时间轴上,为后续的数据分析和模型训练提供统一的多变量输入。
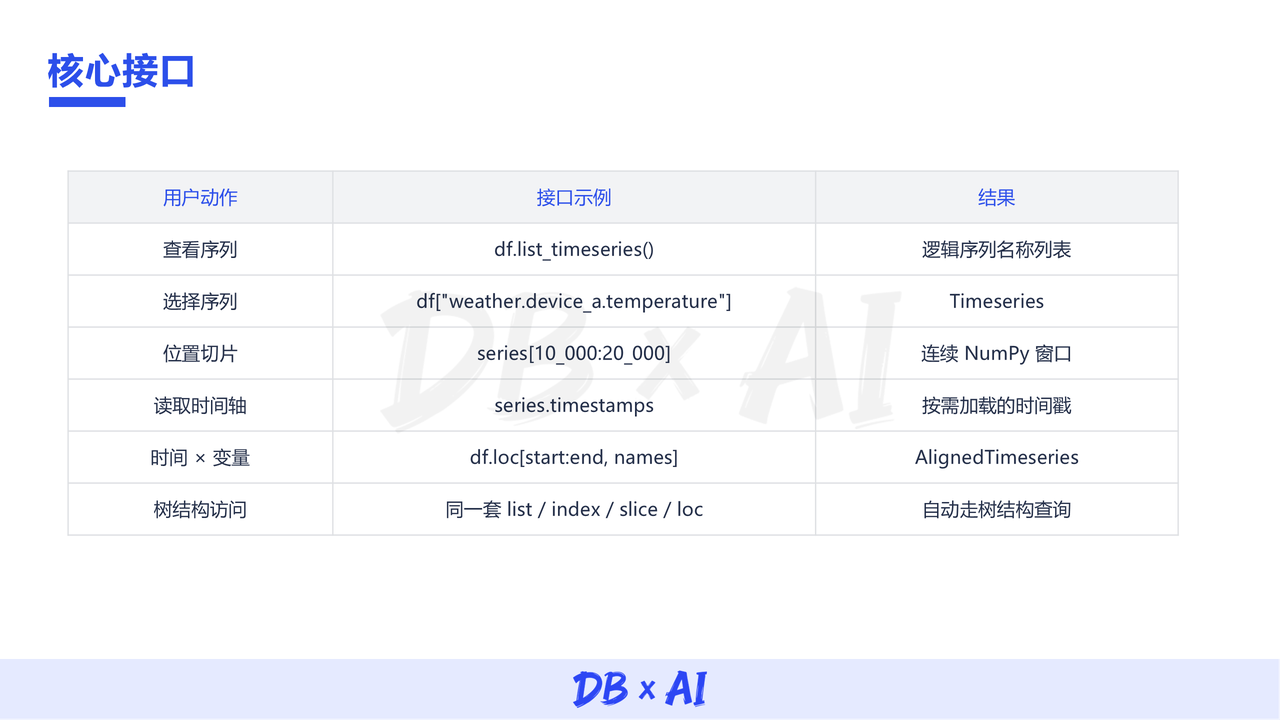
围绕这一逻辑对象,我们还提供了一套标准接口。用户可以列出文件夹中的全部时间序列,从中选择一条或多条序列,再按照偏移量或时间范围读取数据;也可以同时指定时间和变量,获取经过时间排序与对齐的多变量序列。这套机制同样适用于树模型。
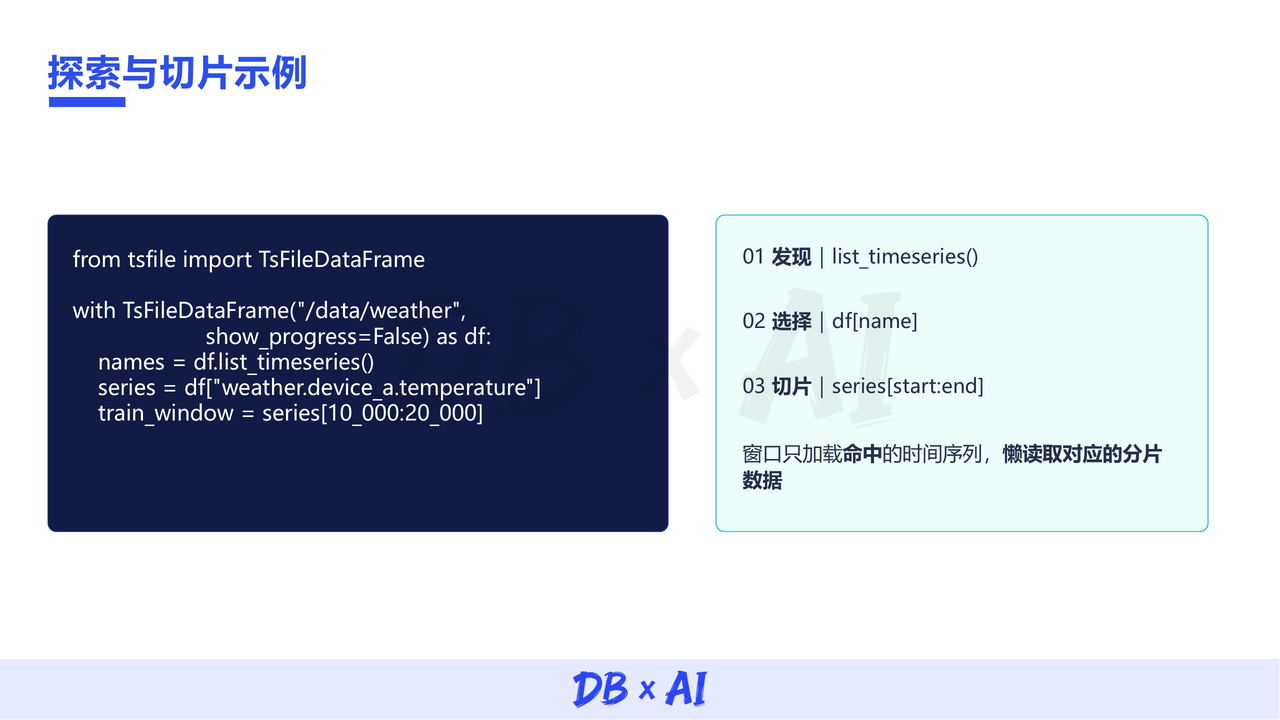
TsFileDataFrame 采用惰性访问机制。以包含大量文件的数据集为例,当我们列出或选择时间序列时,系统只读取文件尾部的元数据,避免一开始就加载全部数据;只有真正执行数据读取操作时,才会读取对应的数据内容。因此,即使一个数据集包含大量文件,我们也可以先选择所需的时间序列和数据范围,例如读取第 1 万至第 2 万行数据,再按需加载。这种方式能够减少不必要的数据读取和内存占用,避免额外的数据物化。
下面的示例展示了 TsFileDataFrame 的多变量时间对齐能力。对于需要联合访问目标变量及相关变量的训练或分析任务,用户可以在一次查询中指定时间范围和变量。TsFileDataFrame 会协调底层 Reader,读取来自不同文件或设备的数据,并完成分片归并与时间戳对齐,返回统一的多变量结果,减少上层手动读取和对齐的工作。对于同一文件、同一设备的对齐字段,还可以合并读取,减少时间轴的重复解码,进一步降低读取开销。
TsFileDataFrame 让数据直接服务于模型训练
TsFileDataFrame 将文件夹中的多个 TsFile 组织为统一的时间序列集合,并提供一致的数据访问接口。那么,如何利用它为大模型训练组织和读取数据?
在具体的数据管理实践中, 我们通过外置的 Dataset JSON 文件描述具体的业务信息。我们根据实际需求设计了 JSON Schema,在其中定义原变量和目标变量,并描述多变量训练、分类等任务所需的信息。在发布数据集时,也支持将 JSON 文件一并发布。
其中,TsFile 负责保存时序数据及其结构信息,而外置的 Dataset JSON 则进一步描述变量角色、任务类型等训练相关的业务语义,两者共同构成面向具体训练任务的数据集组织方案。
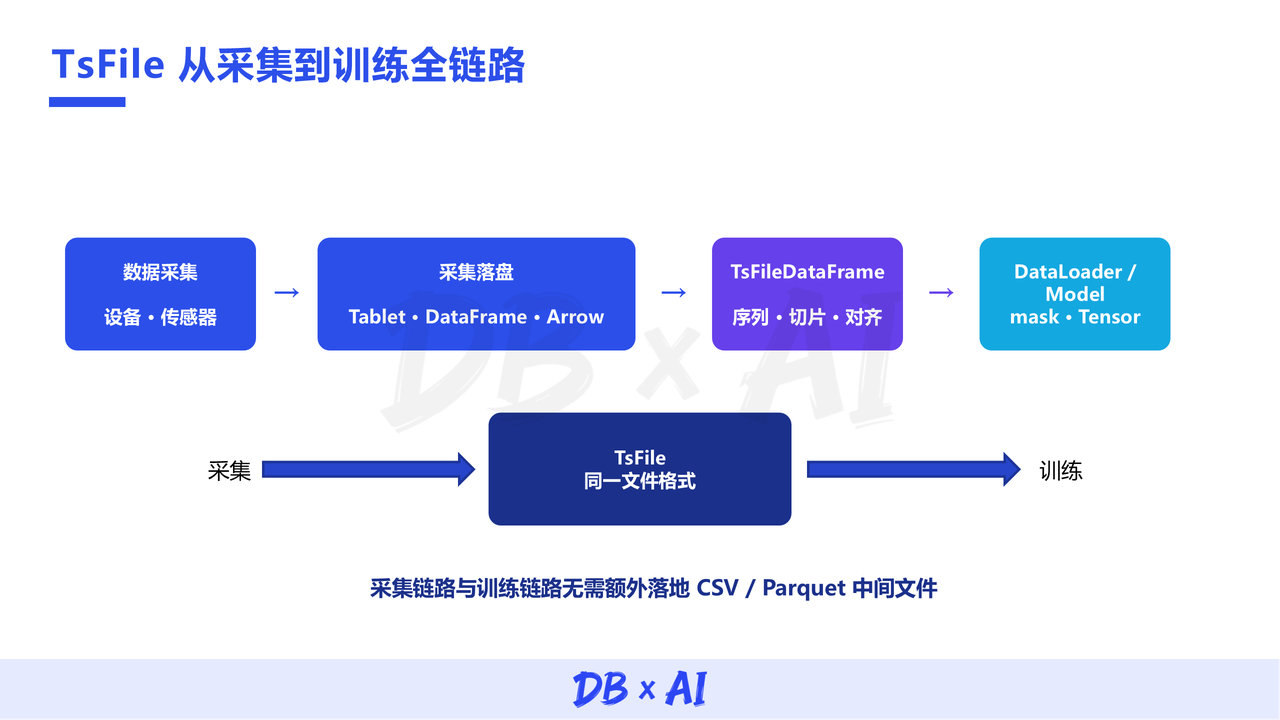
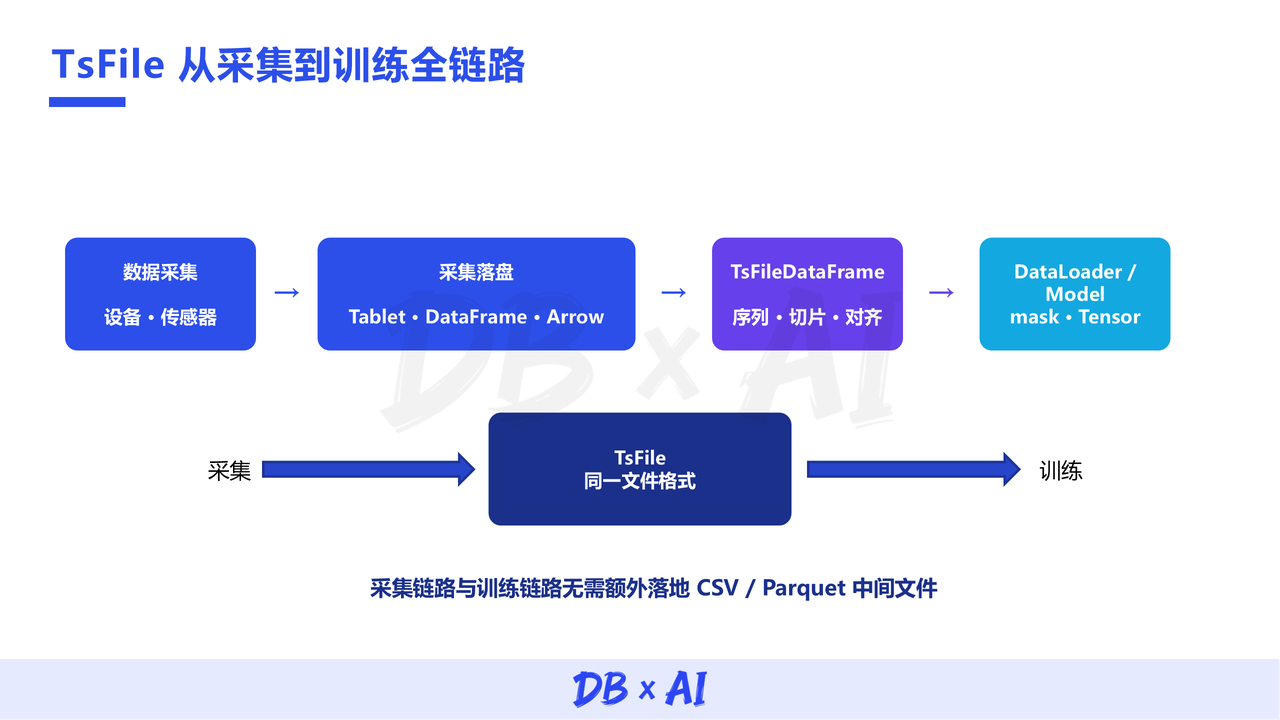
从采集到训练的全链路,都可以围绕一个 TsFile 文件格式展开。从数据采集开始,设备产生的数据可以持续写入和更新 TsFile数据集,再由 TsFileDataFrame 将一个或多个文件抽象为统一的逻辑对象,直接服务于数据分析和模型训练。由此,采集链路和训练链路可以围绕同一种文件格式贯通,无须再将数据转换为 CSV 等中间格式。
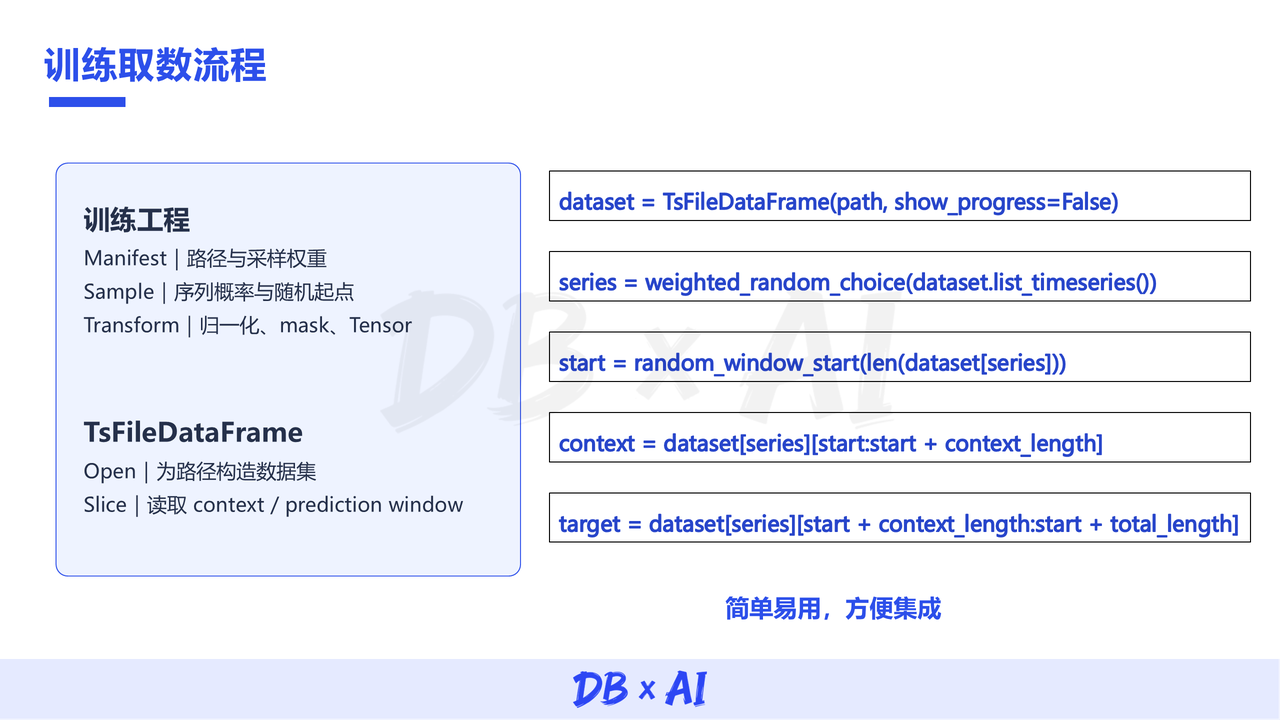
下面来看 TsFileDataFrame 在训练取数流程中的应用。在具体的模型训练场景中,训练框架通常会配置不同数据集的权重、采样概率和采样策略。TsFileDataFrame 负责打开相应的数据集文件,并根据训练需求构造查询请求。
训练取数流程如图所示:首先,通过 TsFileDataFrame 打开数据集,获取可用序列及其长度等元数据;随后,训练框架按照采样策略选择序列,随机确定窗口起点和范围;最后,按需读取窗口内的数据,组织为训练所需的输入和目标。序列选择与窗口定位主要基于元数据完成,窗口内容则在实际取数时加载,从而减少无关数据的读取和内存占用。我们目前的系统也采用了这一取数方式。
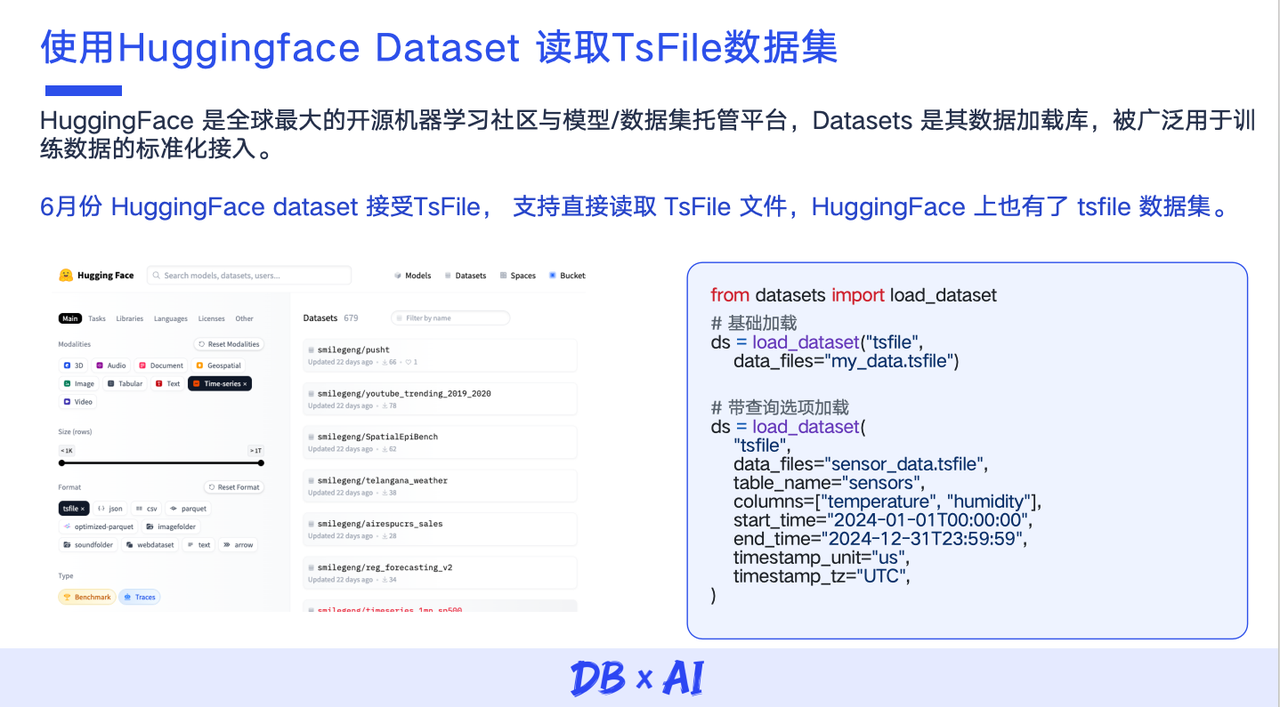
在 AI 数据生态方面,Hugging Face 已将 TsFile 纳入原生文件格式支持范围。大家可以在 Hugging Face 官网找到我们转换为 TsFile 格式的相关数据集。右侧展示的是 Hugging Face Datasets 的官方用法:调用 load_dataset 时,可以传入一个或多个 TsFile,并根据需要执行过滤和查询。
TsFile 数据集传送门:
https://huggingface.co/datasets?format=tsfile&sort=trending
AI 赋能:让智能体更方便地理解和操作 TsFile
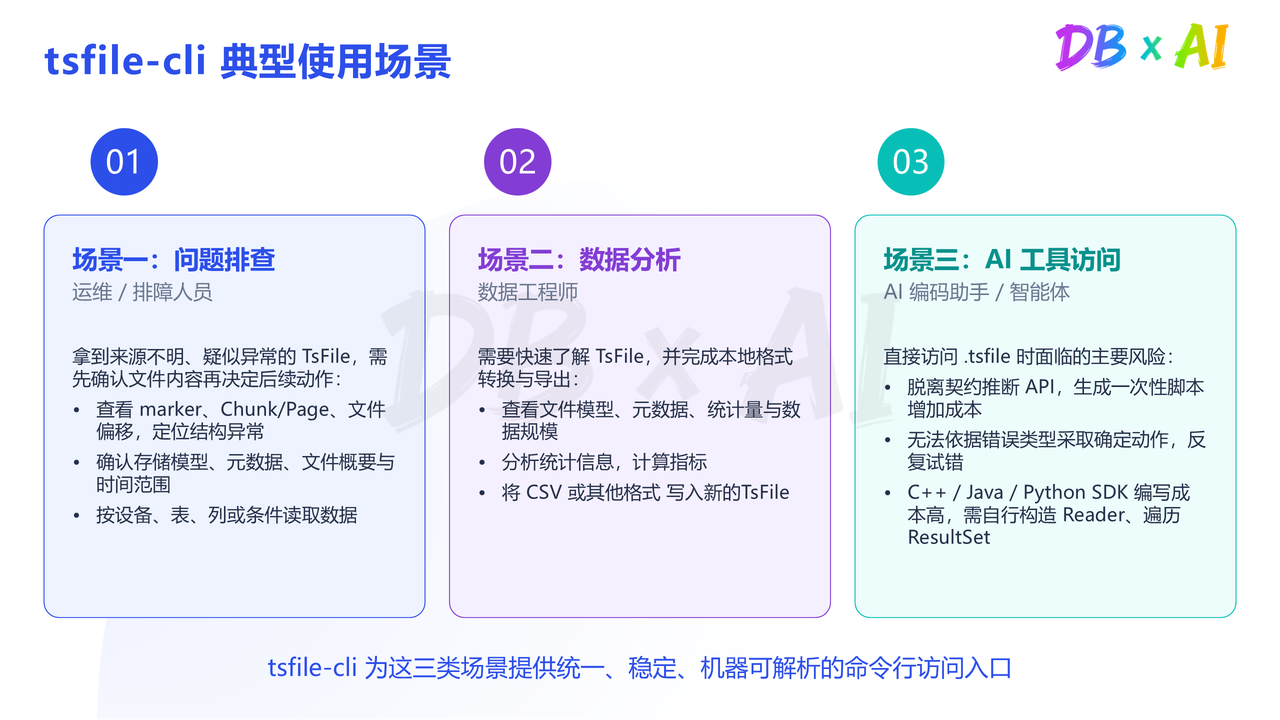
前面介绍了如何使用 TsFile 服务 AI,接下来介绍如何借助 AI 更便捷地使用 TsFile。为此,我们提供了 TsFile CLI 及其配套 Skills,主要面向以下三类典型场景。
第一类是开发、运维和故障排查。过去,技术人员拿到一个存在异常的 TsFile 文件后,可能需要调用 IoTDB 中的 TsFile 打印脚本,或者自行编写代码,才能将文件内容转换为可读信息。这种方式不仅操作复杂,也要求使用者熟悉相关代码。借助 TsFile CLI,技术人员可以直接查看文件的逻辑结构、物理布局和异常位置,更快地判断文件出现了什么问题。
第二类是数据探索与分析。数据工程师通常需要对数据进行多轮探索和查询,如果每次都要编写脚本,整个过程会比较繁琐。通过 TsFile CLI,用户可以直接读取文件、组合查询条件并获取所需数据,再将结果交给后续工具进一步处理,从而降低数据探索的使用门槛。
第三类是 AI Agent 的工具调用。缺少标准化工具时,Agent 每执行一次 TsFile 分析任务,都可能需要临时编写、编译和运行代码,不仅流程复杂,也会消耗大量 Token。借助 TsFile CLI,Agent 可以通过一条命令完成文件查询、分析或转换,更高效地调用 TsFile 的各项能力。
TsFile CLI 传送门:
https://tsfile.apache.org/zh/UserGuide/latest/Tools/Tsfile-CLI.html
围绕这些场景,我们在 TsFile CLI 中提供了多种命令。用户可以查看文件中包含哪些表或树结构,以及对应的 Schema、列信息、行数和统计信息;也可以按照文件的物理布局和偏移位置查看数据,快速定位文件问题。此外,我们还提供了类似 Linux head 和 cat 的命令,用于快速查看 TsFile 中的数据。
TsFile CLI 还支持文件拆分、格式转换和数据写入。用户可以将一个较大的 TsFile 导出为多个较小的 CSV 文件,也可以通过 export 命令将数据导出为 CSV。对于 CSV 文件或数据管道中的数据,用户可以直接通过写入命令生成 TsFile。
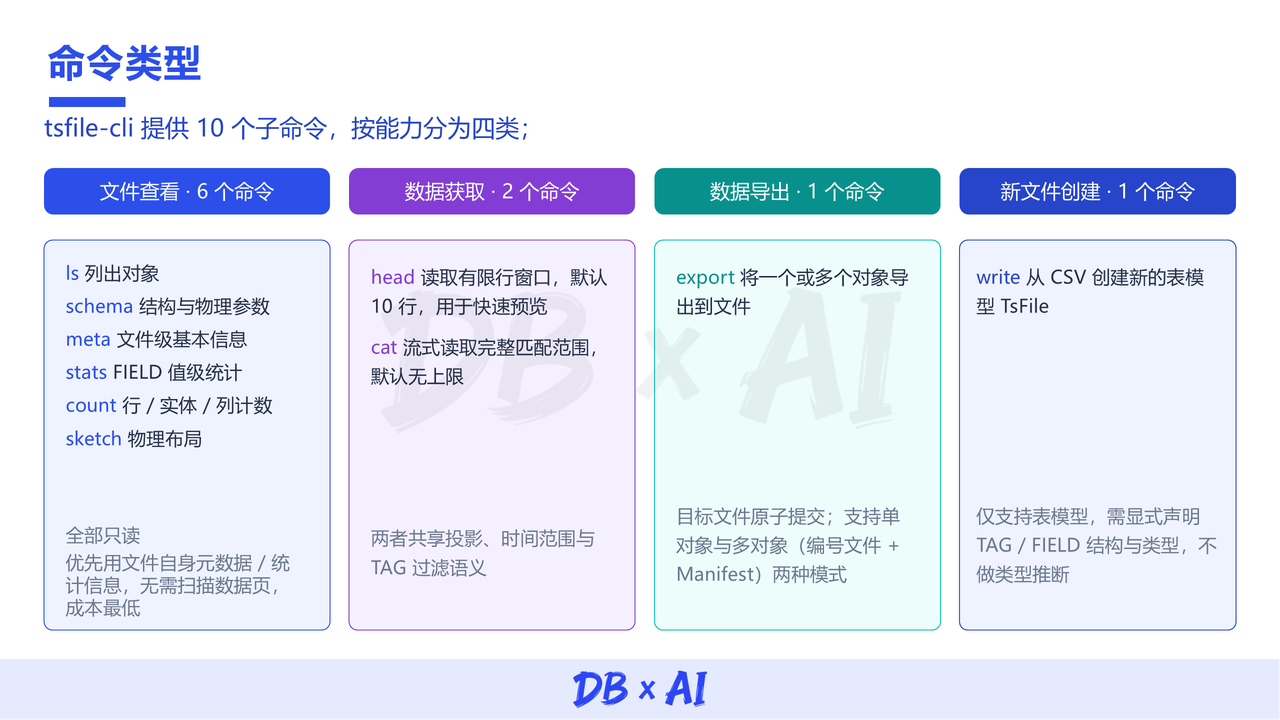
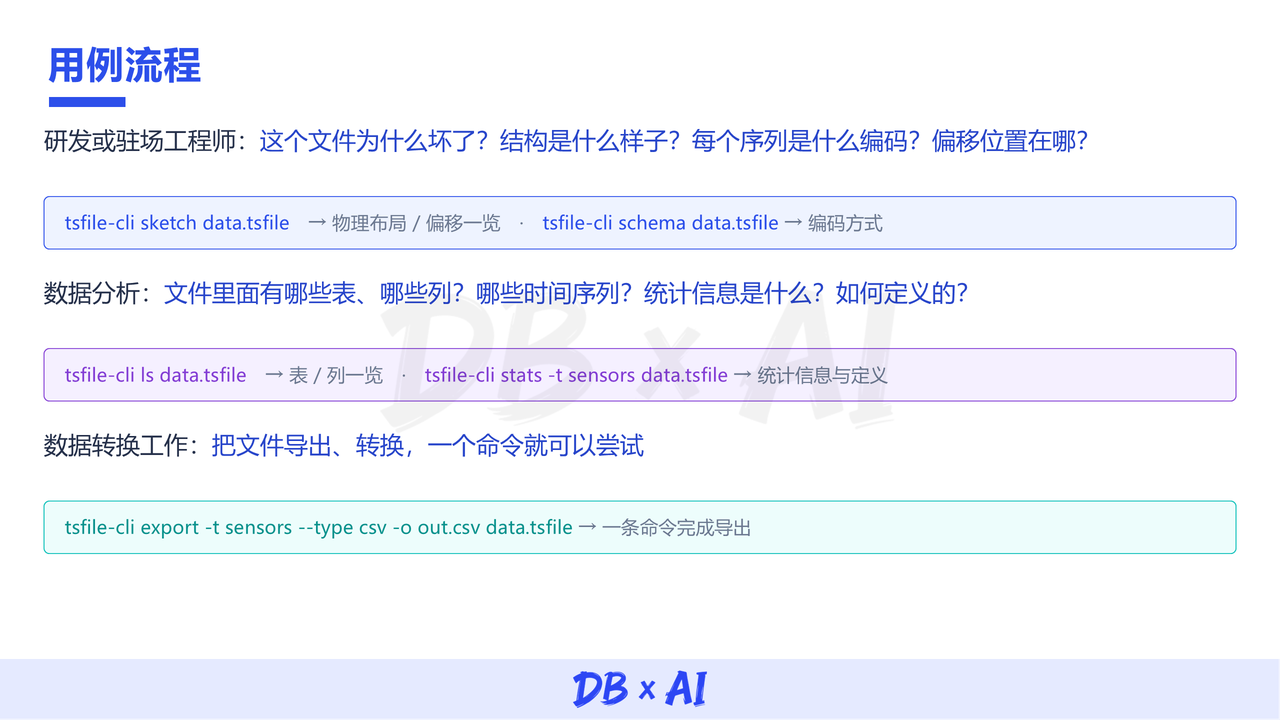
具体使用时,可以根据任务选择相应命令:排查文件问题时,使用 sketch 查看物理布局与偏移信息,结合 schema 检查字段类型、编码和压缩配置;探索数据时,使用 ls 列出表或设备,通过 stats 查看字段统计信息,并用 head 或 cat 读取数据;需要对接其他工具时,则使用 export 将数据导出为 CSV、NDJSON 等格式,接入后续分析与处理流程。
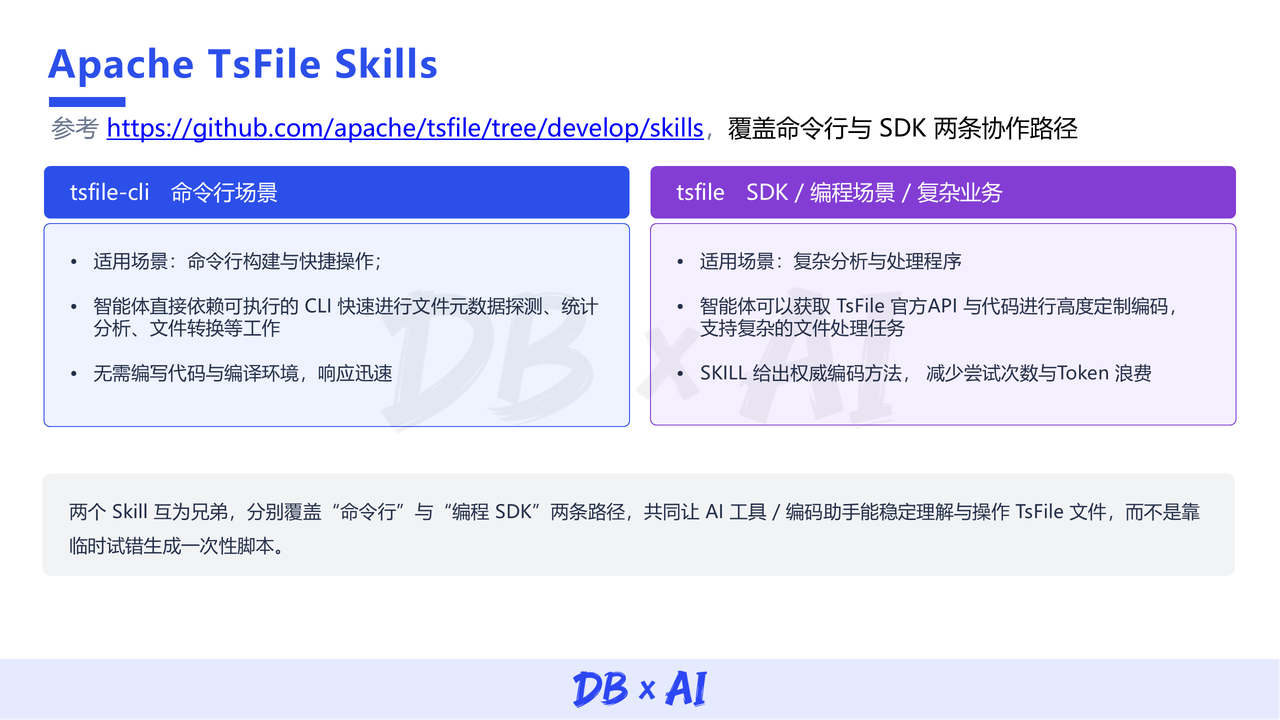
在此基础上,我们还为 AI Agent 提供了两类配套 Skills:一类指导 Agent 使用 CLI 查看和处理 TsFile 文件,另一类指导 Agent 基于 TsFile SDK 编写数据读写与处理代码。CLI 适合数据查看、快速查询和格式转换等相对简单的任务,能够通过终端快速完成操作;代码级 Skill 则适合更复杂的数据处理和分析场景,可以调用 SDK 编写程序,对数据进行定制化处理。二者分别覆盖简单操作与复杂开发需求,共同构成从上层命令调用到底层编程处理的完整工具体系。
TsFile Skills 传送门:
https://github.com/apache/tsfile/tree/develop/skills
生态集成:让 TsFile 更便捷地融入数据分析工具链
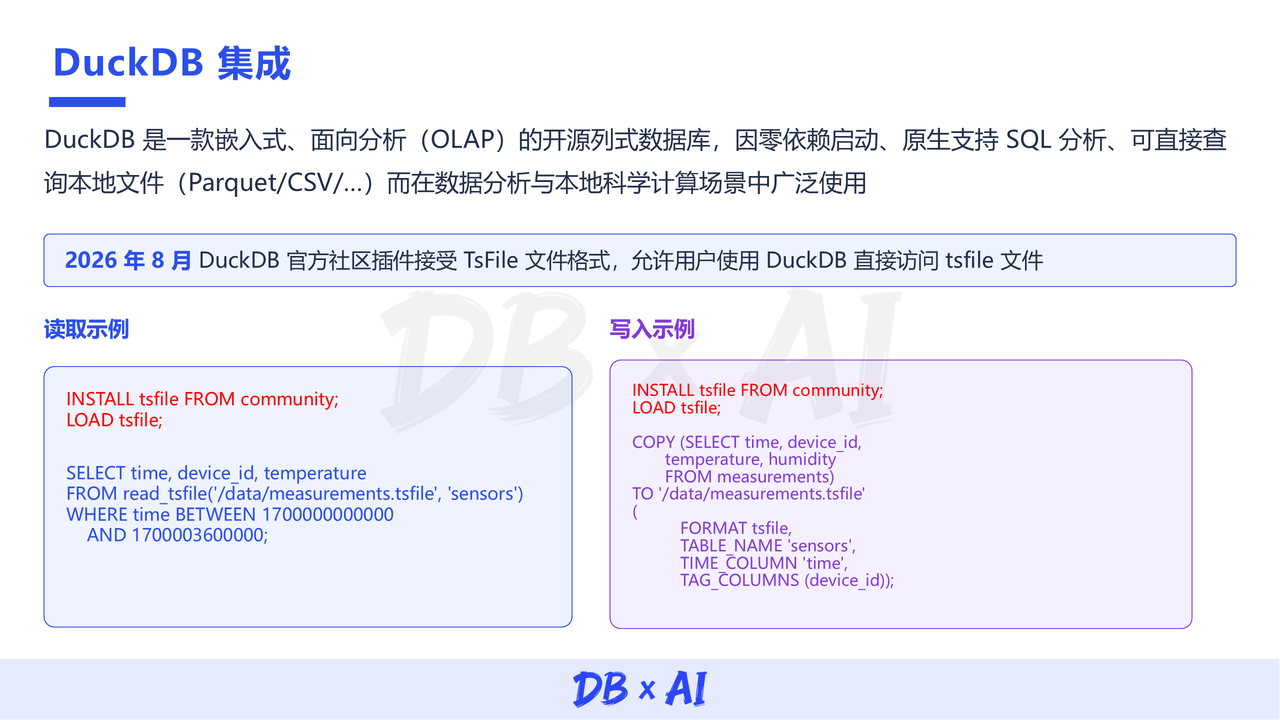
在提供上述工具的基础上,我们也在持续拓展 TsFile 的外部生态。目前,TsFile 已与 DuckDB 实现深度集成。DuckDB 是一款高性能、轻量级的分析型数据库,凭借出色的分析性能和较低的使用门槛,受到许多数据分析师的青睐。
今年 8 月,TsFile 扩展已被纳入 DuckDB Community Extensions。用户可以通过 INSTALL tsfile FROM community 直接安装扩展,并在 DuckDB 中直接读取 TsFile 的表模型数据,利用 SQL 开展分析。扩展也支持将查询结果写入 TsFile,使 TsFile 能够与 DuckDB 的数据分析工具链相互衔接。
例如,用户可以在 DuckDB 中分析和处理 CSV、Parquet 等格式的数据,再将结果保存为 TsFile,供后续时序数据系统或应用使用。这进一步拓展了 TsFile 在数据分析、格式转换和跨系统数据流转中的应用场景。
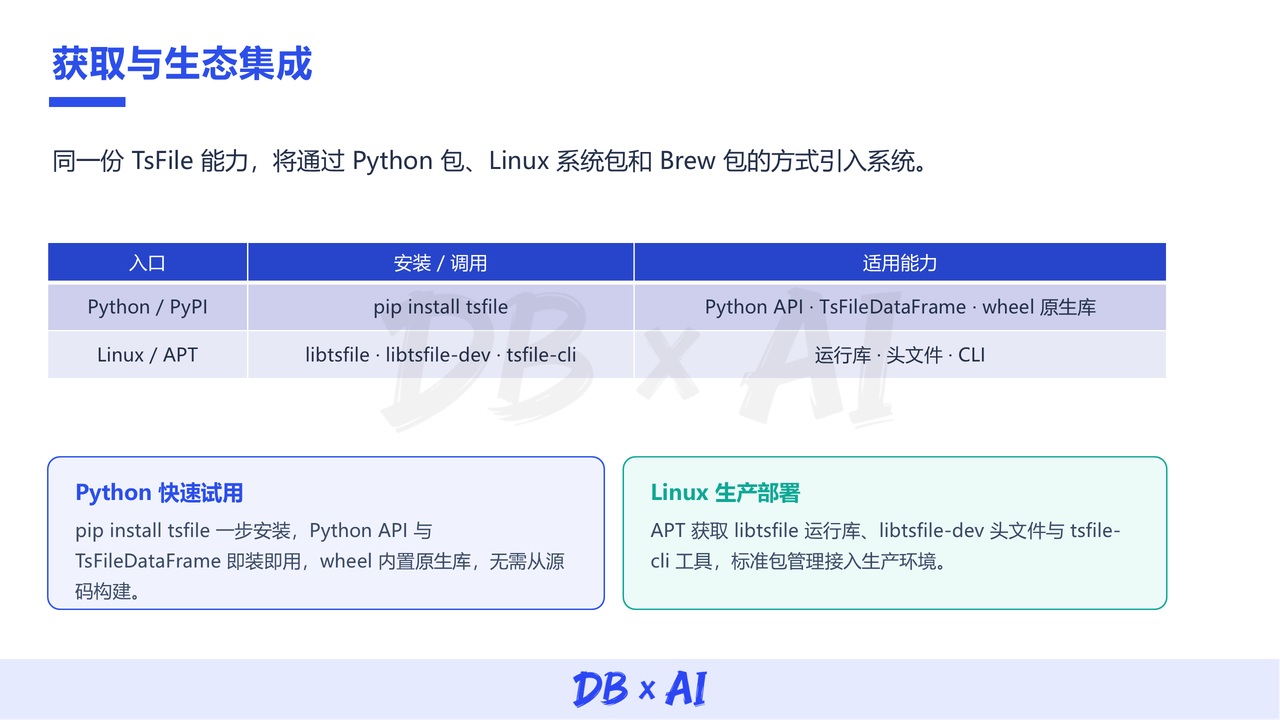
为了进一步降低使用门槛,我们还提供了多种软件分发渠道。Python 用户可以通过 PyPI 直接安装最新版本,在 Python 中调用 TsFile API、TsFileDataFrame 及相关原生库;Linux 用户则可以通过 APT 软件源安装 libtsfile。开发者可以进一步安装包含头文件的开发包,也可以安装 tsfile-cli,直接在本地使用 CLI 工具。通过这些生态集成和分发方式,我们希望让用户能够更加便捷地获取、使用和集成 TsFile。
随着时序大模型逐步走向工业场景,数据基础设施面临的要求也在发生变化。除了高效存储和压缩海量时序数据,还需要支持跨文件组织、随机窗口读取、多变量数据访问,并能够方便地融入模型训练和智能分析工具链。
Apache TsFile 正在围绕这些需求持续演进。从底层读写性能优化,到 TsFileDataFrame 提供统一的数据访问接口,再到 Hugging Face、DuckDB 以及 AI Agent 工具生态的集成,我们希望让时序数据不仅能够高效地存储下来,也能够更便捷地被发现、读取、分析和利用。
未来,TsFile 将继续立足开放的文件格式与工具生态,推动时序数据在采集、分析和 AI 训练等不同环节之间高效流转,为工业数据的智能化应用提供更加坚实的基础支撑。
最后,欢迎大家星标支持 TsFile
传送门:
https://github.com/apache/tsfile