


编者按:
8 月 22 日,2026 时序数据技术创新大会在北京成功举办,引发广泛关注。本次大会以「DB × AI」为主题,多位院士专家领衔,超 30 位嘉宾齐聚一堂,共同探讨数据库与人工智能融合发展的新趋势、新技术与新实践。
我们邀请到东南大学计算机科学与工程学院助理教授林丽带来以“通用时序大模型的应用探索”为题的主题演讲。她从时序大模型的基本范式和应用难点谈起,介绍了工业时序数据在流式特征、动态结构和时空融合方面的特点,并分析了预训练数据规模与模型开箱即用之间的差距。
演讲进一步分享了时序大模型面向工业场景进行适配的三类技术探索,包括持续学习、基于提示词的时空建模,以及面向异步采样和数据缺失的不规则时序建模,为希望提升时序预测与异常检测能力、探索时序大模型落地应用的企业提供了实践参考。
全文约 6 千字,阅读约需 10 分钟,以下是演讲主要内容:
为什么时序预测难以在工业场景“开箱即用”?
林丽教授介绍,时序大模型通常被称为 TSFM(Time Series Foundation Model),即“时序基础模型”。
围绕时序大模型的特点,以及如何以较低成本应用这类模型,她总结了当前时序大模型的两种主要范式:跨模态重用和原生时序大模型。
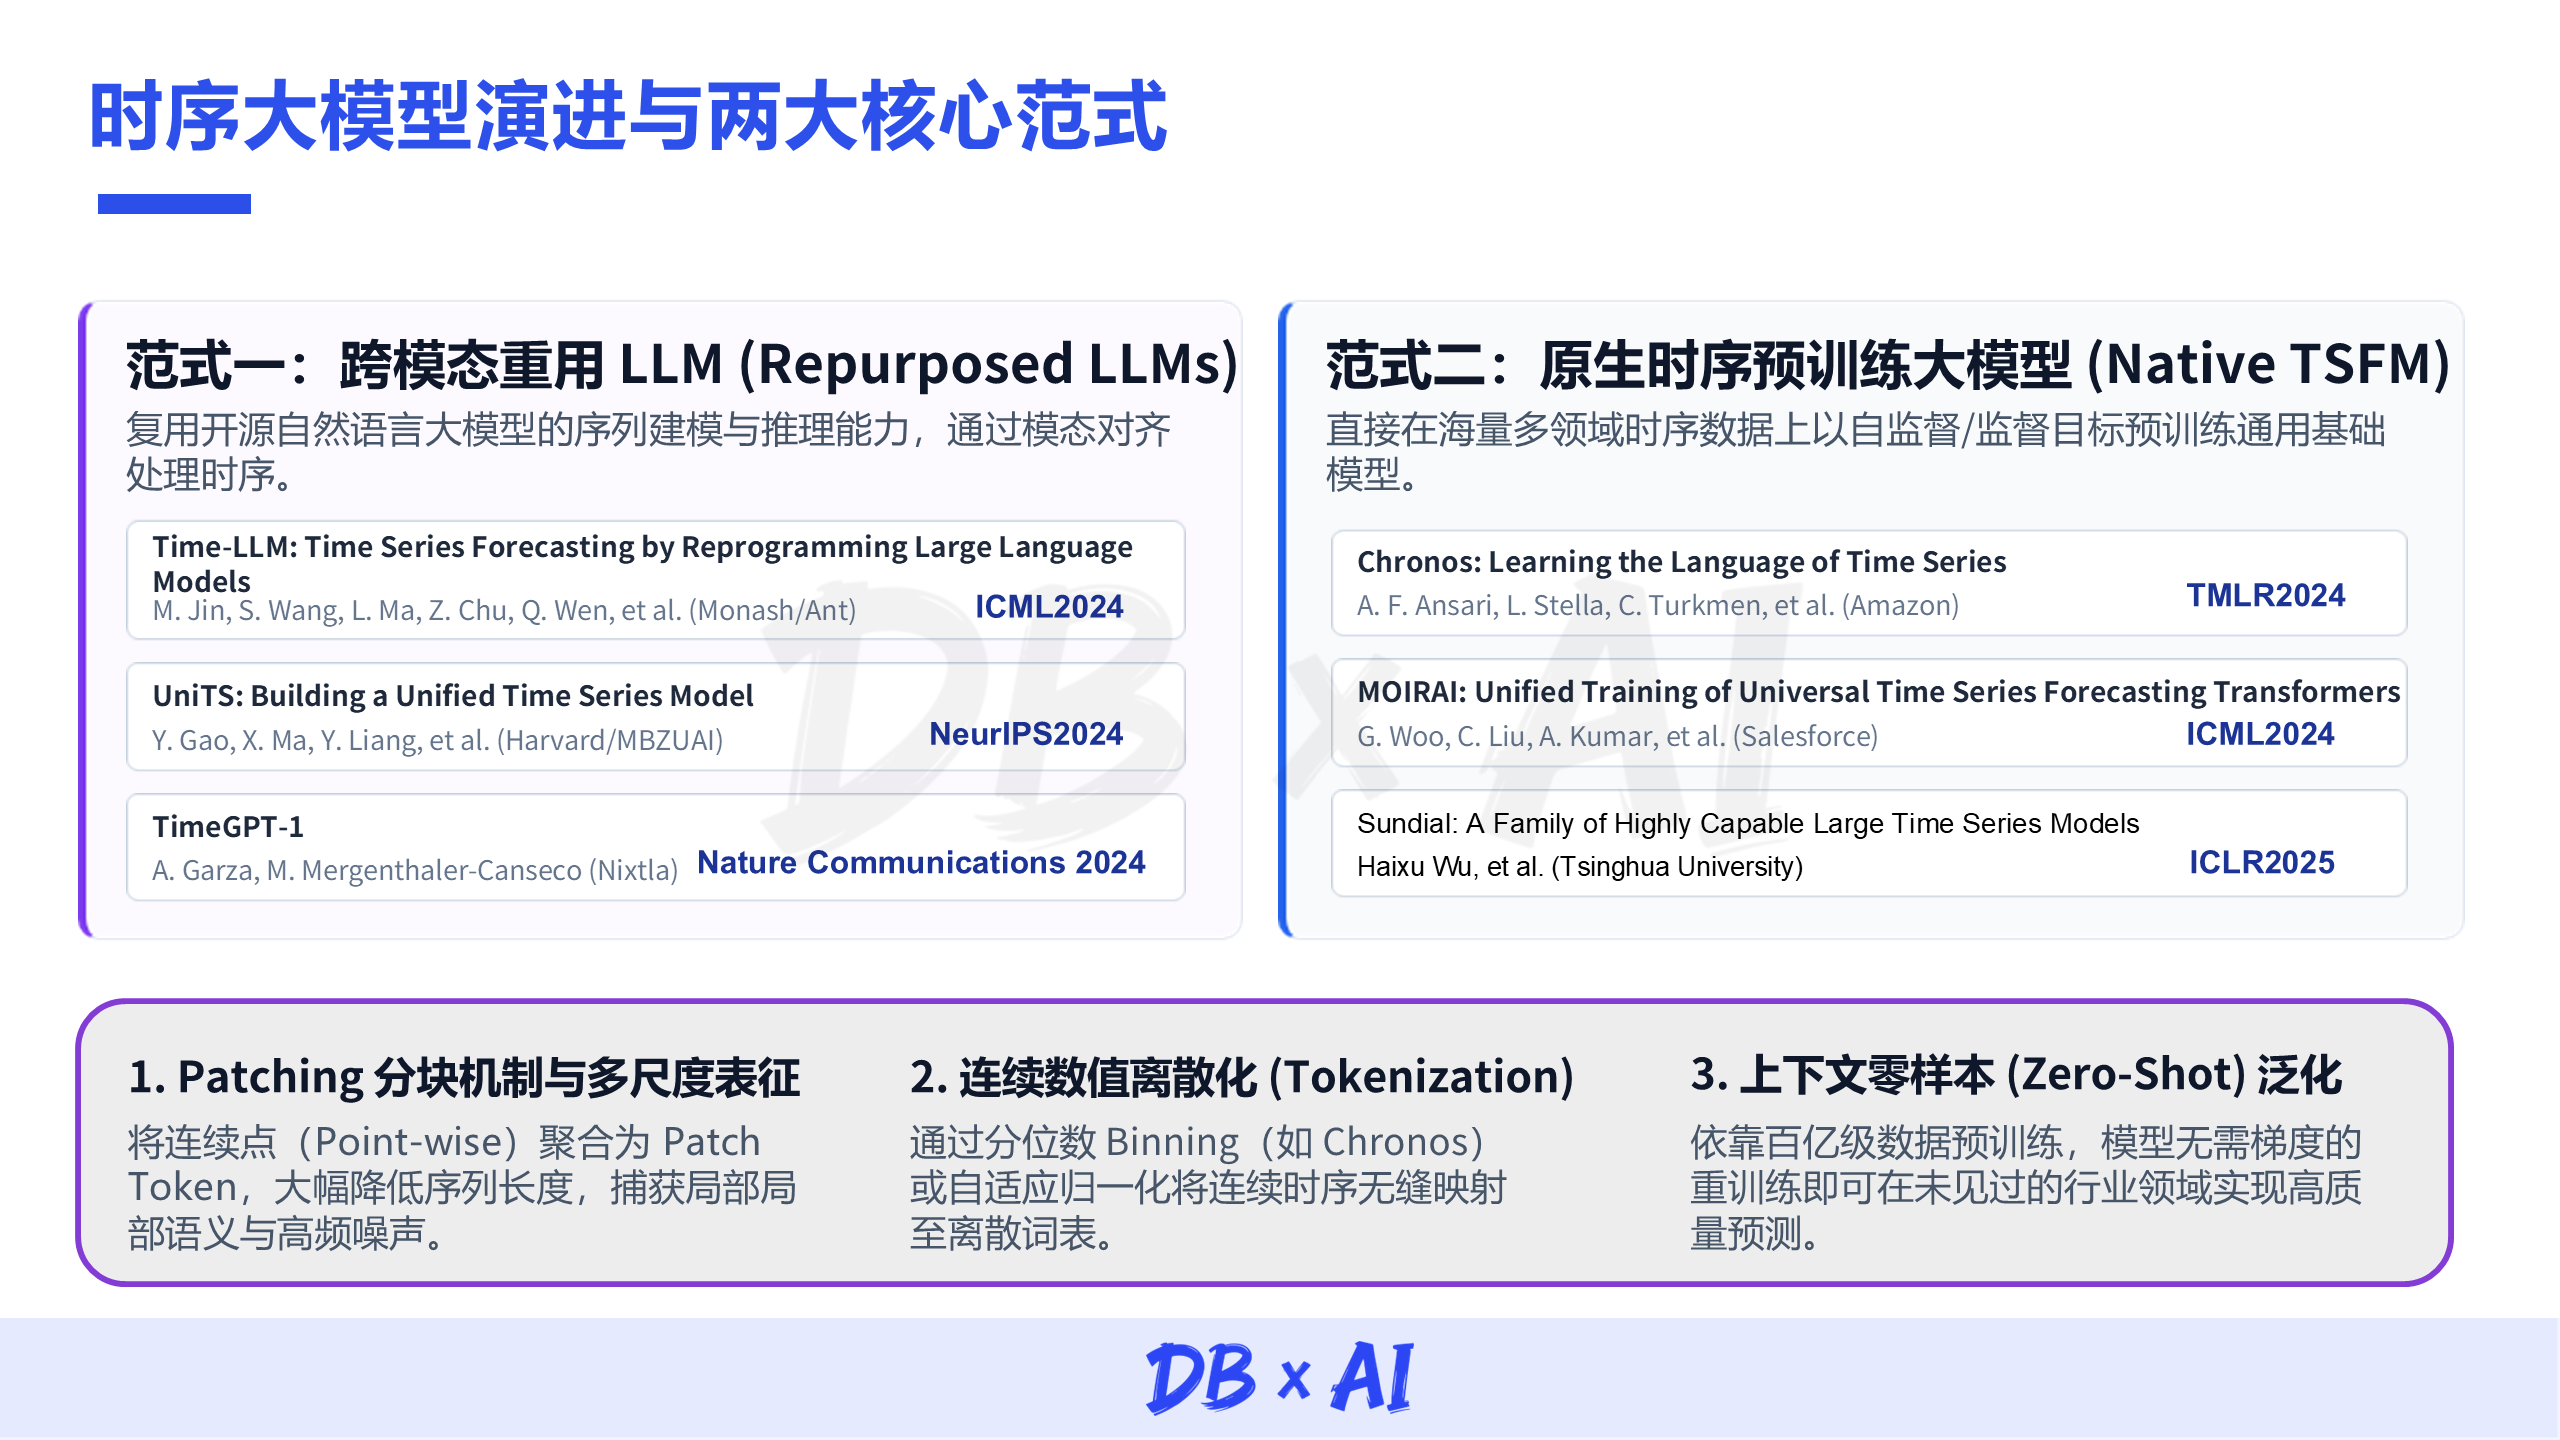
跨模态复用是指利用已有大语言模型的序列建模和推理能力,通过模态对齐等方式,将其应用于时序分析、预测等任务。
在部分方法中,需要借助自然语言描述时序数据的特征和变化规律。例如,专家在分析经济数据时,可以通过文字说明当前经济水平、历年同比或环比变化等信息,再引导大语言模型预测未来趋势。此外,也有研究通过专门的编码和模态对齐机制,使语言模型能够直接处理经过转换的时序特征,而不完全依赖人工编写的文本描述。
不过,由于语言大模型最初并非针对连续数值序列设计,在将其应用于时序数据处理时,需要人工将数学关系加工为文本。对于工业场景中高频、实时的时序分析任务,这类方法仍然面临一定挑战。
由此产生了第二种范式,即原生时序预训练大模型,也称为 Native TSFM。这类模型不依赖预训练语言模型的文本生成能力,而是直接使用海量、多领域的时序数据集,通过自监督学习或特定监督目标进行训练。自监督学习不依赖人工标注,而是让模型通过预测未来数值等任务,学习时序数据的变化规律;监督学习则可结合人工标注,增强模型对特定任务的处理能力,例如异常工况检测、异常点识别等。
目前,较为常见的原生时序大模型包括 Chronos、Moirai 和 Timer 系列。
林丽进一步介绍,无论采用跨模态复用还是原生时序基础模型,在模型设计与实际应用中,都有几个值得关注的技术问题:
1.时序数据的分块与多尺度表征:分块(Patching)和多尺度表征等方法,可以帮助模型降低长序列处理成本,并提取不同时间尺度上的变化特征;
2.连续数值的离散化:由于多数模型基于 Transformer 架构,而原始时序数据属于连续的实值数据,因此需要对连续数值进行适当的离散化或表征转换。离散化效果会直接影响模型的时序预测能力;
3.零样本泛化:理想情况下,时序大模型在百亿级数据上完成预训练后,应当能够开箱即用,在面对未见过的新场景时,无需针对该场景重新训练或微调,仅利用输入的历史观测数据即可开展预测。
林丽指出,尽管时序数据的表征和编码技术已经取得了不少进展,但如何进一步提升模型在新场景下的零样本泛化能力,仍然是通用时序大模型面临的重要挑战。
以海上风机支撑结构的工况预测为例介绍,直接使用 Timer 2.0 进行零样本预测时,预测精度可以达到 70% 以上,但仍难以满足工业应用要求。在引入海上风、浪、流等环境观测数据作为协变量,并使用一个月的工况数据进行小样本微调后,模型预测误差可以进一步降至 10% 以内。这表明,尽管通用时序基础模型已经具备一定的零样本预测能力,但面对专业工业场景,结合领域数据和具体任务开展针对性适配,仍然具有重要价值。
工业时序数据的共同特征:流式数据、结构关联与时空融合
林丽总结,时序大模型落地主要可以分为四类任务:预测、分类、异常检测和生成。
时序大模型任务在不同领域具有不同的业务含义。例如,在新能源领域,可以预测发电量并辅助负荷调度;在量化金融领域,可以用于风险控制;在预测性维护场景中,可以将传感器的健康状态、设备或部件的剩余使用寿命作为预测目标;在供应链网络鲁棒性评估中,则可以分析城市级或全国级供应链网络的稳定性,并为相关决策提供支持。
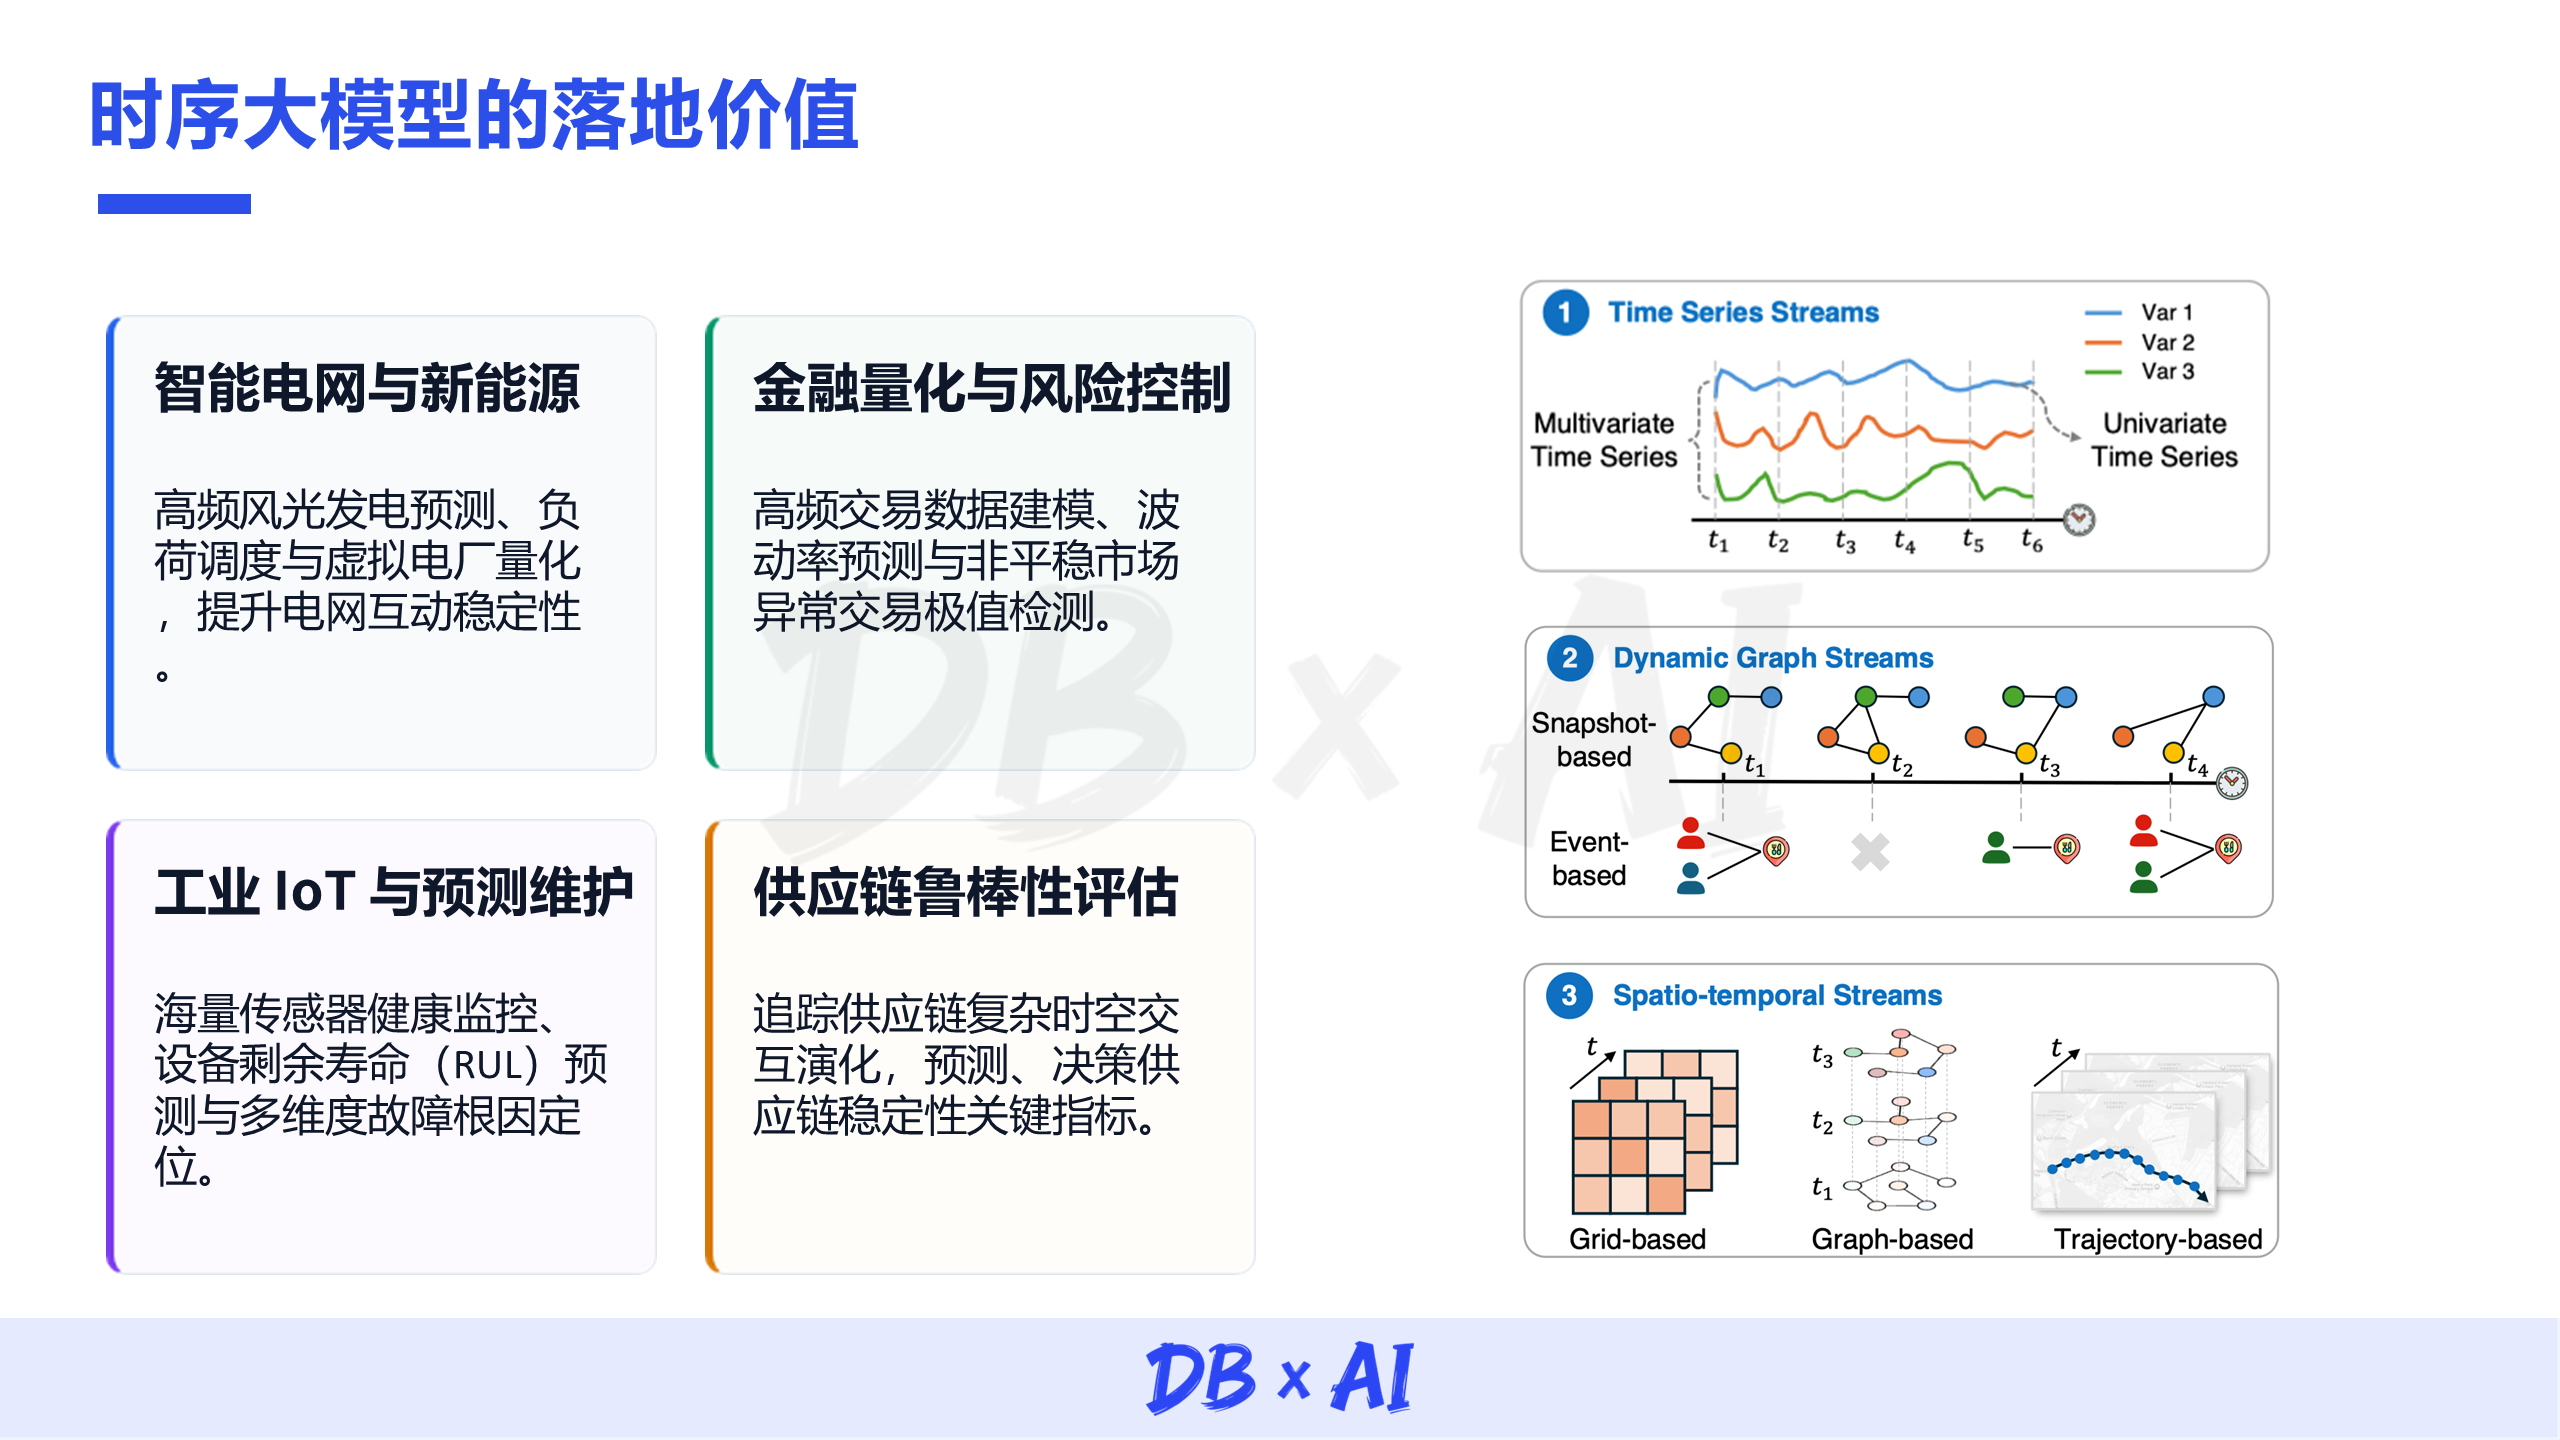
尽管应用场景各不相同,工业时序数据通常具有三个共同特征。
第一,工业时序数据往往具有多变量和流式采集的特点。在大多数工业场景中,需要同时记录多个传感器点位的数据,这些点位之间往往存在物理机理上的关联。与此同时,每个点位的数据又会随着时间持续变化。因此,工业时序分析既要理解单个点位的时间演变,也要关注多个变量之间的相互影响。
第二,时序数据往往存在空间或结构关联。 这些关联可能来自设备之间的物理连接、传感器的部署位置,也可能来自地理空间关系或业务网络结构。例如,在分析北京与南京的城市供应链时,需要考虑两地在地理位置和社会环境等方面的差异;在分析海上风机支撑结构的响应时,则需要考虑应变片的部署位置,以及不同应变片之间的关联。这些结构关系可能相对稳定,也可能随着时间发生变化,对理解和预测时序数据具有重要作用。
第三,时序数据往往具有时空融合特征。如果将数据随时间演变产生的分布变化,与不同采集点位所包含的背景知识结合起来,大量工业数据都可以被纳入“时空流数据”的范畴。因此,分析工业时序数据不能只关注时间维度的变化,还需要结合空间位置、点位关系和业务背景,理解数据背后的整体运行状态。
预训练数据集的发展:跨领域、数据增广与质量治理
林丽介绍,现有时序大模型通常需要在大规模、多领域的时序数据集上进行预训练。然而,即使使用海量数据进行预训练,模型仍然很难在新的工业场景中直接实现开箱即用。要理解这一问题,需要先分析预训练数据集的构成及其特点。
目前,常见的时序模型预训练数据集包括 LOTSA、Monash 和 UCR 等。其中,LOTSA 数据集包含约 270 亿个观测值,覆盖多个领域,是目前规模较大的开放时序数据集之一;UCR 数据集则包含不同类别的标签,是时序分类任务中常用的标准基准数据集。
除此之外,还有大量来自金融、医疗、电力和能源等特定领域的数据集。例如,电力领域的 ECL 数据集主要记录用电负荷,ETT 数据集则包含电力变压器温度等运行数据。这些数据集也被广泛用于时序模型的预训练和能力评估。
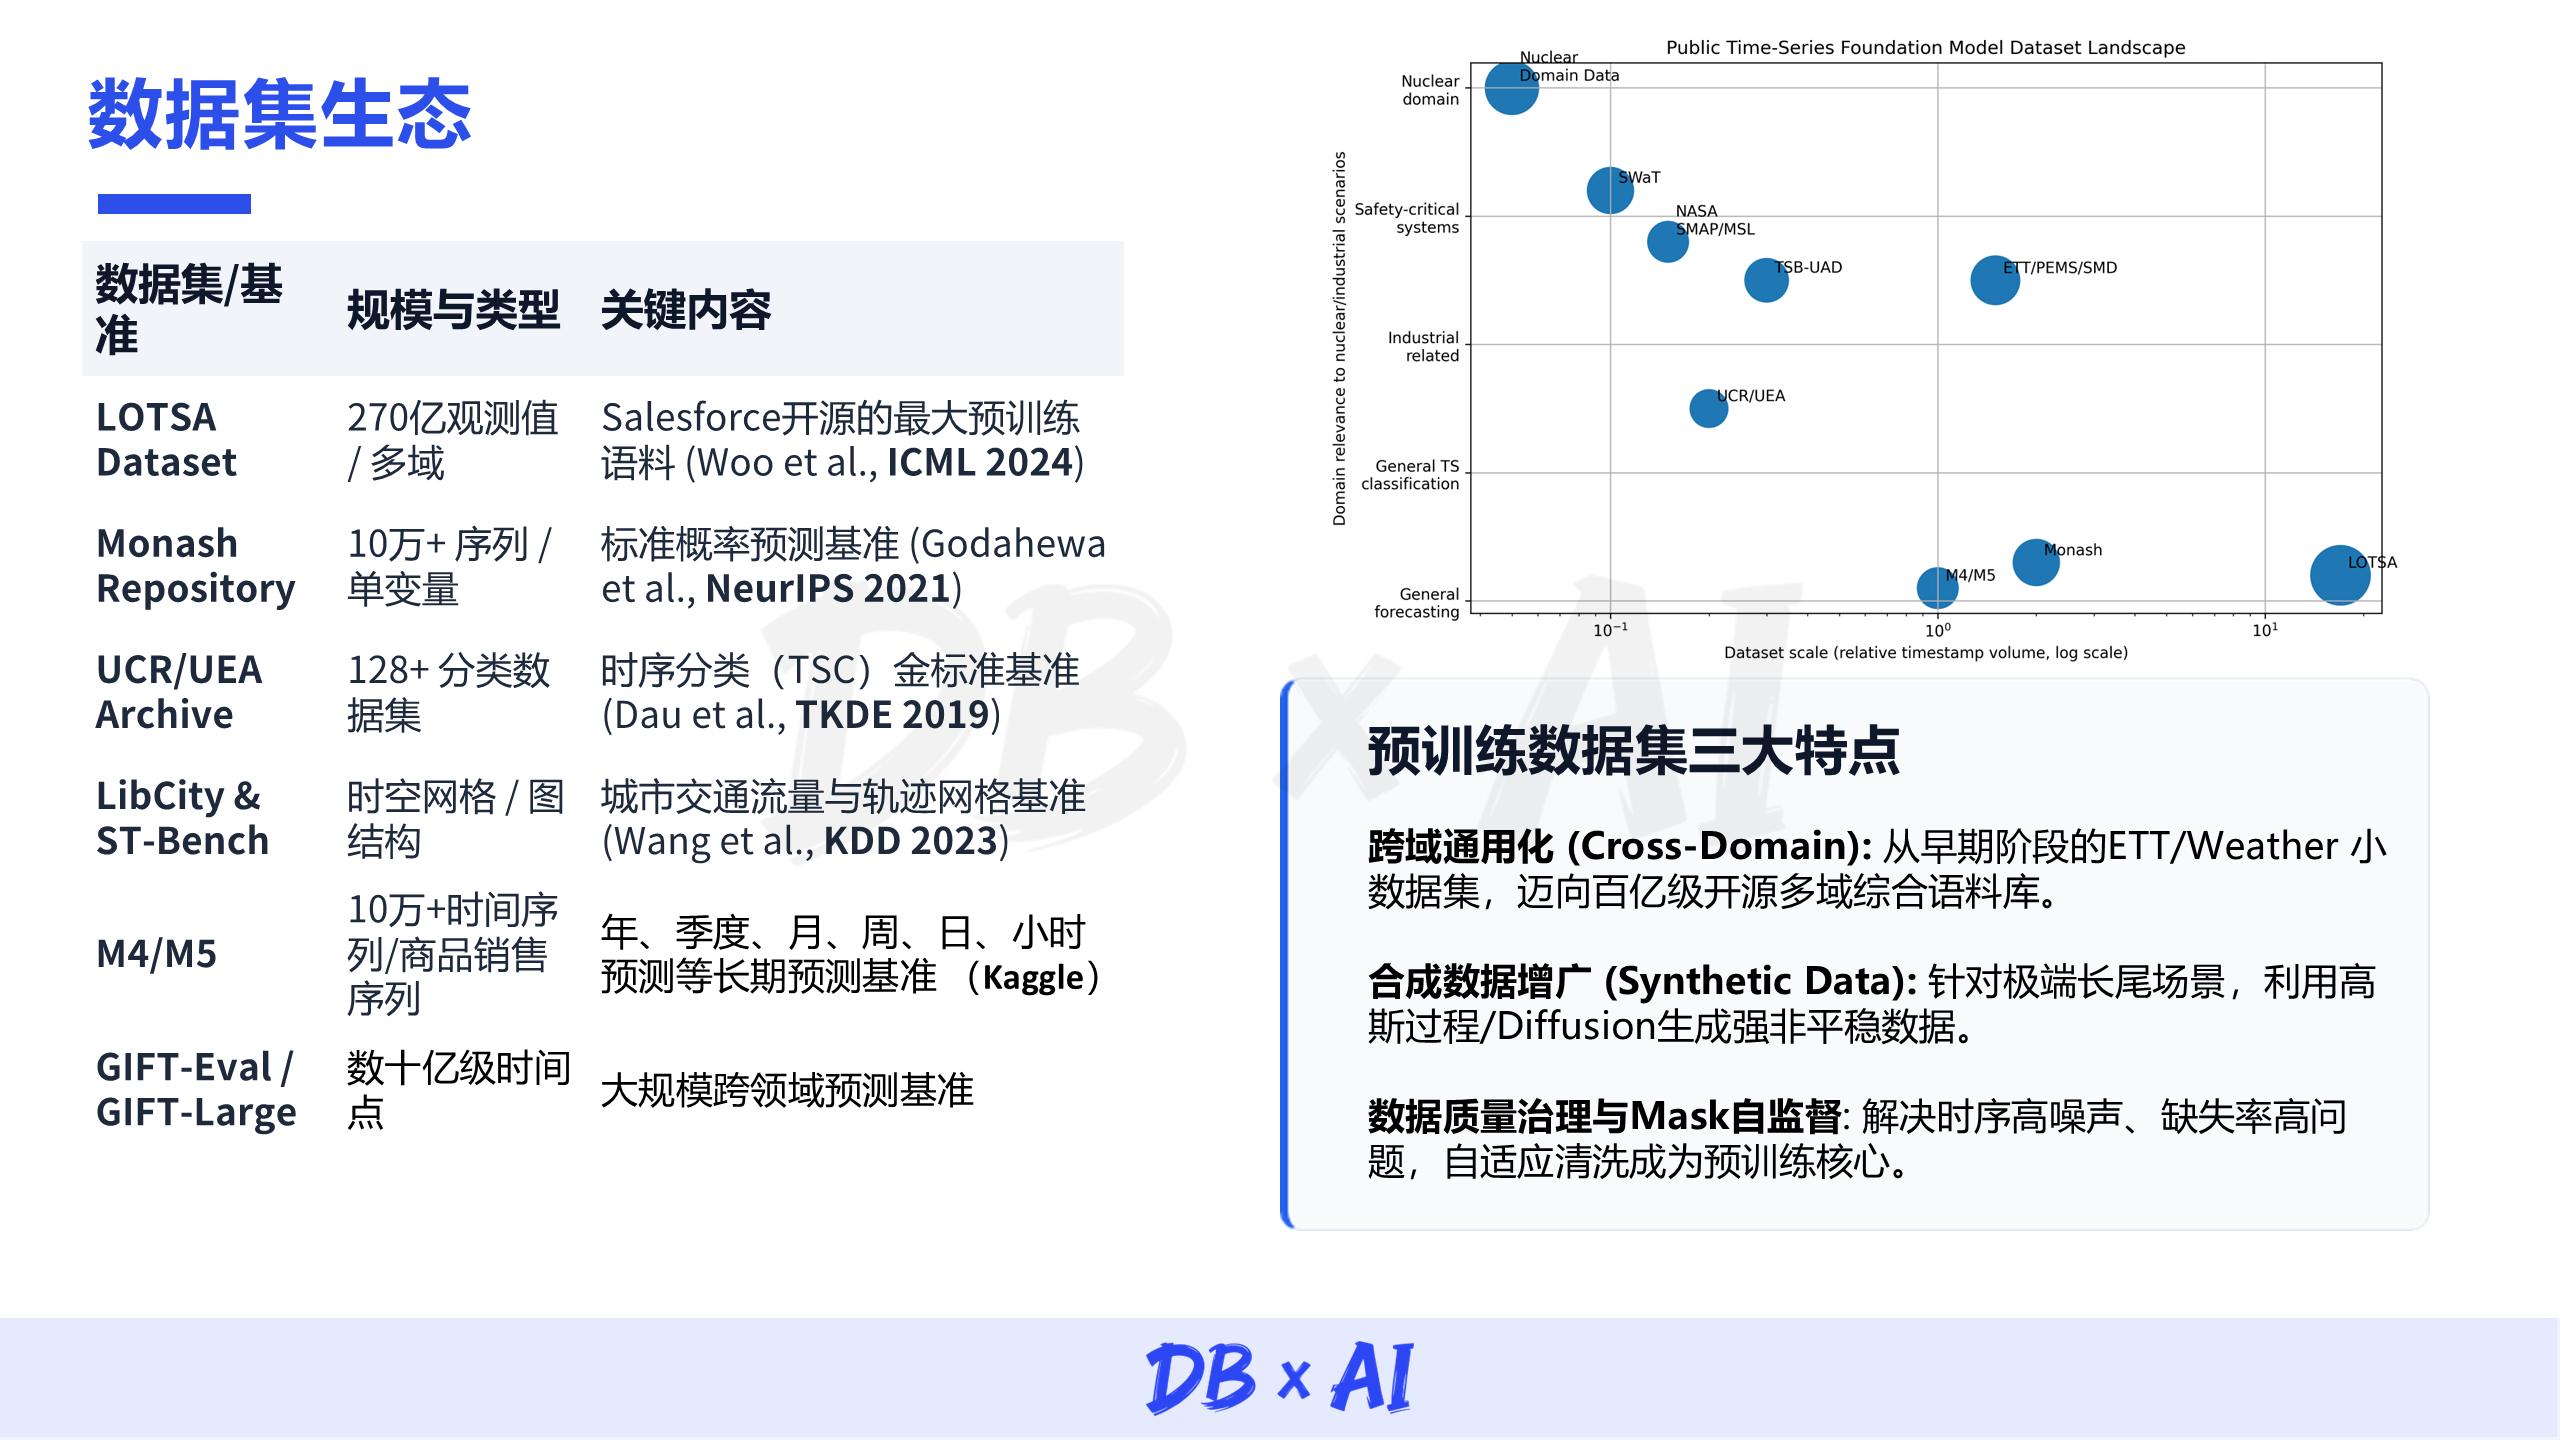
尽管时序模型的训练数据规模不断扩大、覆盖领域持续增加,但现有数据资源仍然难以充分覆盖真实工业场景的复杂性。例如,部分关键工况样本稀缺,不同领域的数据分布存在明显差异,一些数据还伴随着噪声、缺失或采样不规则等问题。
此外,实际应用场景与预训练任务之间也可能存在差异。这些因素共同影响着通用时序模型在新场景下的泛化效果。为提升模型的通用能力,近年来,时序模型的预训练数据及相关技术呈现出以下几个发展特点。
第一,推动训练数据跨领域通用化。越来越多的预训练数据集不再局限于单一领域,而是汇集来自不同领域的时序数据,使模型能够学习更具通用性的时序变化规律,提升其面向新领域和新场景的泛化能力。
第二,通过合成数据进行增广。在时序分类和异常检测任务中,极端、罕见工况的真实样本通常十分有限,有些极端工况的数据量可能只占全部工况的十万分之一,要从海量数据中识别并标注这些异常样本十分困难。为了让模型充分学习罕见工况的特征,可以通过数据合成模拟异常工况,提高相关样本在训练数据集中的比例。
第三,加强数据质量治理和掩码自监督学习。工业时序数据在采集过程中普遍存在噪声较大、缺失率较高等问题,需要通过数据质量治理提高训练数据的可靠性。此外,还可以采用掩码自监督学习(Masked Self-Supervised Learning),在训练阶段主动遮蔽部分已知观测值,让模型根据剩余数据学习恢复缺失信息,从而提高模型对时序上下文和变量关联的理解能力,并为缺失数据处理提供支持。
除了不断扩大预训练数据规模、提升数据质量,如何让已经训练好的通用模型适应不断变化的真实场景,同样是重要的研究问题。
围绕这一方向,林丽重点介绍了团队在持续学习、时空建模和不规则时序建模方面的探索。
时序大模型应用技术探索:持续学习、时空建模、不规则时序建模
林丽进一步介绍了时序大模型在实际应用中的技术探索,重点包括三个方面:持续学习、时空建模和不规则时序建模。
1.持续学习:以低成本适应数据分布变化
工业时序数据往往具有非平稳特征,其统计分布和变化规律可能随着时间、环境或设备运行状态而发生改变。对于这类数据,仅依赖一次离线训练的固定模型,可能难以长期保持稳定的预测效果。
举例来说,在实际应用中,在广州场站训练完成的模型,通常很难直接迁移到成都场站使用,模型效果也难以得到保证。因此,面对不同时间、不同地点产生的数据,如何减少模型更新所需的数据量,成为时序大模型应用中的重要问题。
林丽指出,时序大模型在持续适应新场景的过程中,主要面临三个方面的挑战:模型更新成本较高、数据分布持续变化,以及学习新数据时可能遗忘已有知识,即所谓的“灾难性遗忘”。
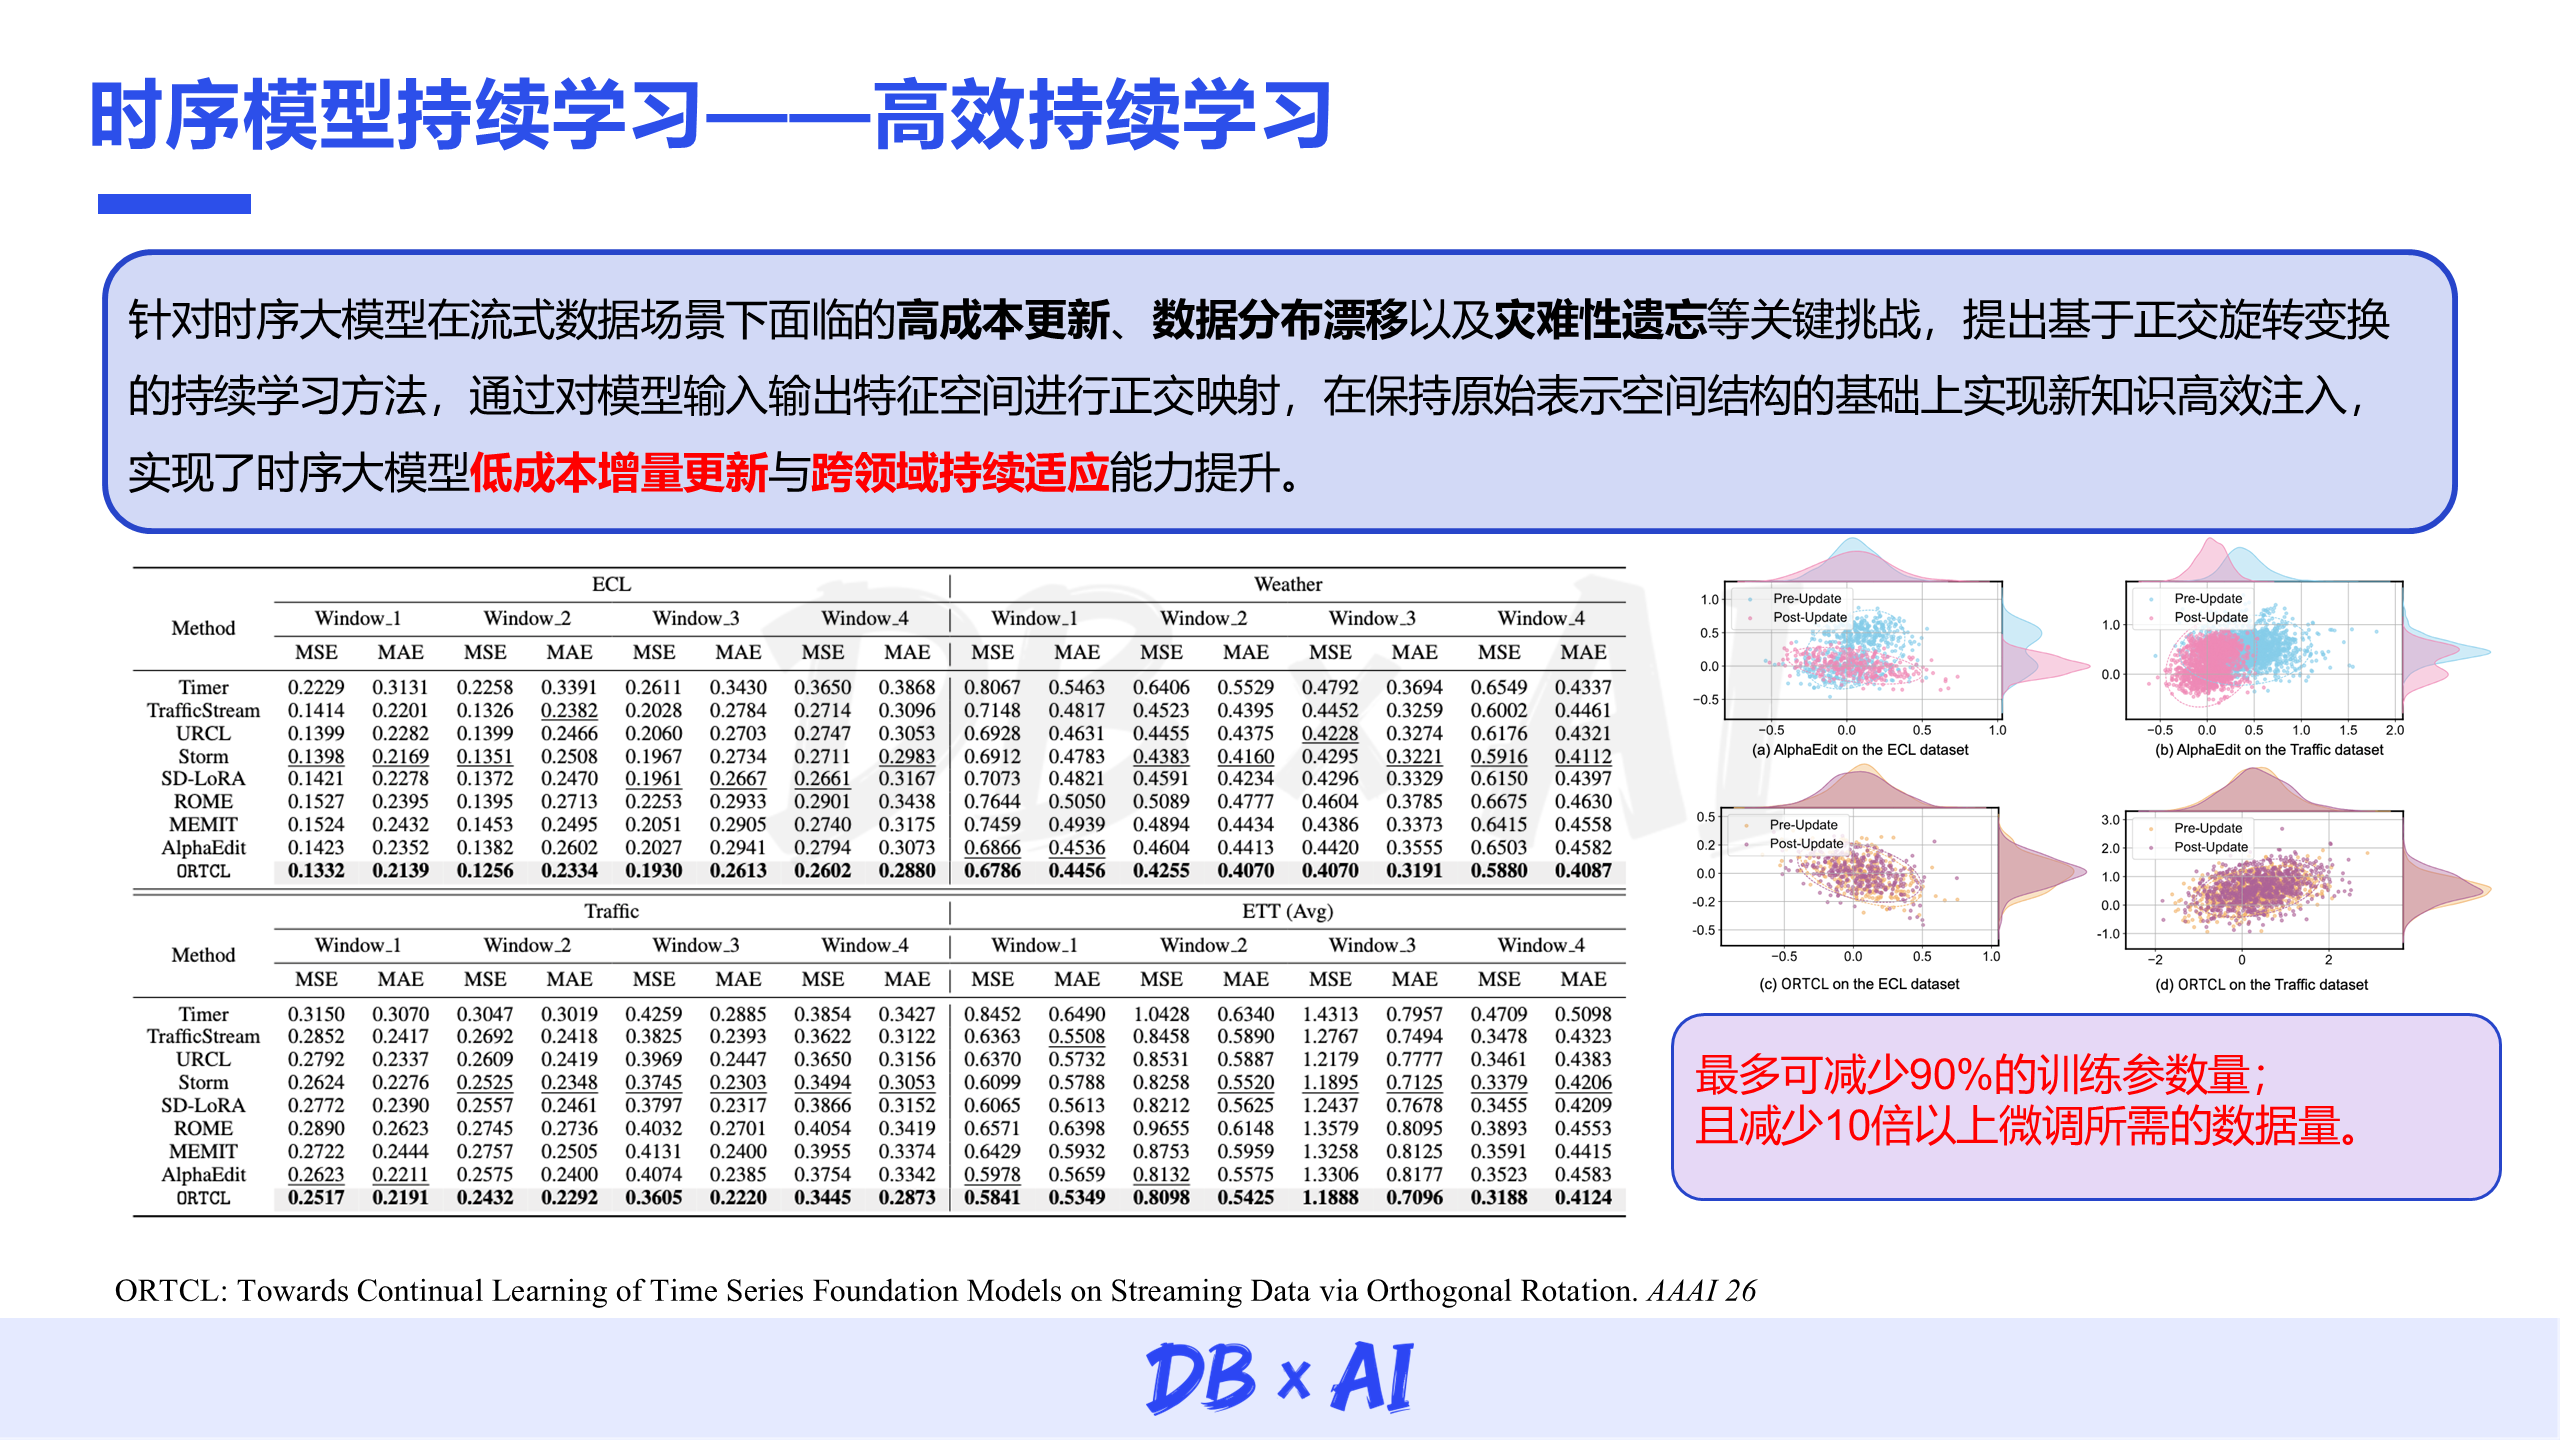
针对这些问题,团队提出了基于正交旋转变换的持续学习方法 ORTCL。该方法的核心思路是尽可能保留模型在预训练阶段学到的共性知识,同时降低新场景适配所需的参数更新成本。
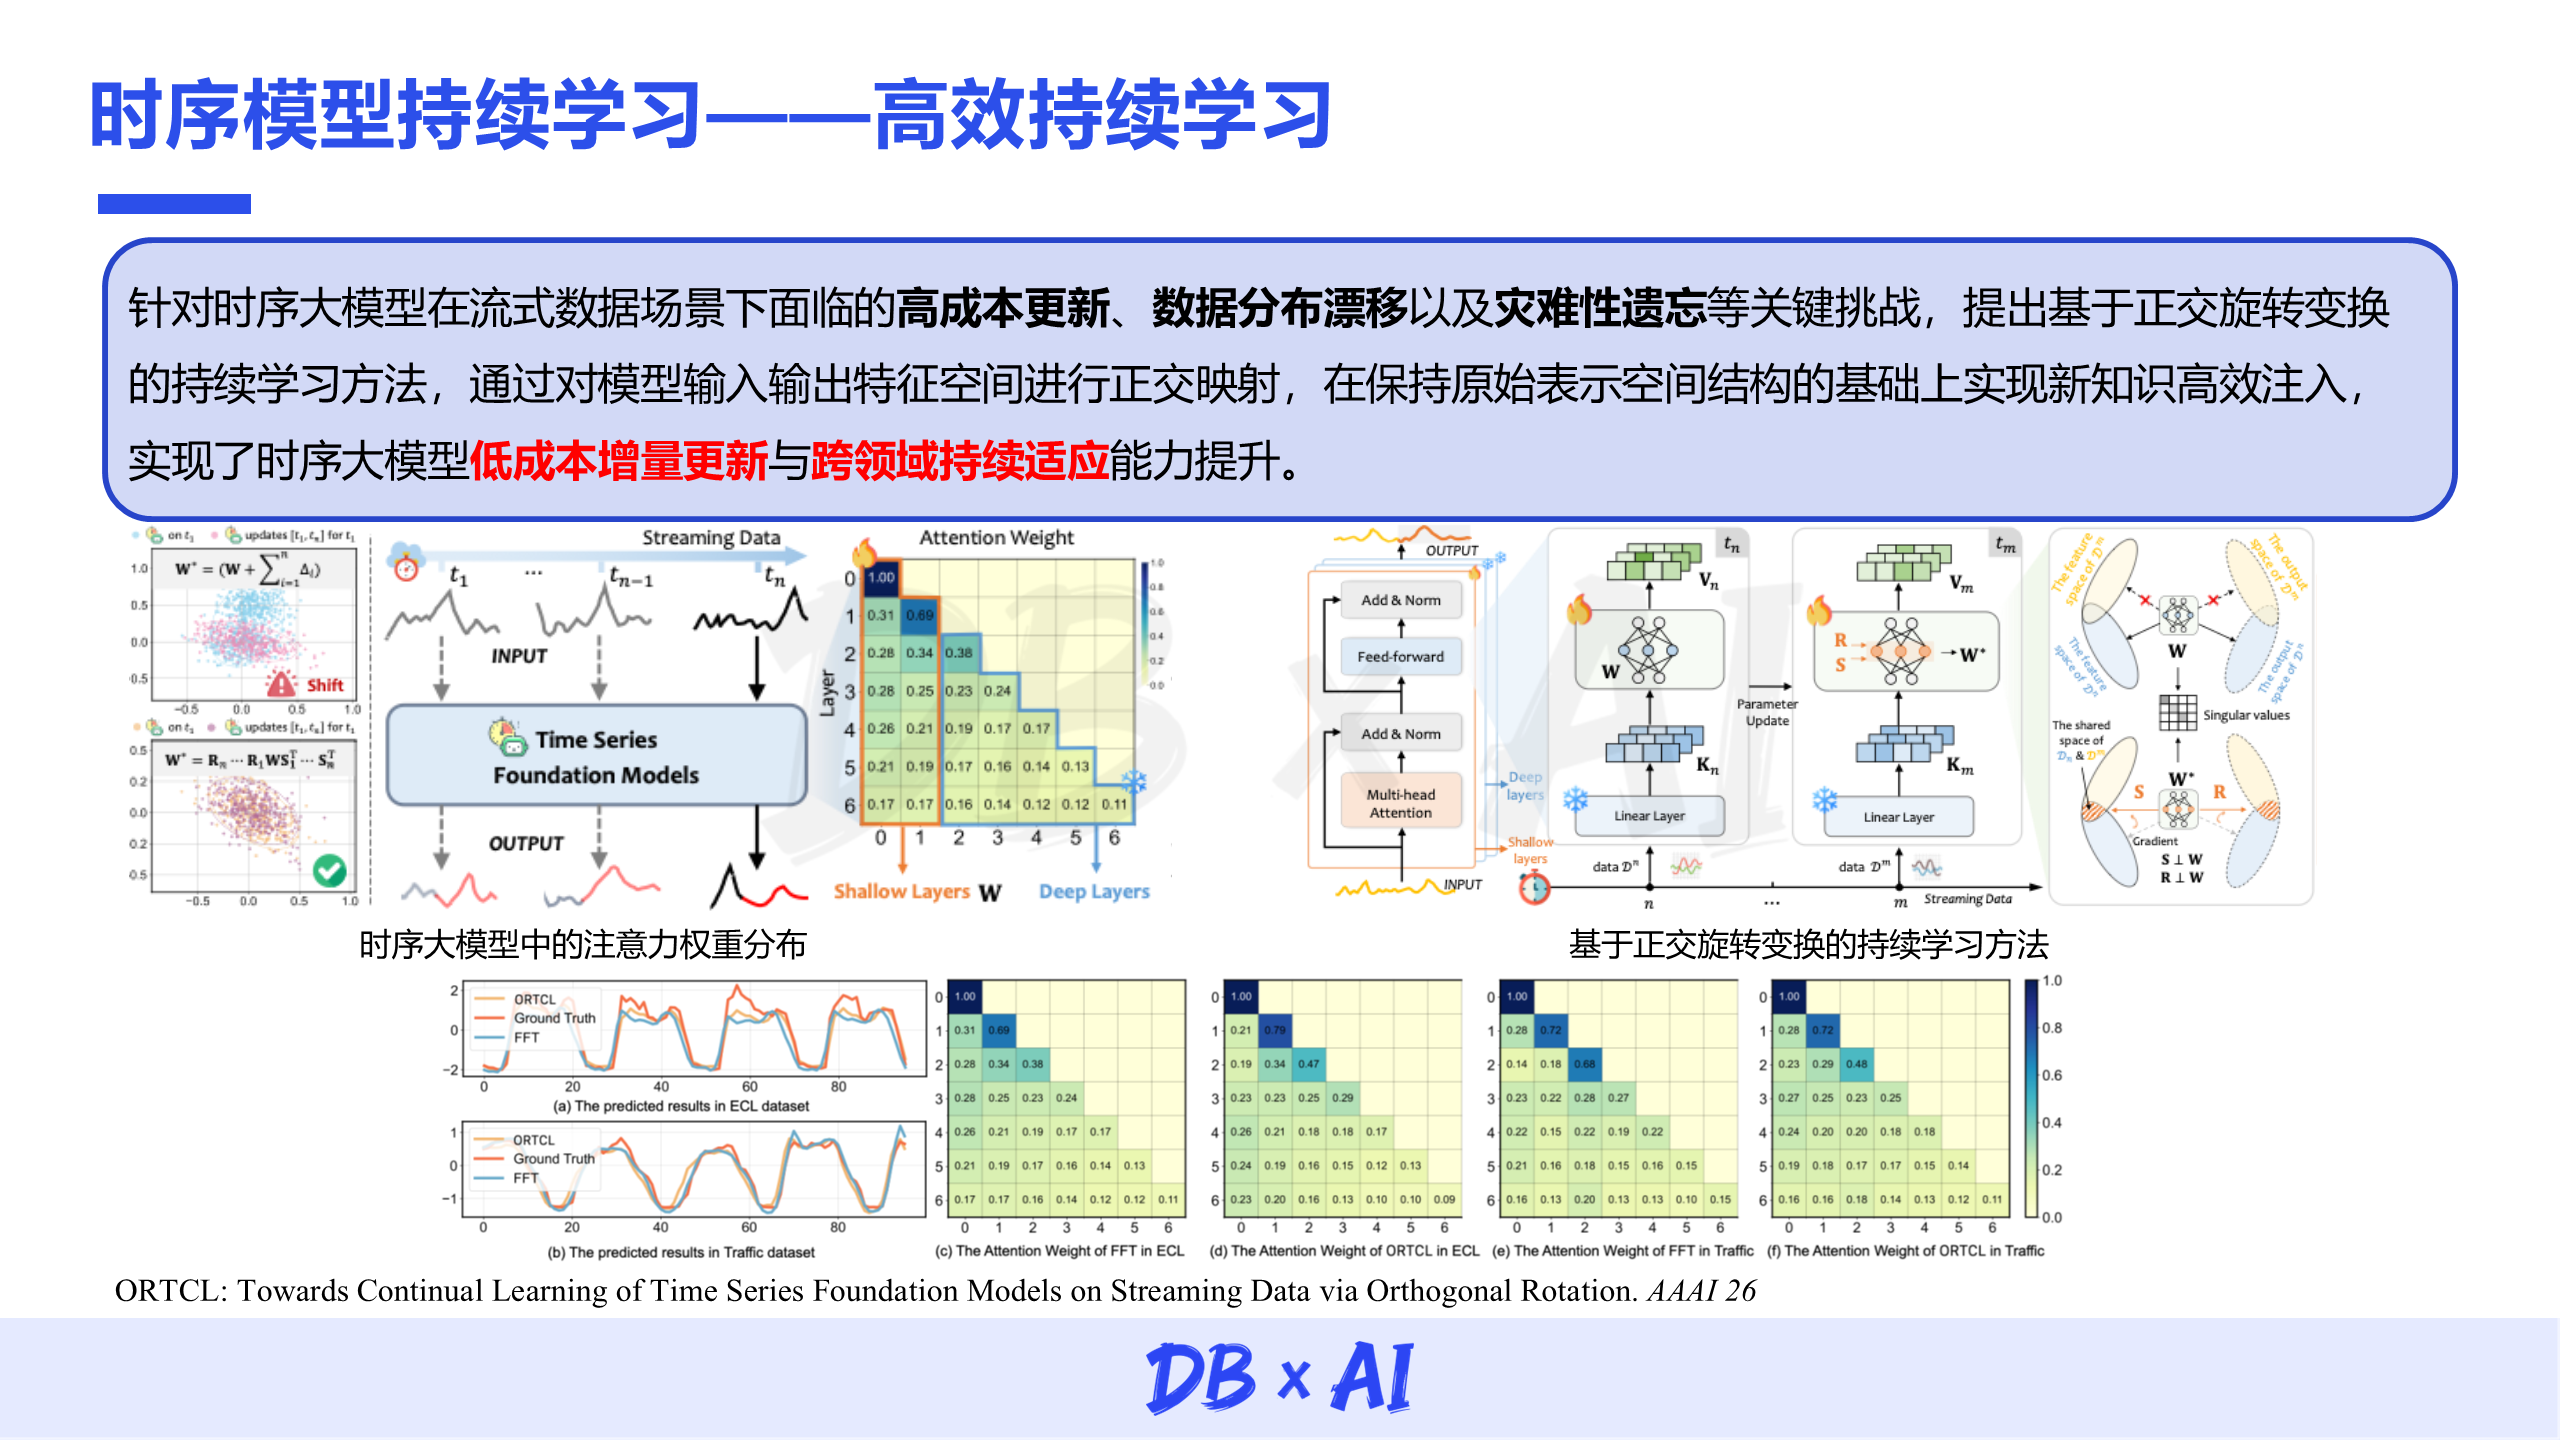
实验结果发现,该方法能够在尽可能保留数据共性特征的基础上,将待更新参数量减少约 90%,并将微调所需的数据量减少 10 倍以上。更新参数量的减少,意味着能大幅压缩实际生产环境中数据采集环节的时间,以一个包含 200M 参数的时序大模型为例,传统方法可能需要准备 10 万个以上的时序数据点,采集这个体量的数据往往耗时一个季度甚至更长时间。
除了数据随时间发生的分布变化,工业设备更新、传感器更换以及采集点位调整等情况,还可能改变数据的变量组成和空间关联关系,为模型持续学习带来新的挑战。例如,即使新旧设备用于监测同一类工况,其传感器数量、安装位置和采集的物理量也可能存在差异。如何尽可能复用原有数据和模型知识,而不是完全重新训练,成为另一个值得研究的问题。
针对这类问题,可以采用时空校准持续学习方法,在时间校准的基础上增加空间校准。当两个数据集的采集点数量不同,甚至部分物理量的含义也不完全一致时,该方法能够尽可能建立两个数据集之间的知识关联,减少模型需要更新的参数量,从而提升模型对新场景的适应能力。
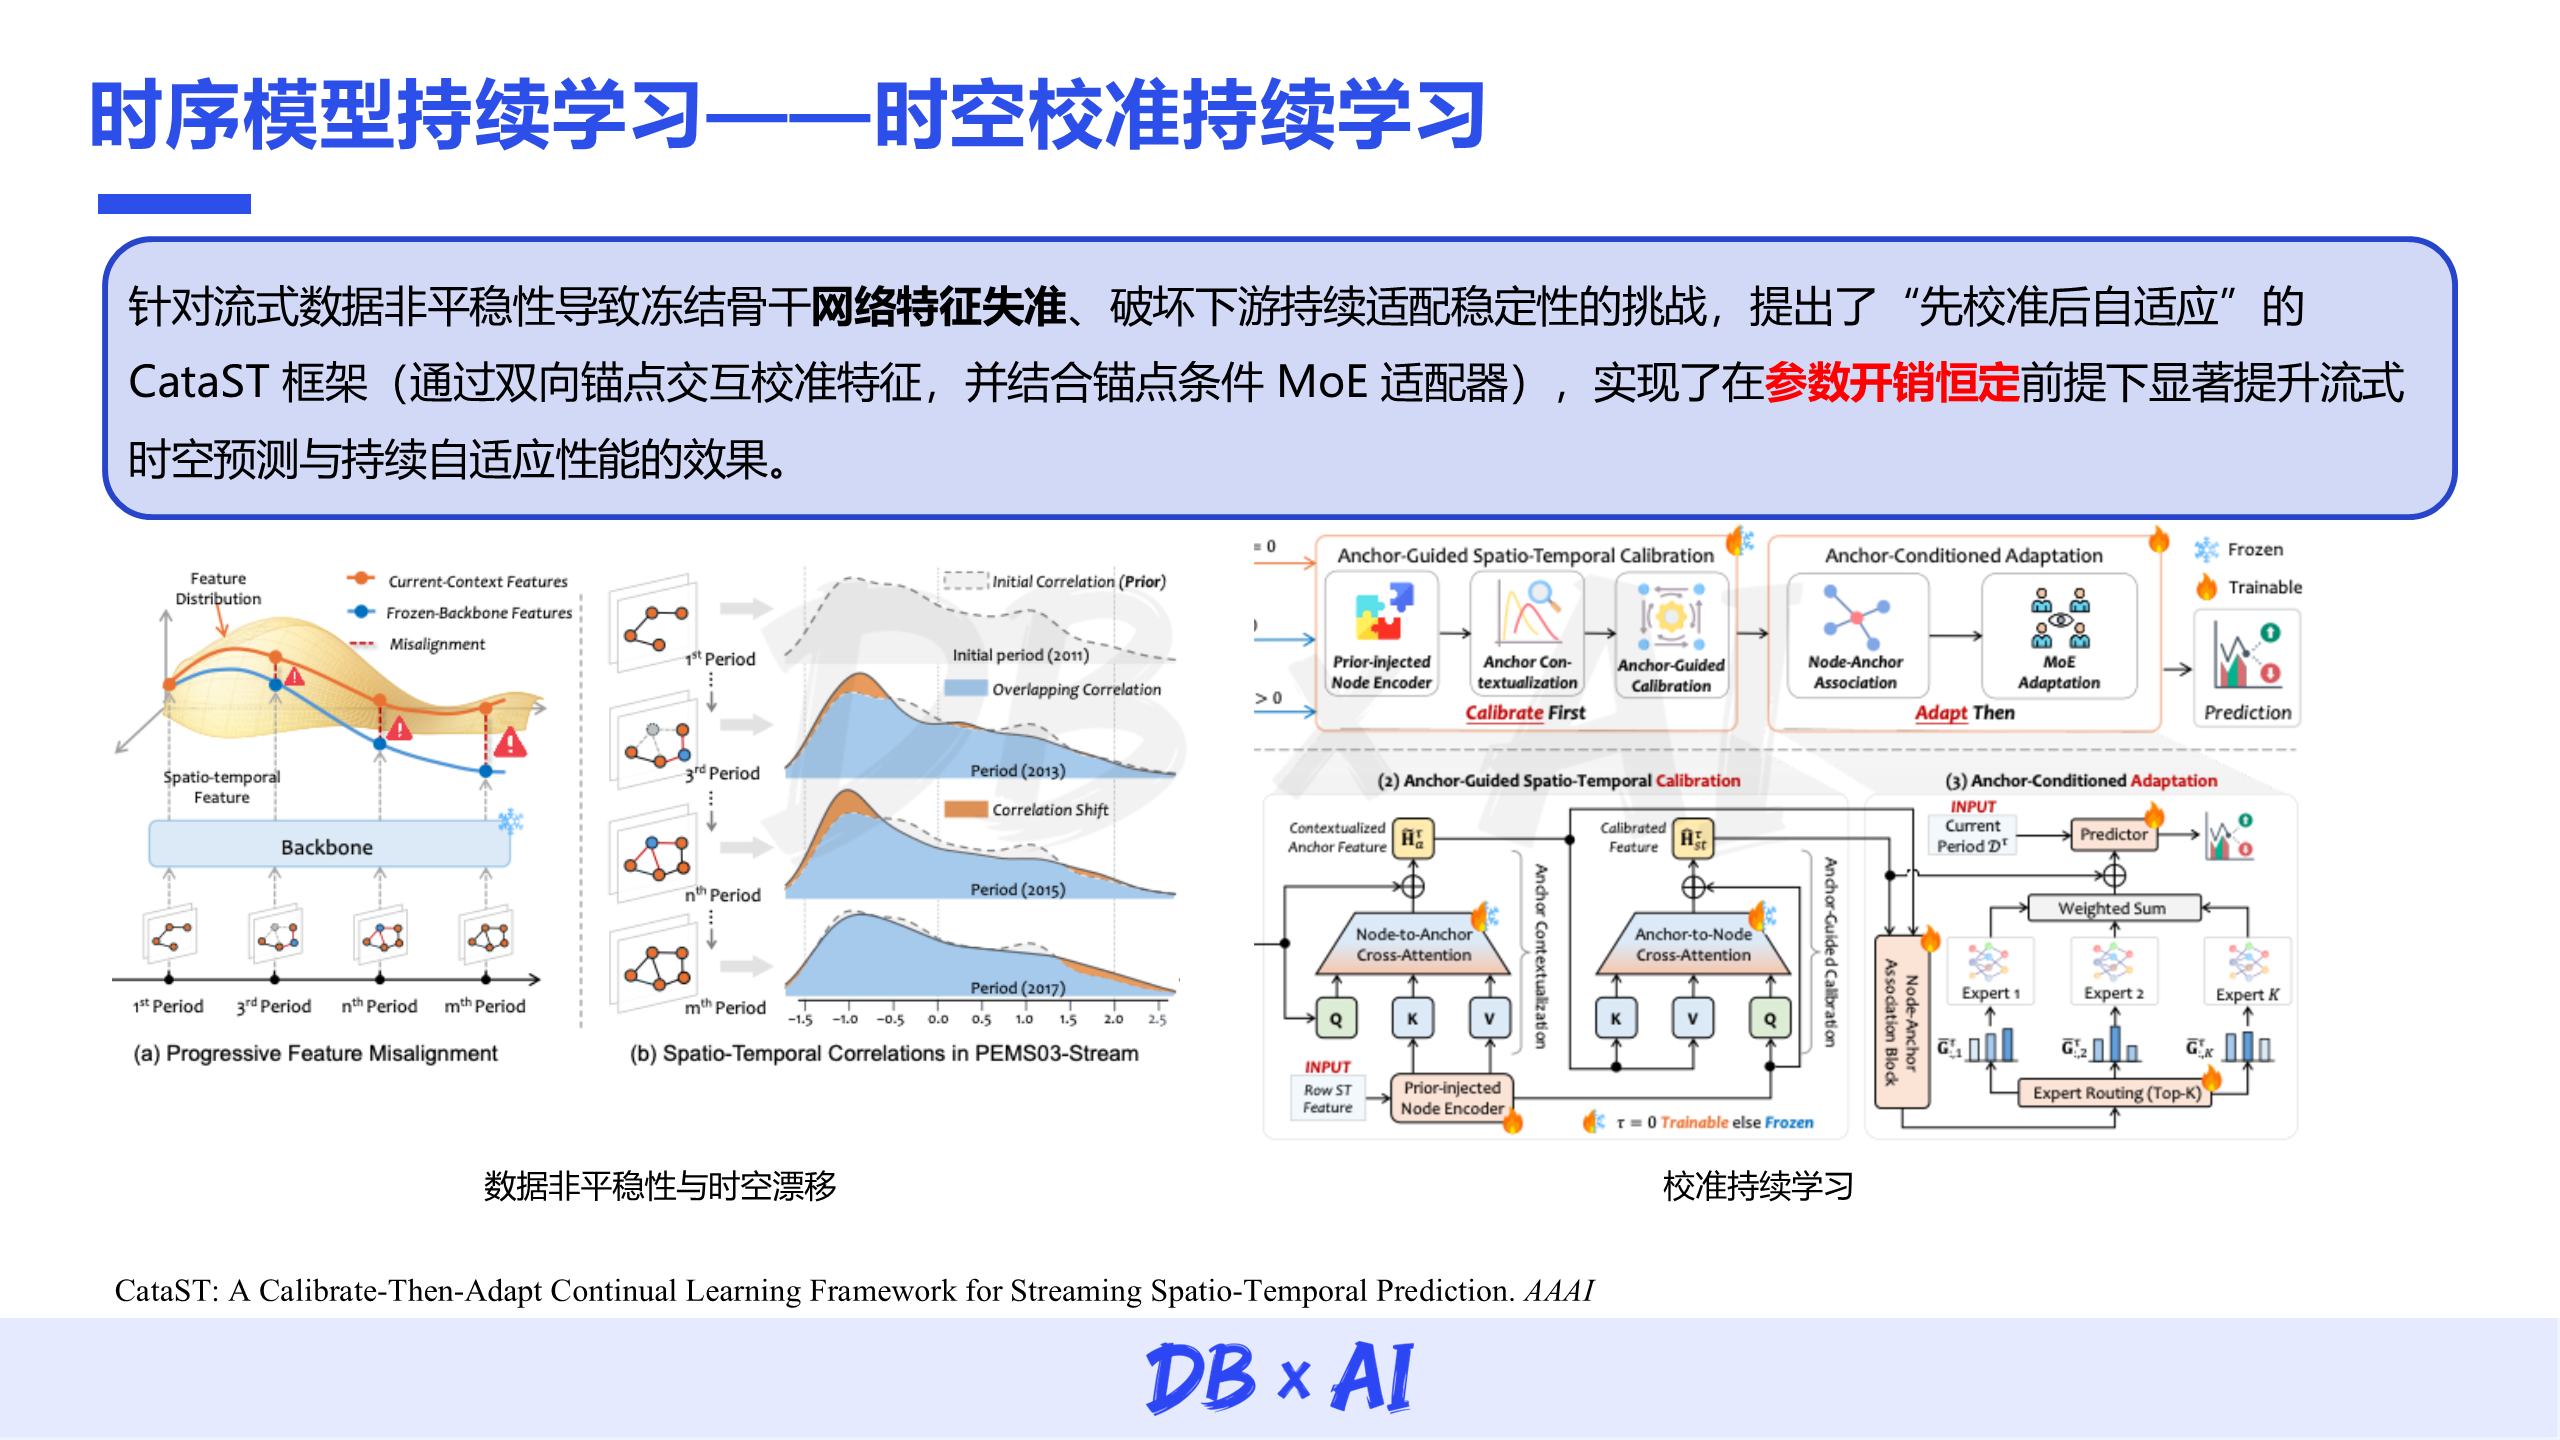
与增量微调相比,时空校准持续学习不需要为每个新场景额外增加参数(参数开销恒定)。而传统增量微调则通常是在原有模型之外增加一部分参数,例如在一个 200M 参数的模型基础上新增 10M 参数,并通过训练新增参数适应新的场景。但随着适配场景不断增加,新增参数的总量可能逐渐接近甚至超过原始模型规模,因此难以作为长期解决方案。
时空校准持续学习的整体参数开销与原始模型保持一致,且实际参与训练的参数量仅约占原模型的 10%,因此能够显著减少训练时间,并提升模型在时序预测、时空预测和持续适应等任务中的表现。
2.时空建模:通过提示实现新场景快速适配
前述两种持续学习方法主要通过模型参数更新实现新场景适配。
接下来,林丽进一步介绍了一种无需微调的时空建模方法:使用现有的时空数据集预训练时空大模型,使模型能够像语言大模型一样,通过输入提示词理解数据变化。
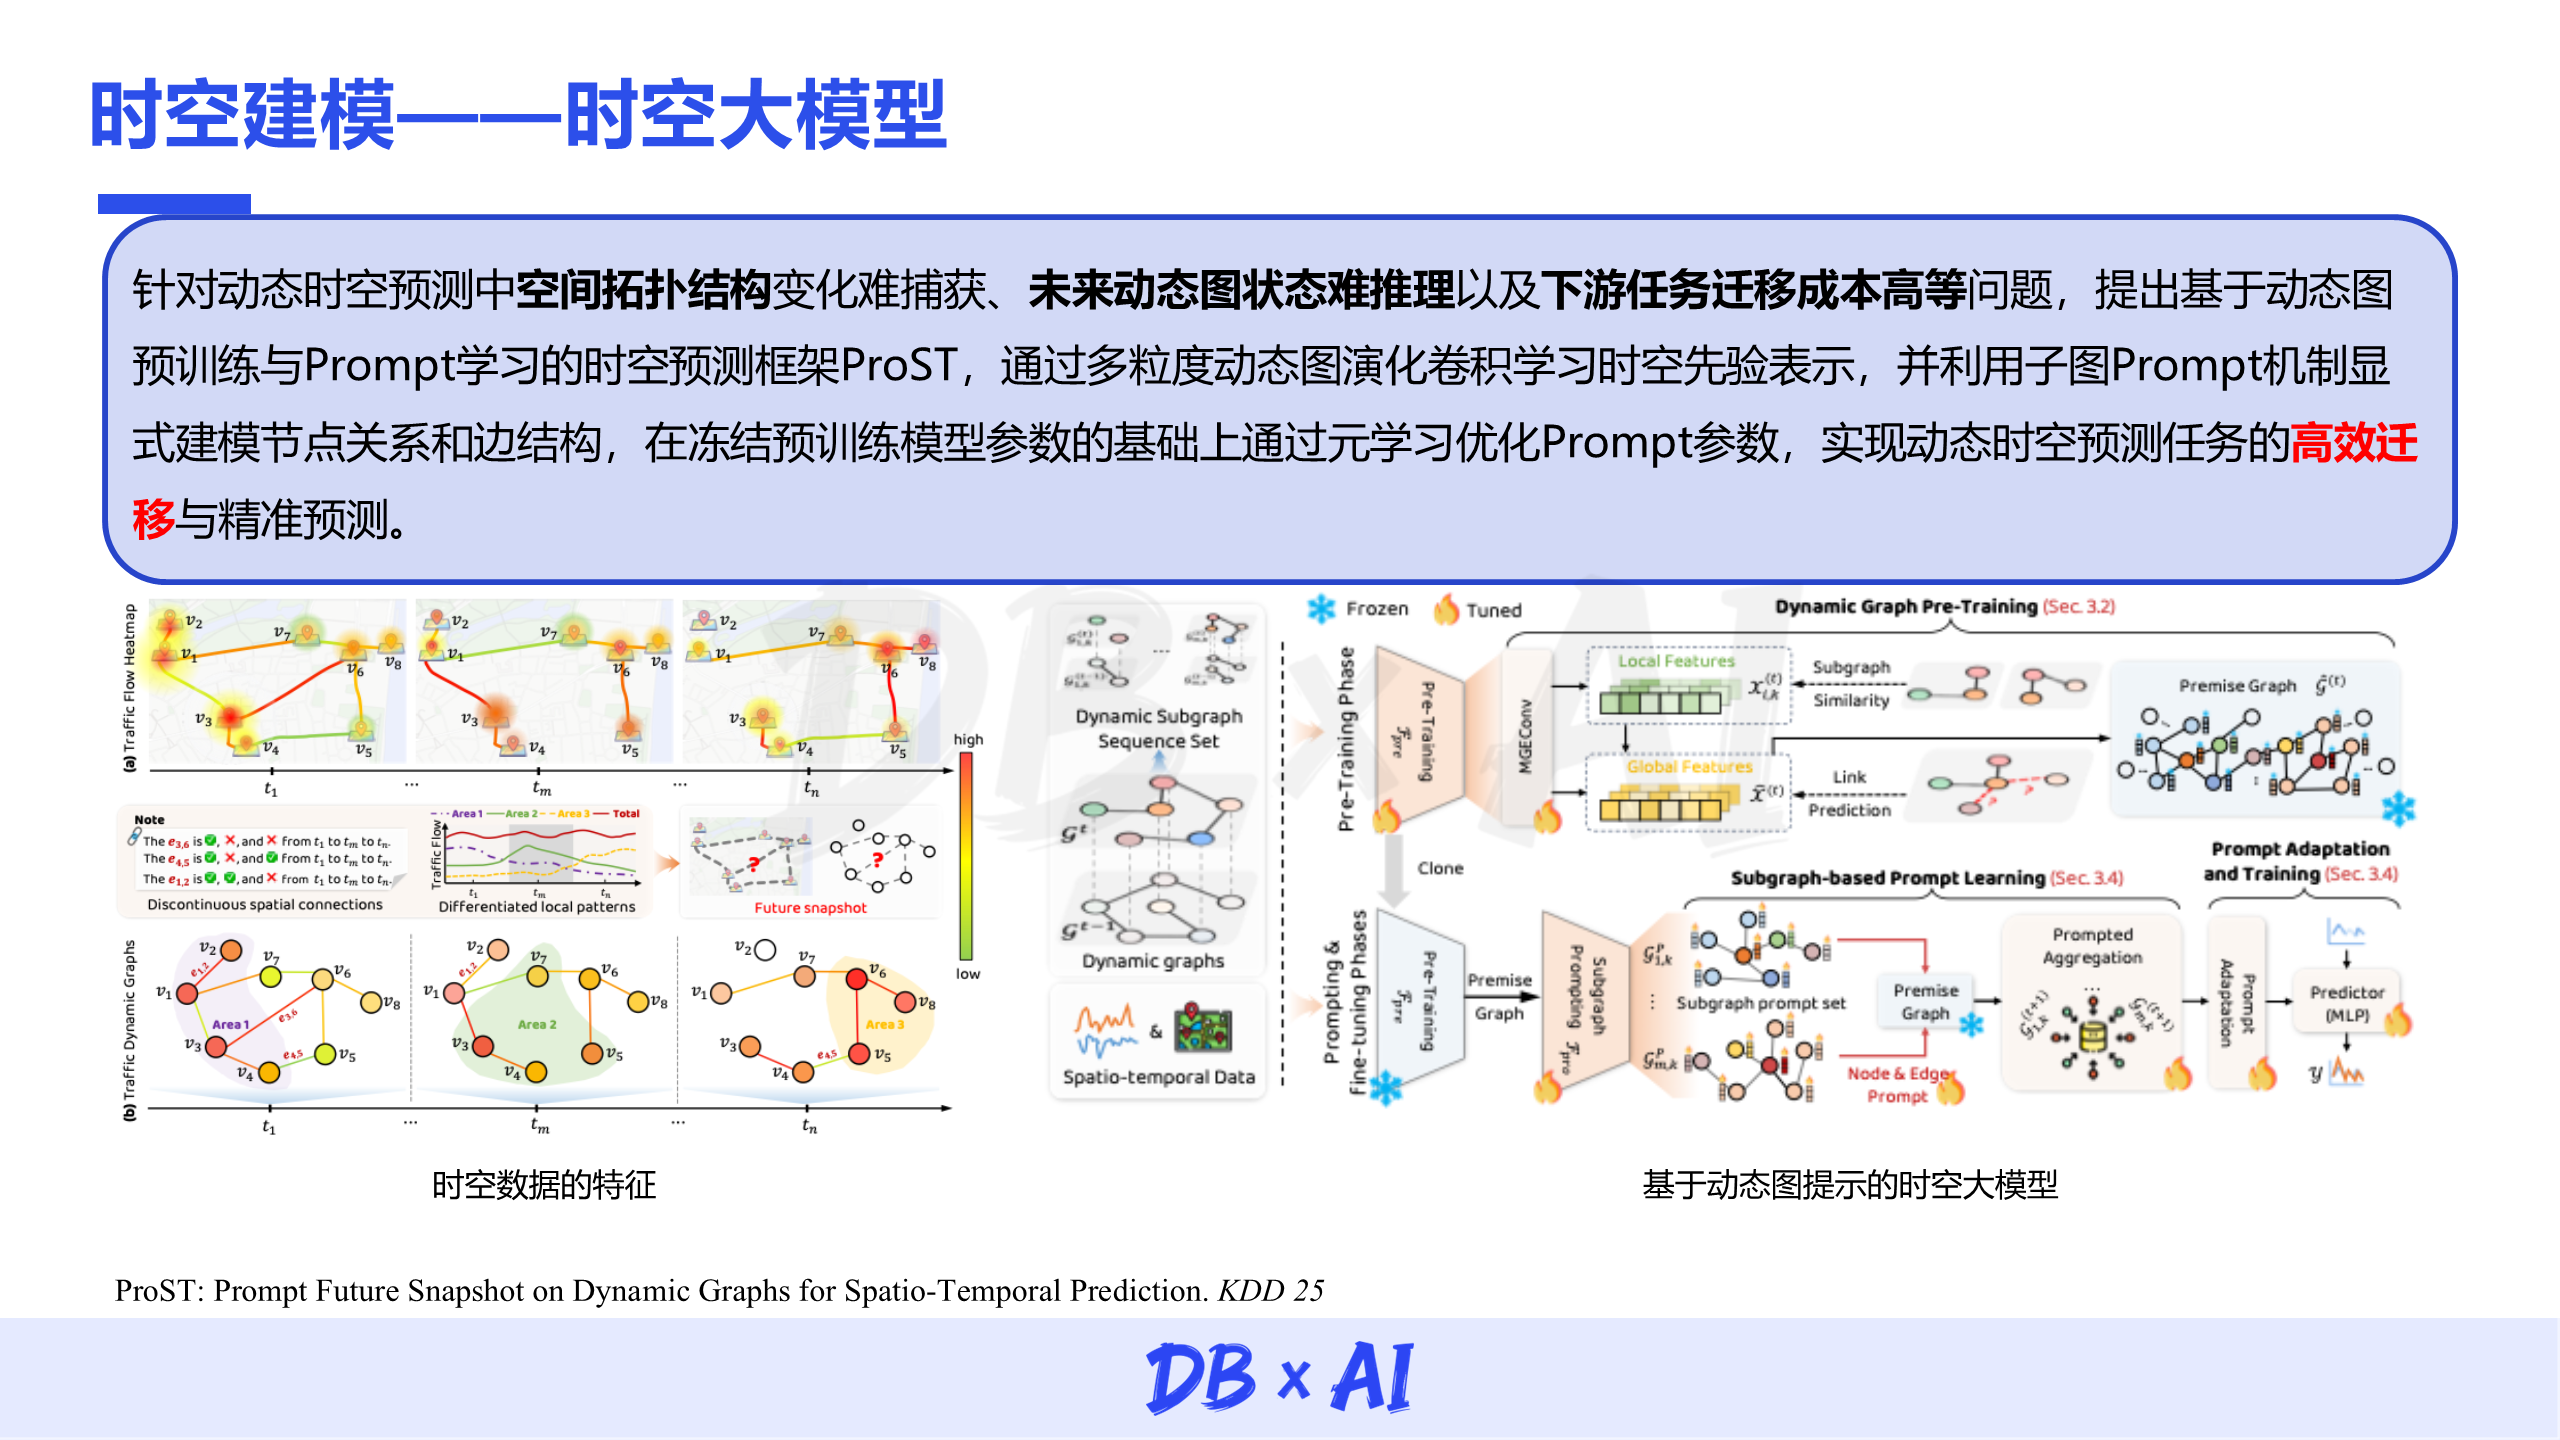
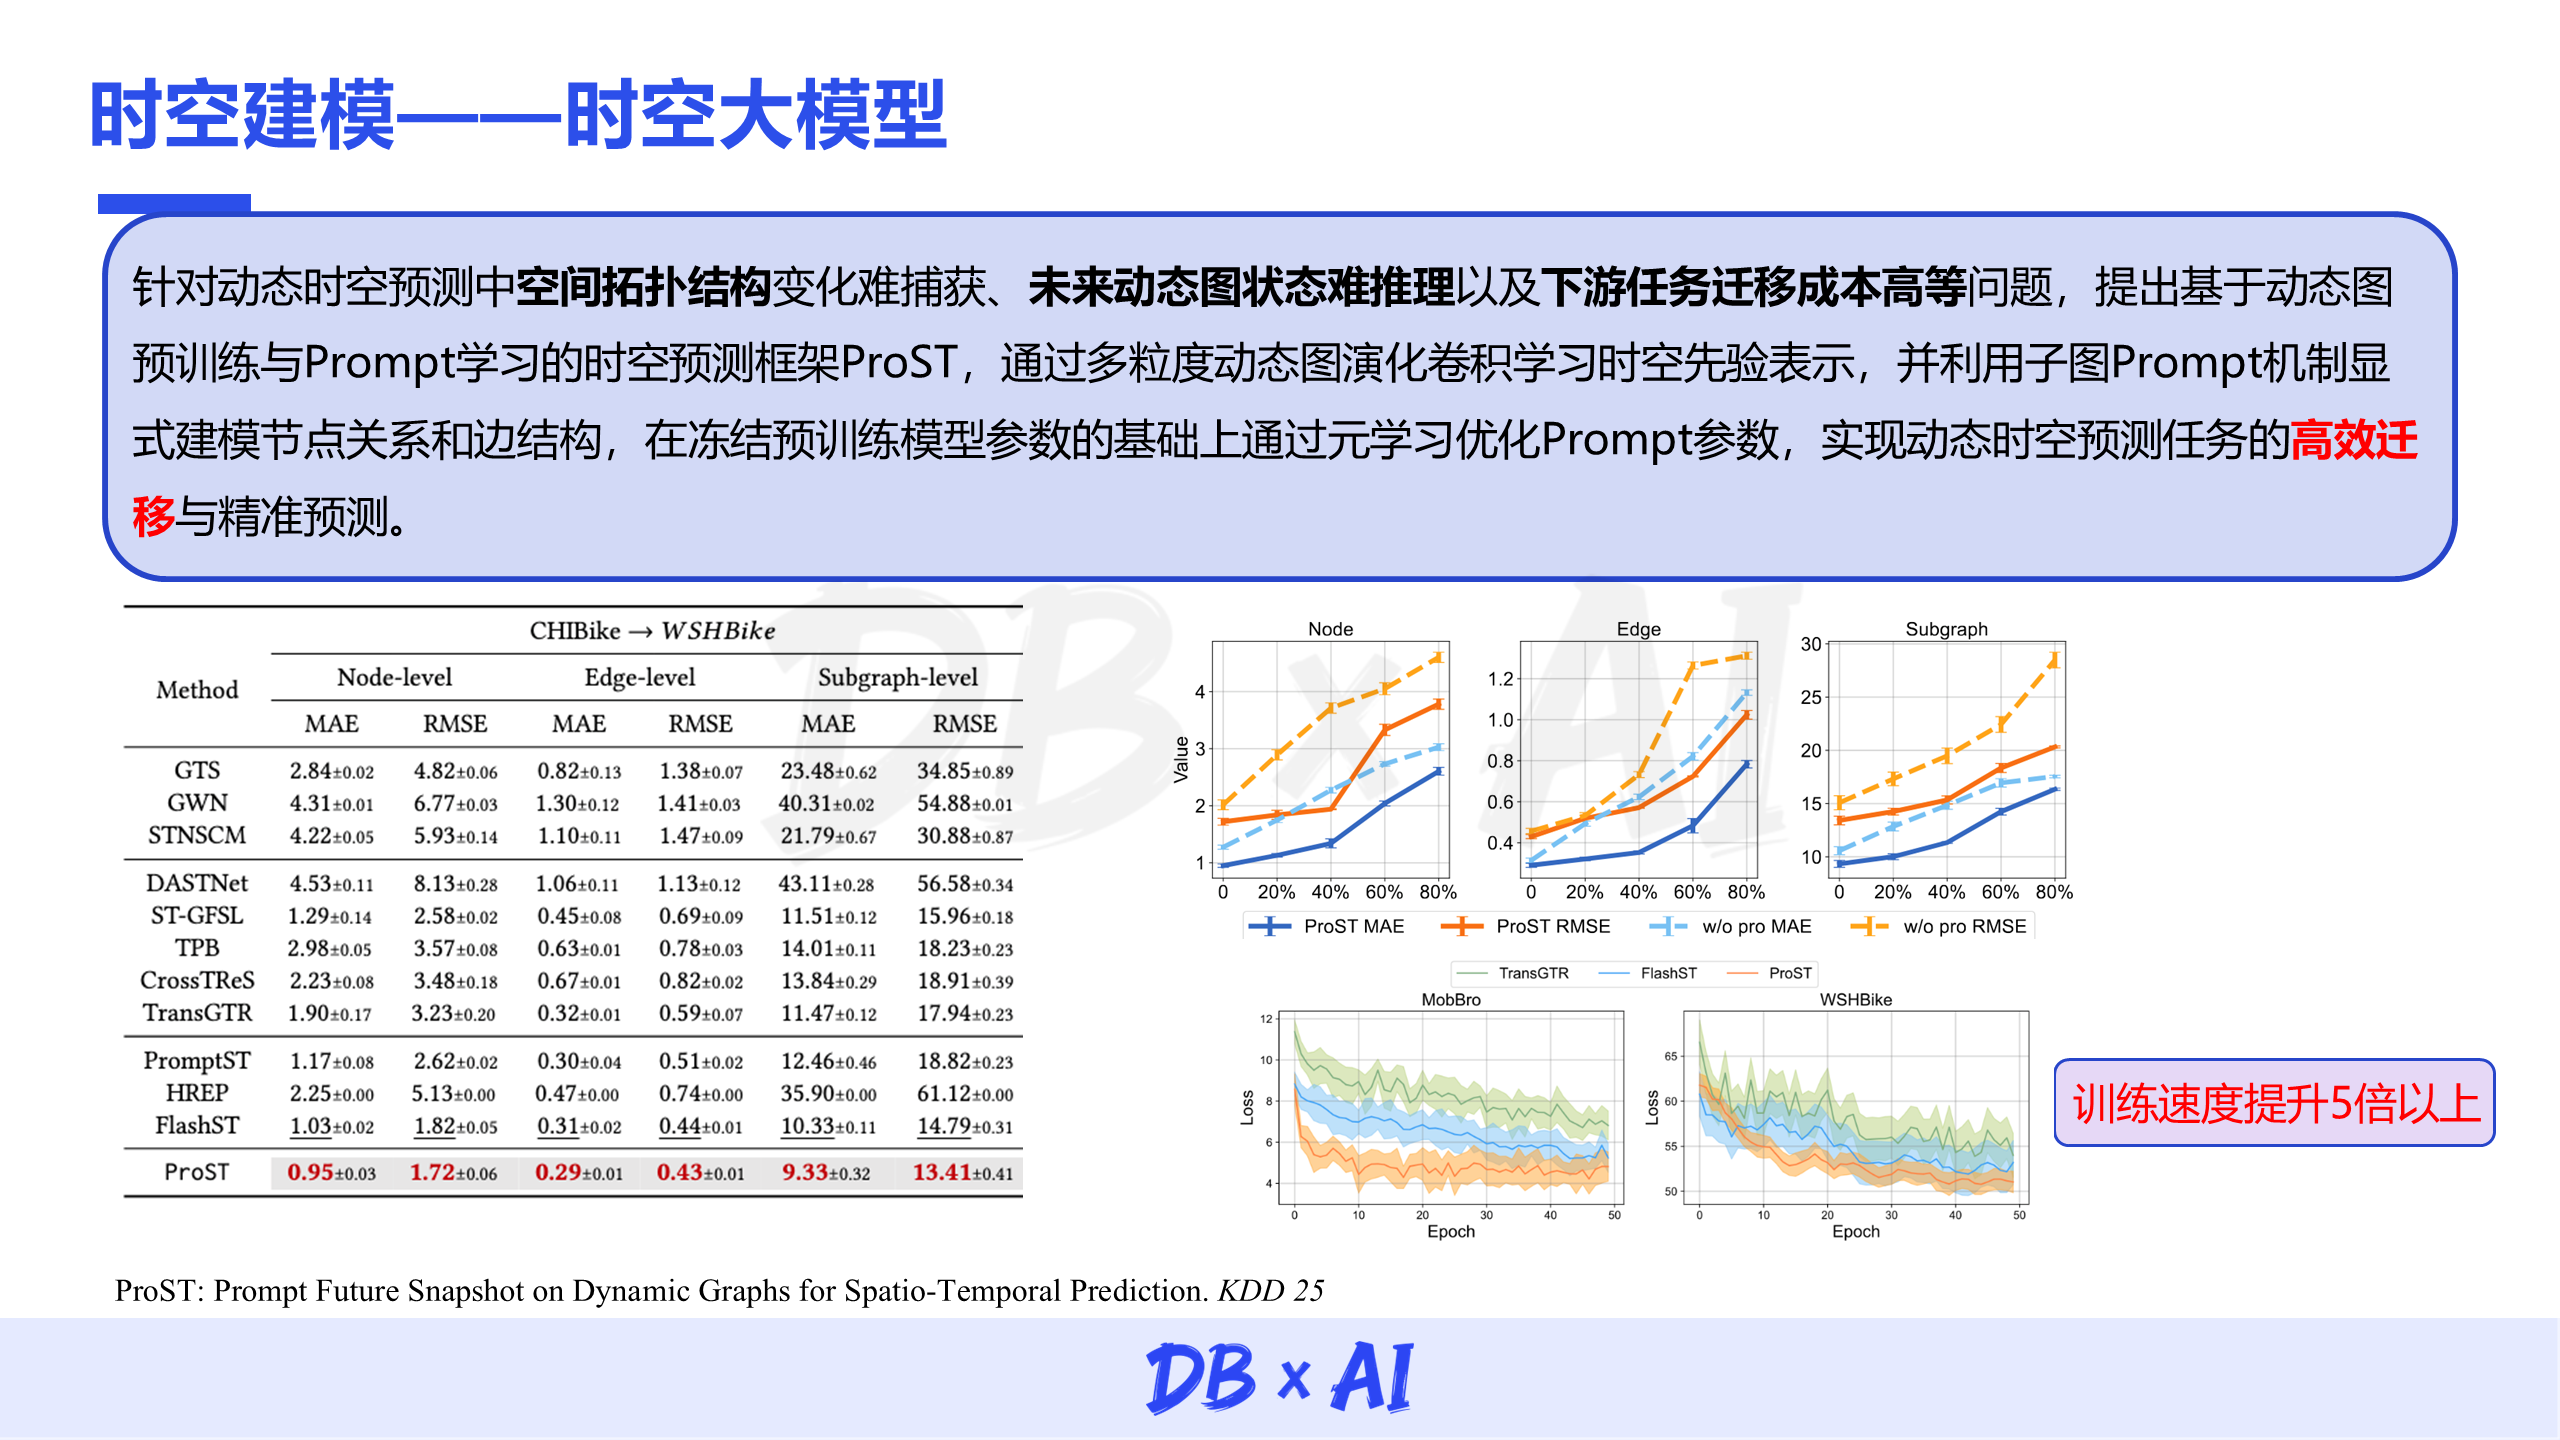
在这项研究中,团队提出了基于动态图预训练与提示学习的时空预测框架 ProST。
该方法首先利用历史动态图数据进行预训练,学习节点及其连接关系随时间演变的规律,再通过专门设计的子图Prompt 机制,对节点关系和边结构进行建模,以支持未来动态图状态的预测。
与直接微调整个预训练模型的方式不同,ProST 在适配下游任务时,可以冻结预训练模型的参数,通过优化 Prompt 参数,使模型利用已经学到的时空知识完成新的预测任务。
与同类时空大模型相比,该方法能够将训练速度提升 5 倍以上,体现出提示学习在降低任务适配成本方面的潜力。
3.不规则时序建模:适应异步采样与数据缺失
针对不规则时序数据,林丽介绍了团队对时序大模型能力的进一步拓展。
在实际数据采集过程中,不同传感器往往无法保持相同的采样频率,这就是不规则的时序数据。例如,在海上支撑结构监测中,海洋环境数据可能以天为单位采集,而结构应变片的数据采样频率则可能达到毫秒级。尽管两类数据的时间粒度差异很大,但在预测结构响应时,仍然需要综合利用这些信息。
面对异步采样问题,一种处理方式是直接将低频数据复制成数千份,再与高频数据进行对齐,虽然能够实现形式上的匹配,但不仅成本较高,也可能破坏数据原有的变化规律。高频数据通常在短时间内变化有限,而复制后的低频数据则完全保持不变,模型很难据此判断数据未来的变化趋势。因此,如何在不强制补齐所有时间点的情况下,直接利用原始观测值及其时间信息进行建模,成为不规则时序研究的重要方向。
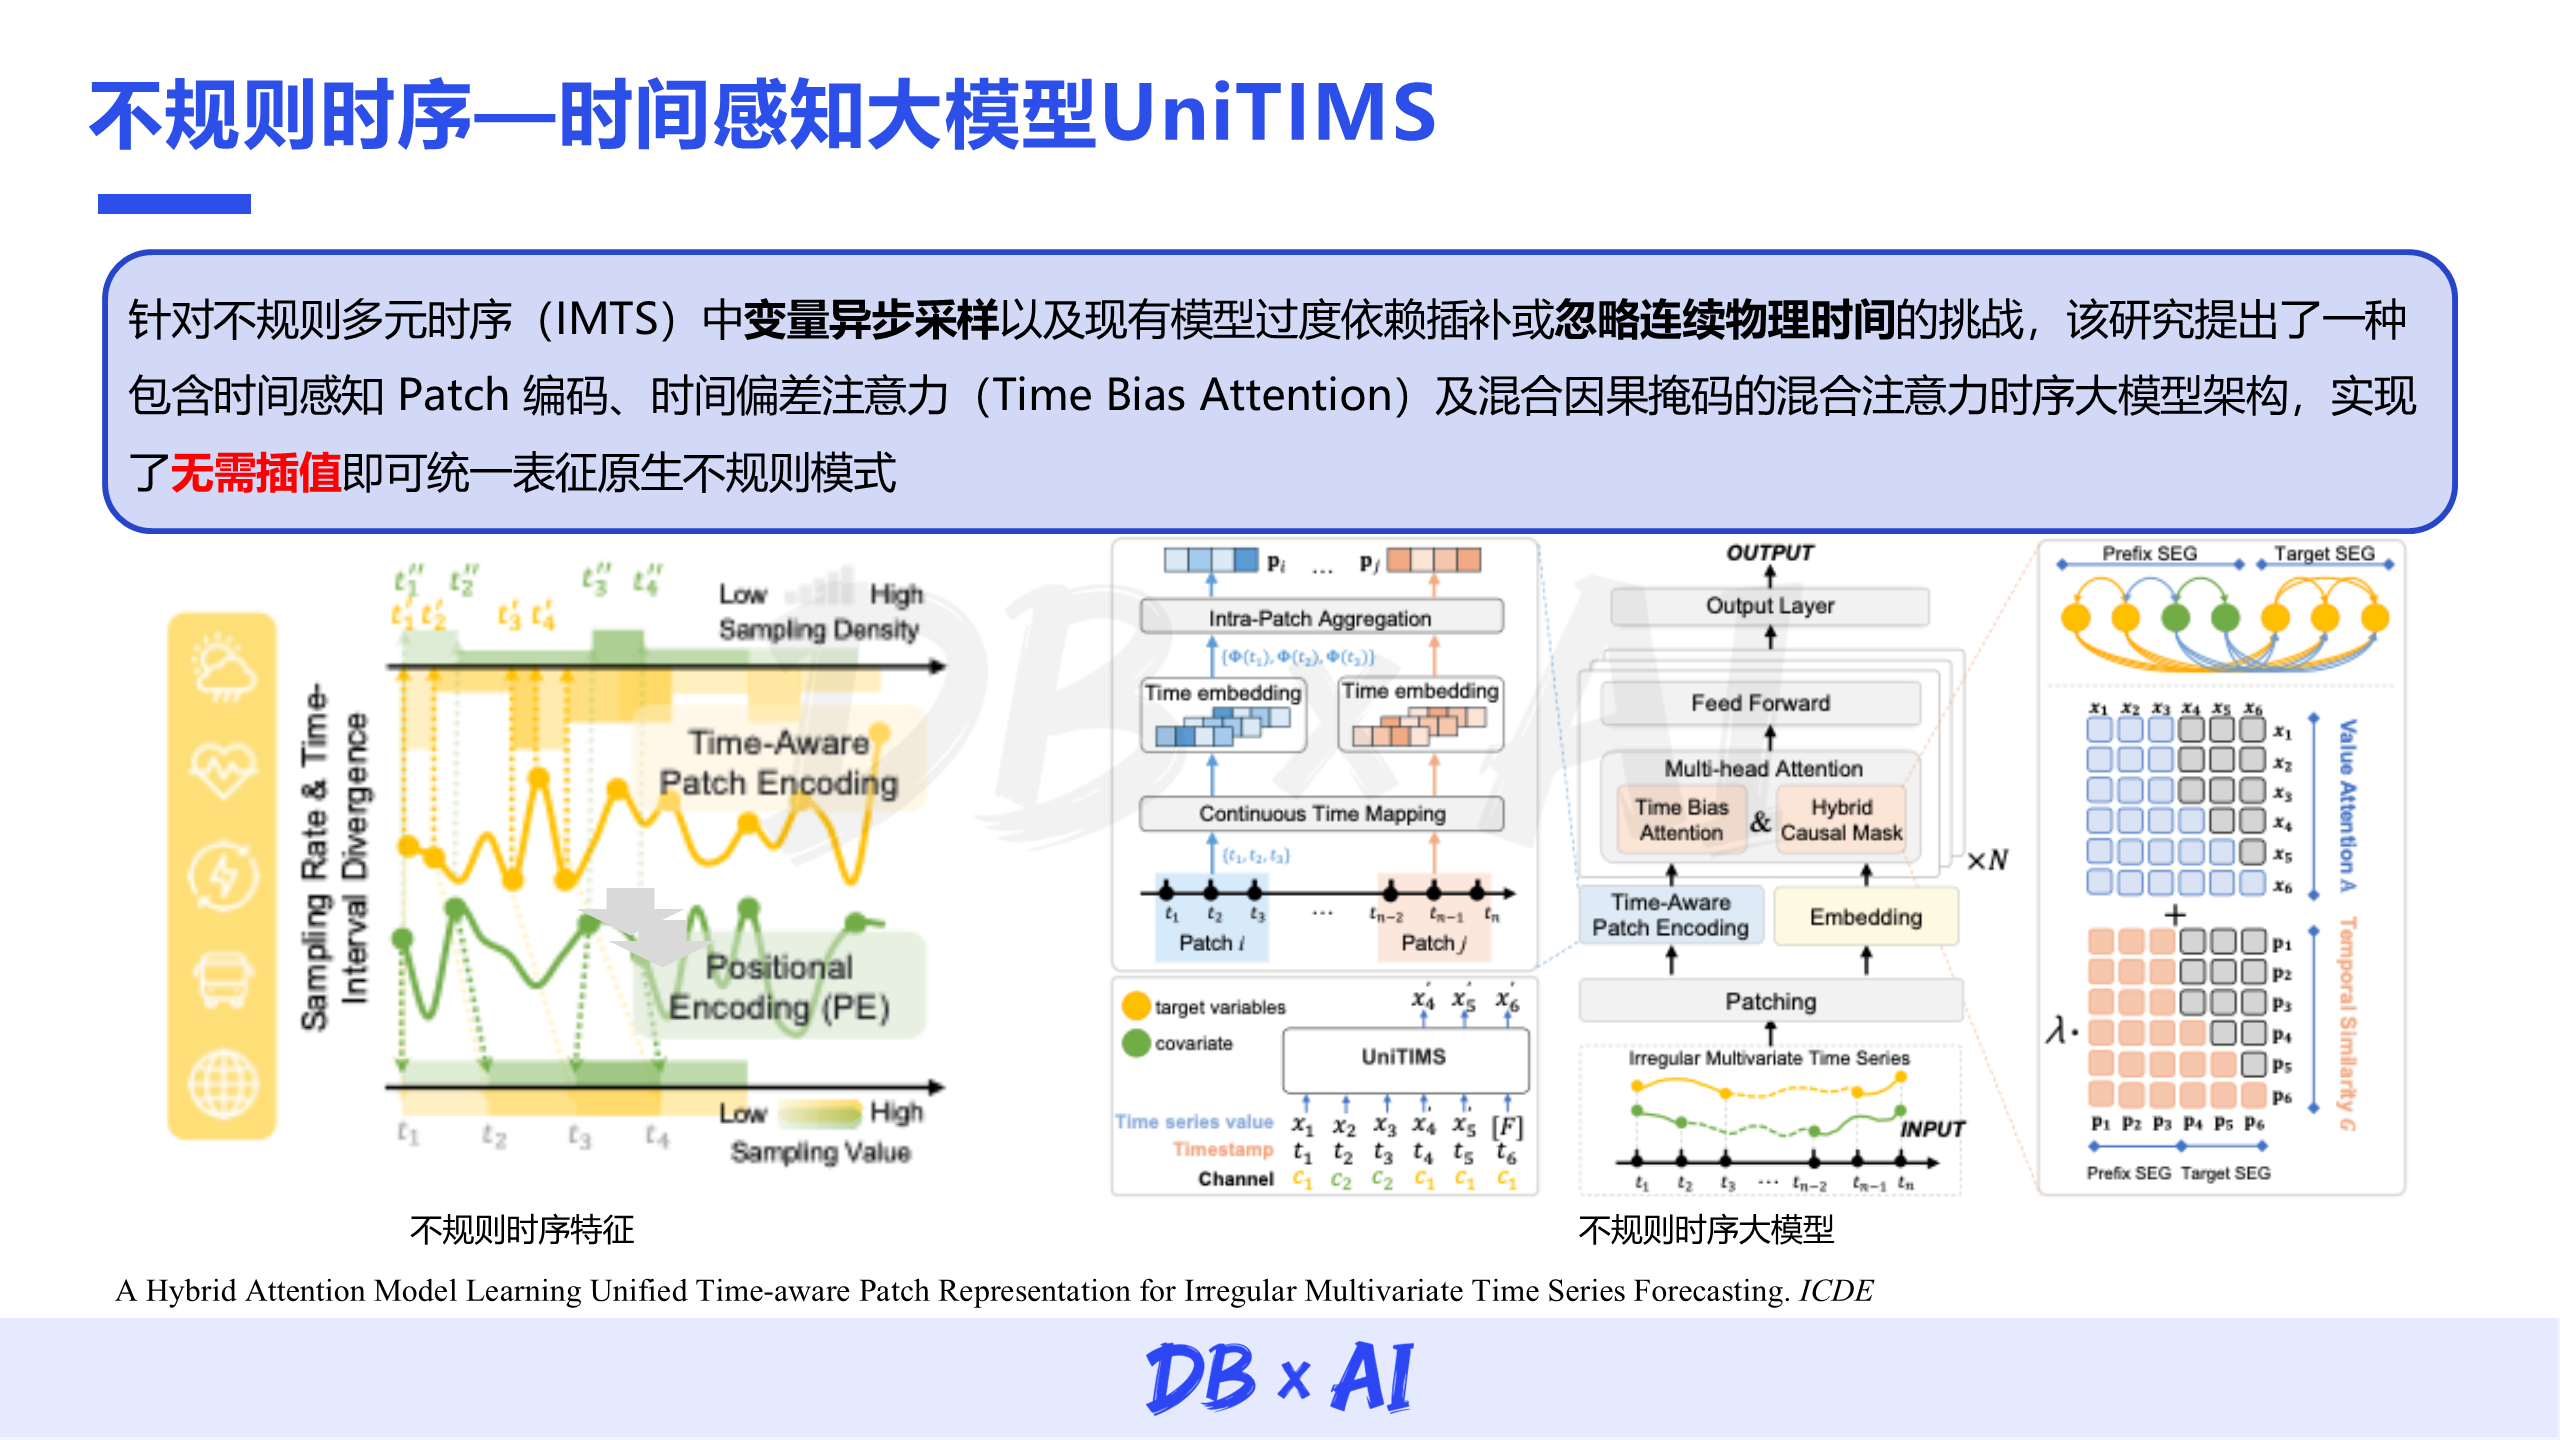
为此,团队构建了时间感知大模型 UniTIMS,使模型无需进行传统时间插值,就能够处理不同变量之间的异步采样问题。UniTIMS 采用时间感知 Patch 编码、时间偏差注意力(Time Bias Attention)和混合因果掩码等机制,在处理不规则观测的过程中保留真实的时间信息,并学习不同采样时间及不同变量之间的关联。
这意味着,即使不同传感器的采样频率不一致,或者部分时间段因为设备故障、通信异常等原因缺少观测值,模型仍然可以利用已有数据开展预测,而不必强制补齐所有缺失时间点。
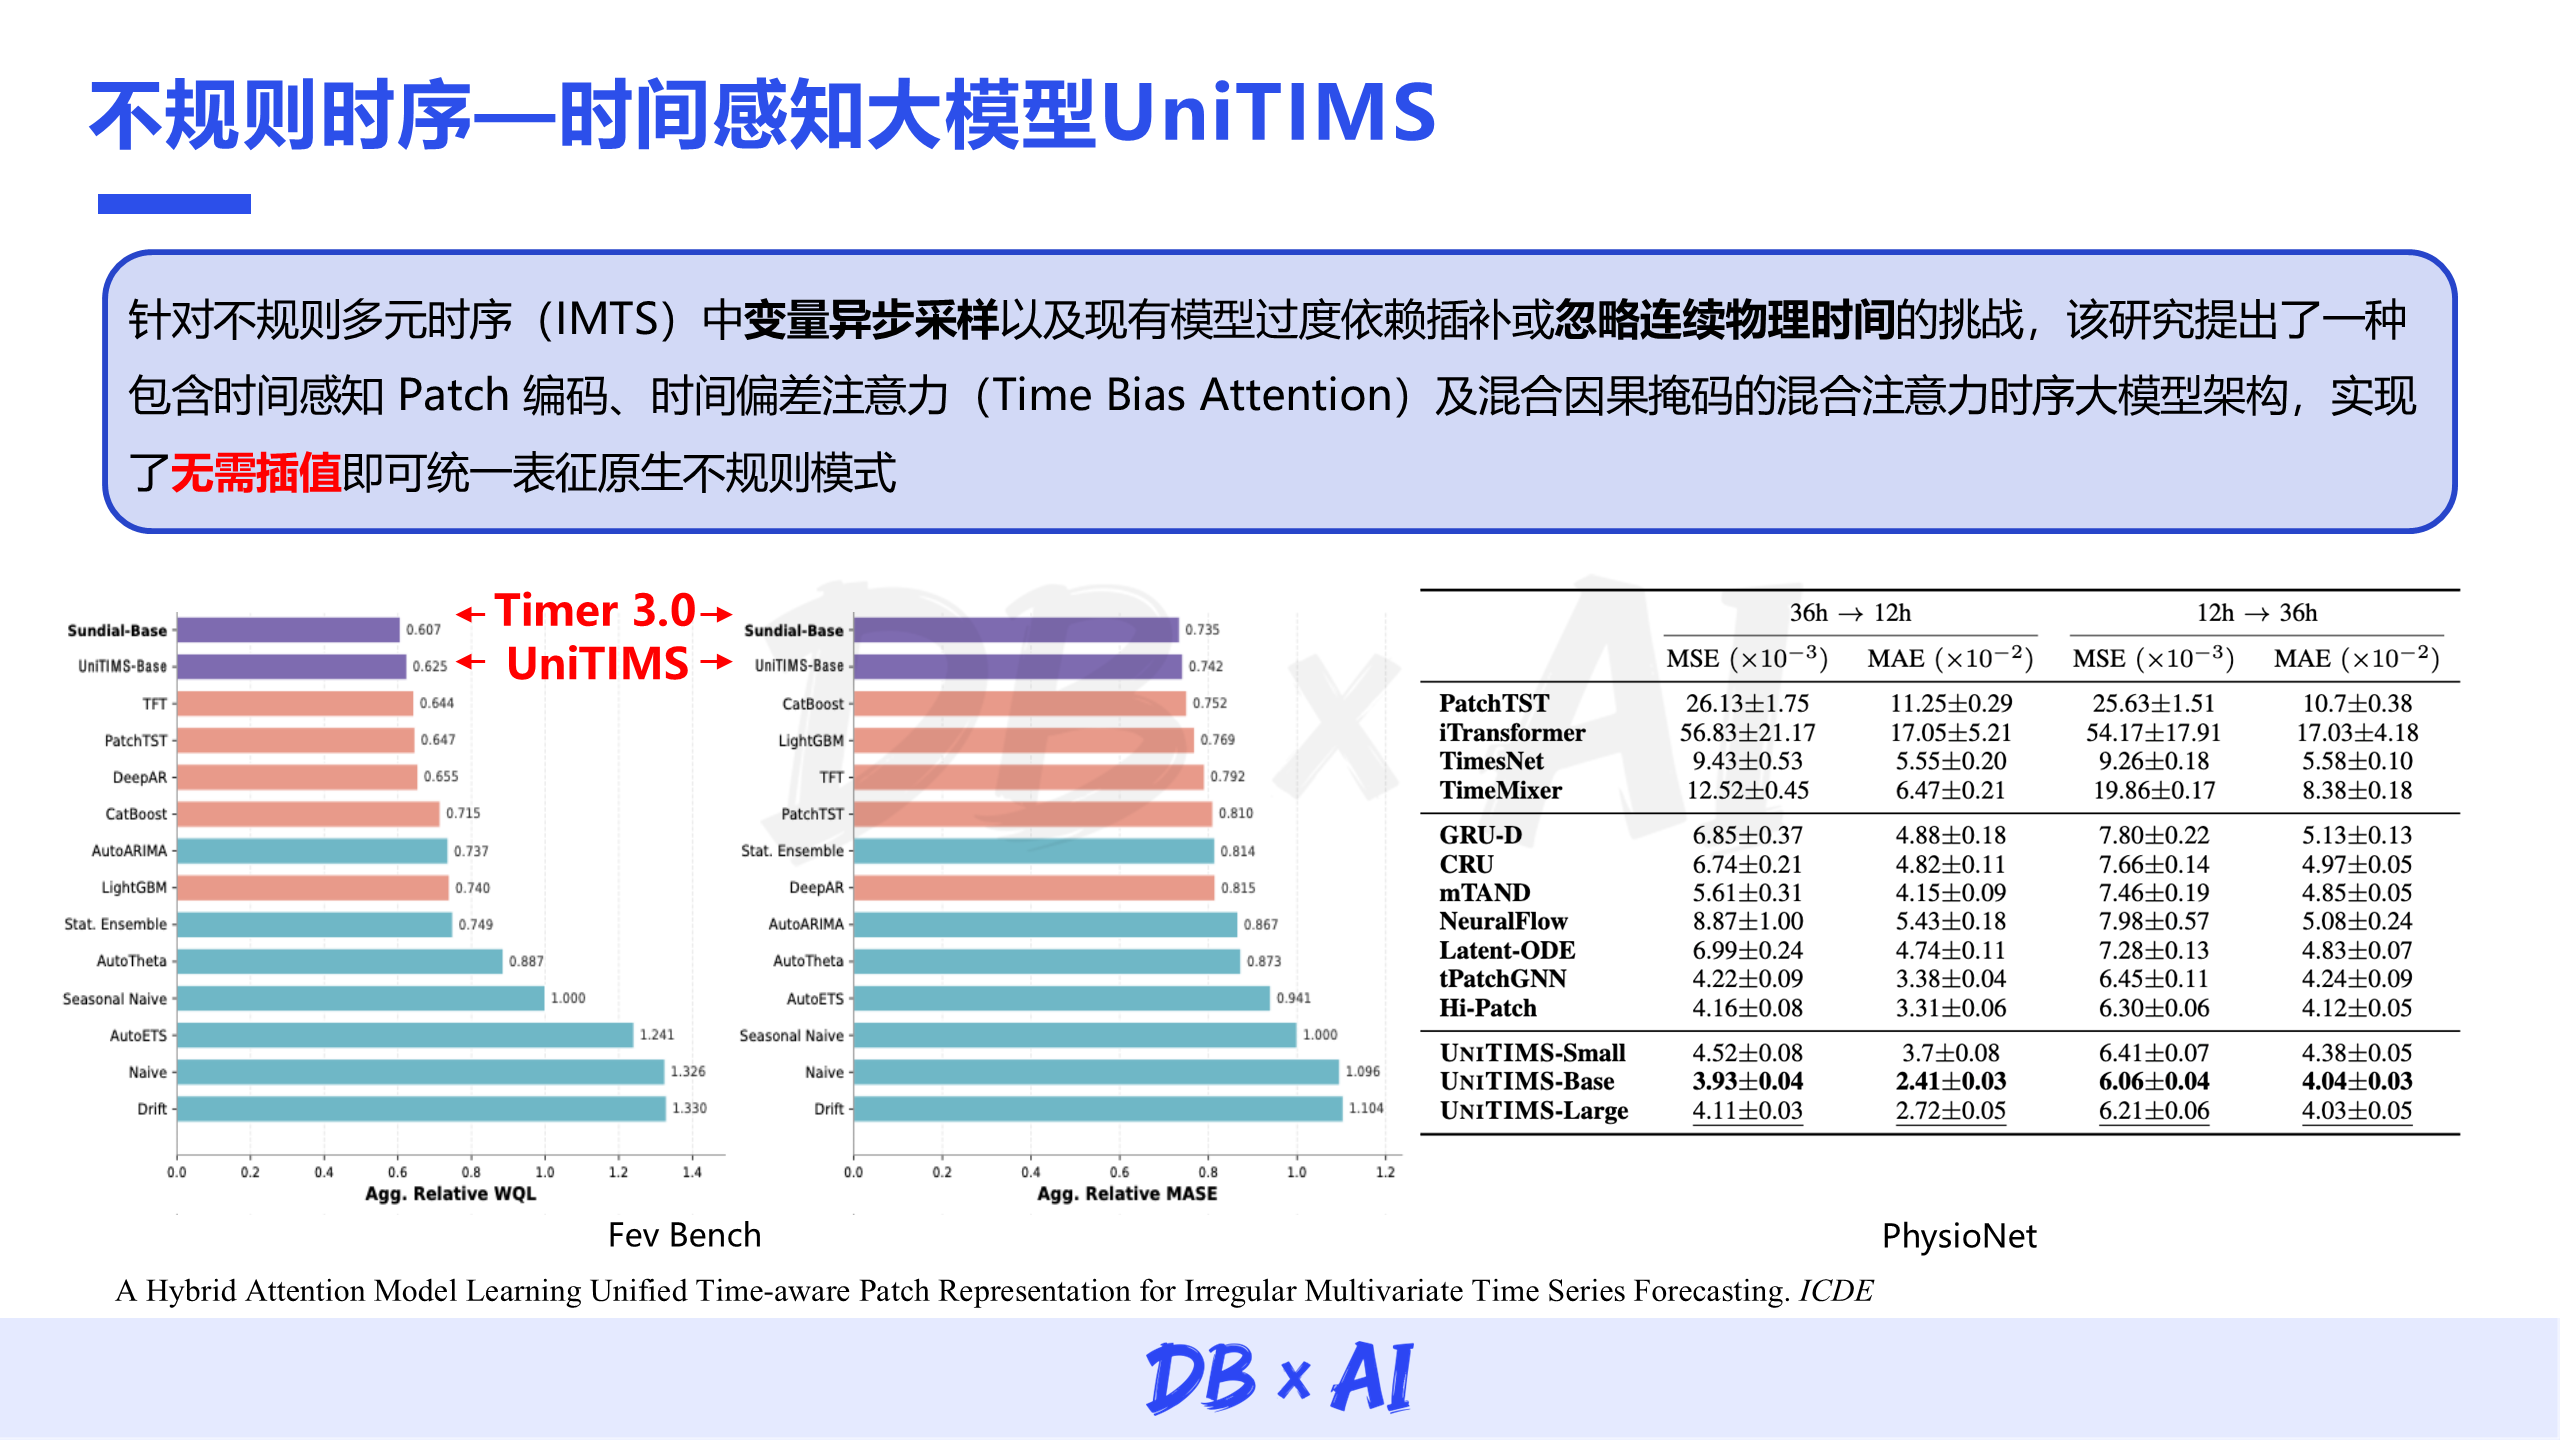
在公开测试基准上,UniTIMS 在同时包含规则时序和不规则时序的数据集上的准确率略低于 Timer 3.0(下图左图左侧);但在以不规则观测为主的 PhysioNet 测试基准上,UniTIMS 取得了优于所比较基线模型的预测表现。
这一结果表明,针对不规则时间结构进行专门设计,有助于提升模型在异步采样和观测缺失等场景下的适应能力。林丽也指出,不同模型各有其适用场景。对于具有明显不规则采样特征的数据,UniTIMS 提供了一种无需先将所有观测强制对齐到统一时间网格的建模选择。
针对部分用户不信任模型“黑箱”的预测结果,希望有办法了解模型如何处理缺失数据的问题,林丽团队还构建了一个小规模模型,通过“先插值、再生成”的方式,对模型处理缺失数据的过程进行可视化展示。该方法基于扩散生成模型,先对缺失数据进行补全,再在补全结果的基础上完成预测。在现有多个数据集上的测试表明,该方法能够取得较好的表现。
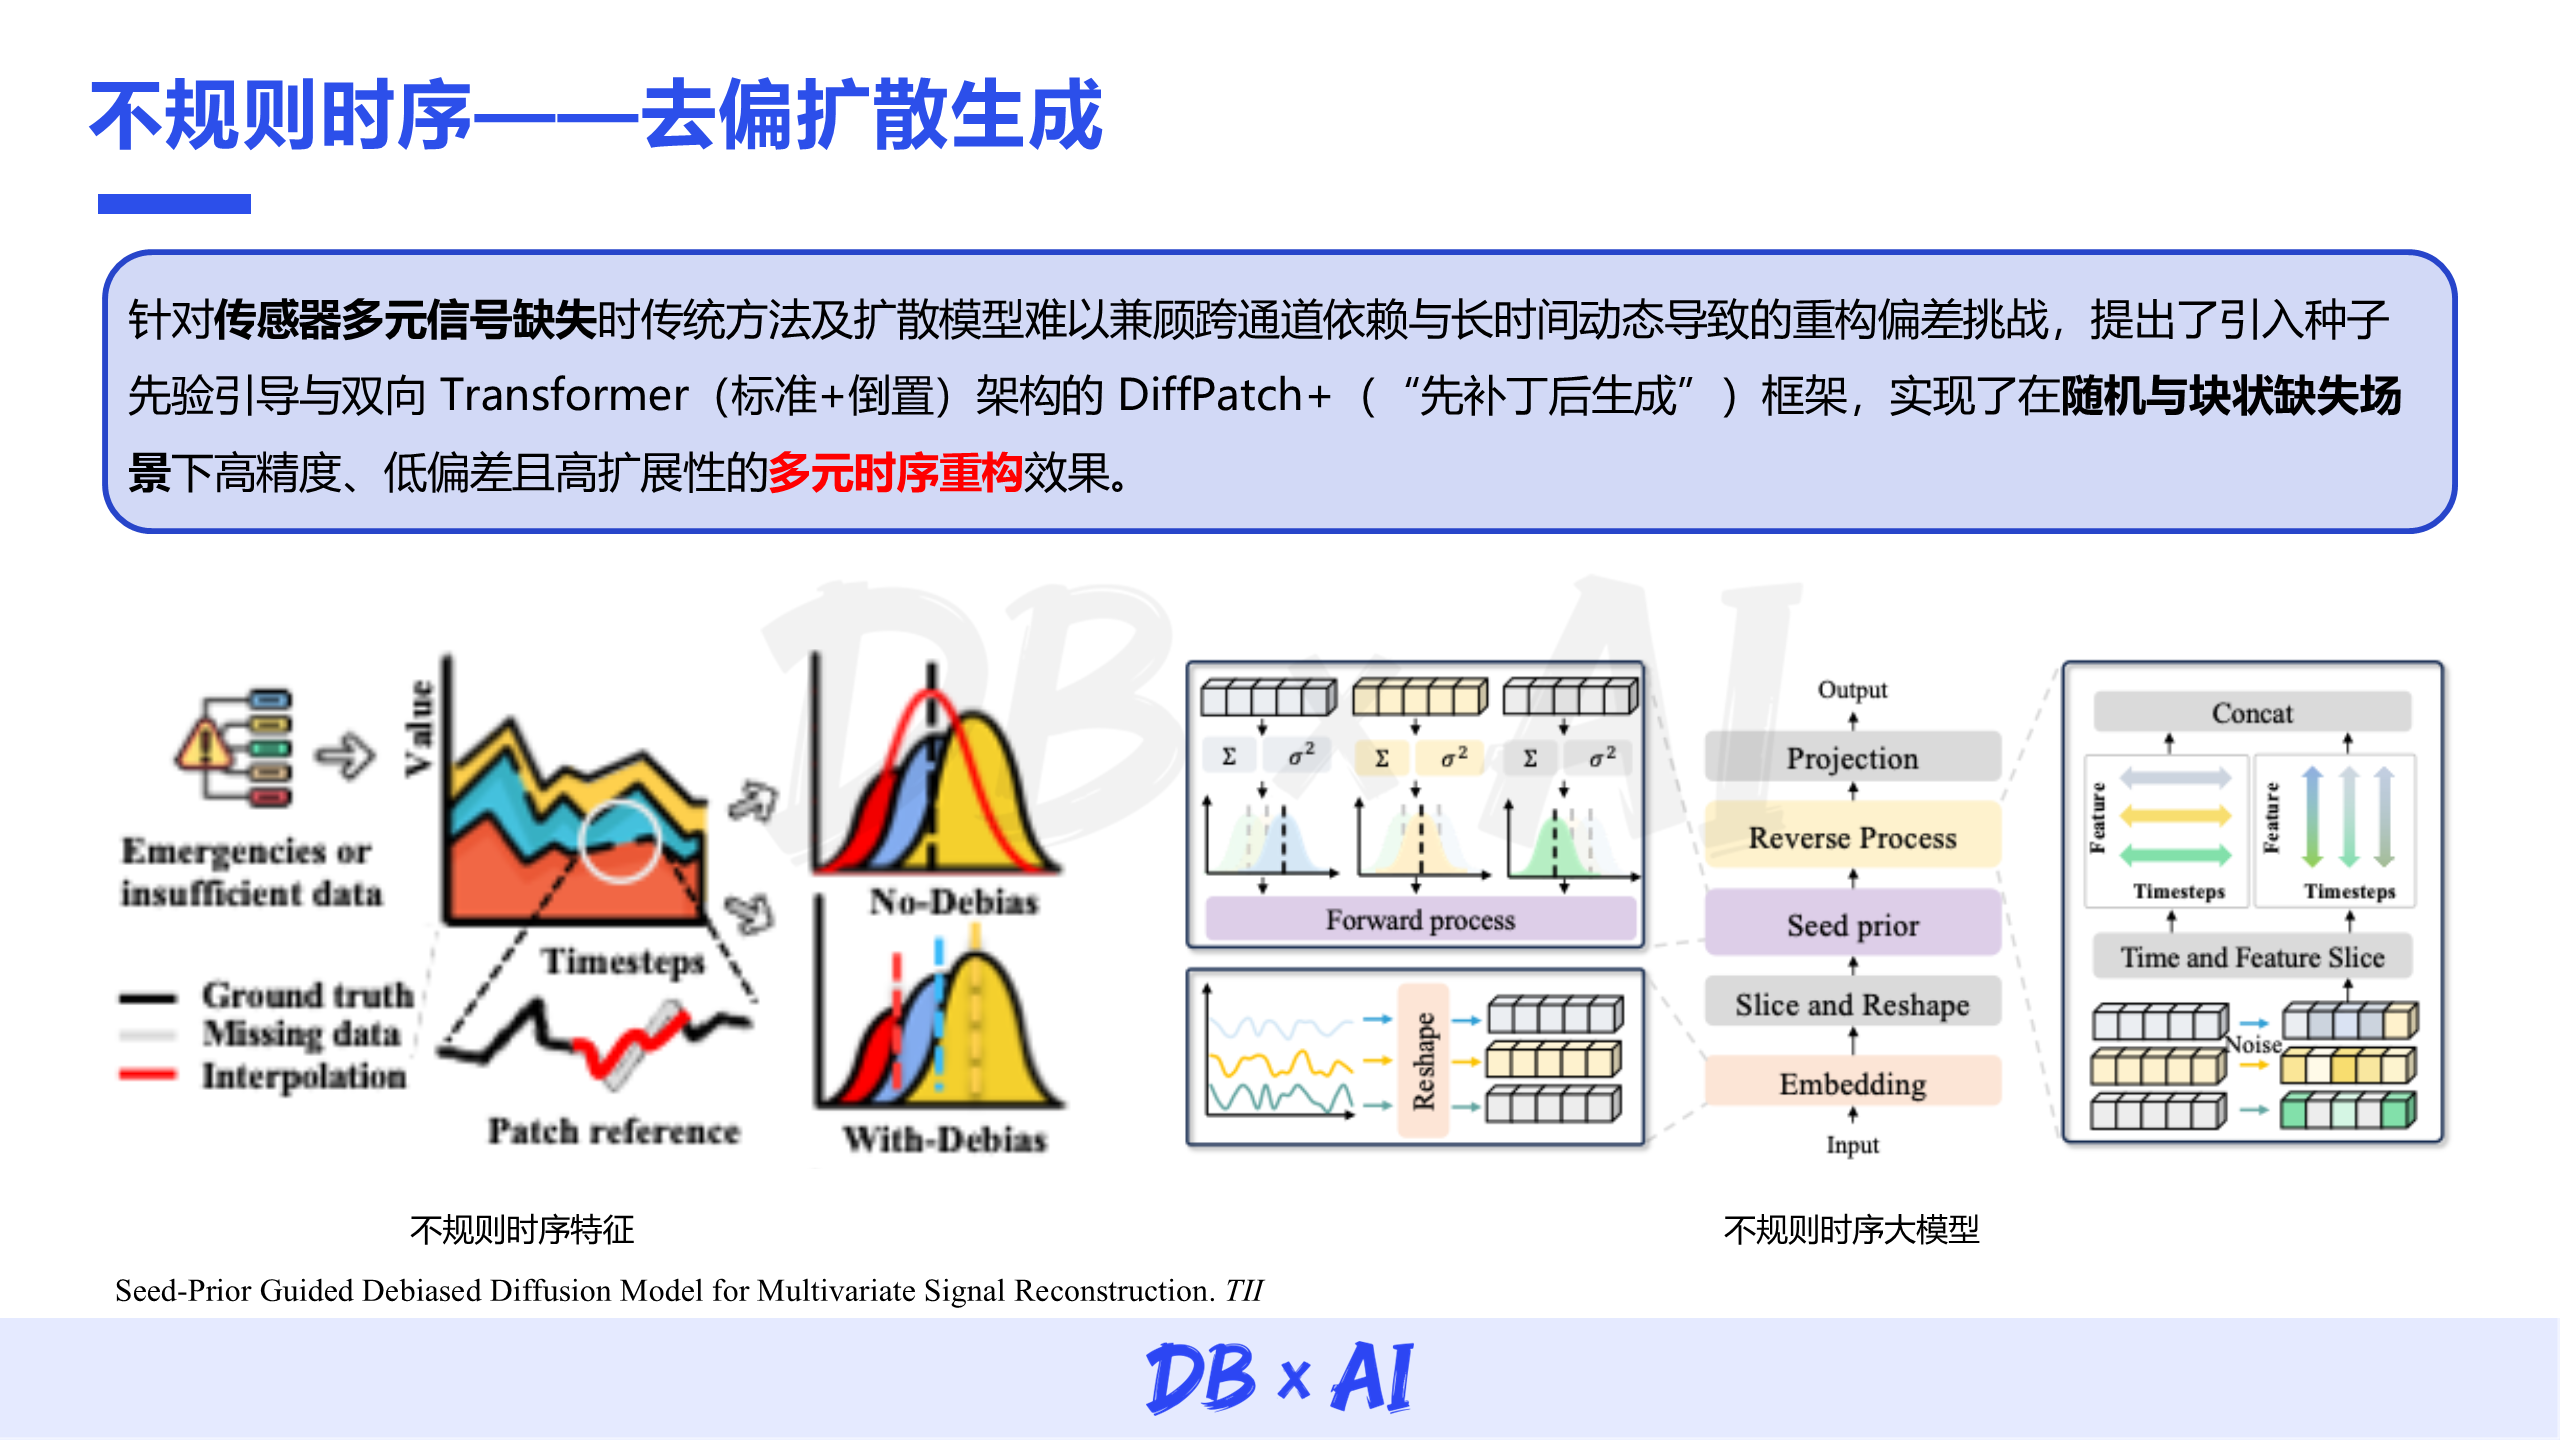
由于该模型具备先进行补全生成的能力,因此能够应对更加严重的数据缺失情况。即使数据缺失率达到 80%,模型仍可以尝试预测未来序列,并保持相对稳定的效果。
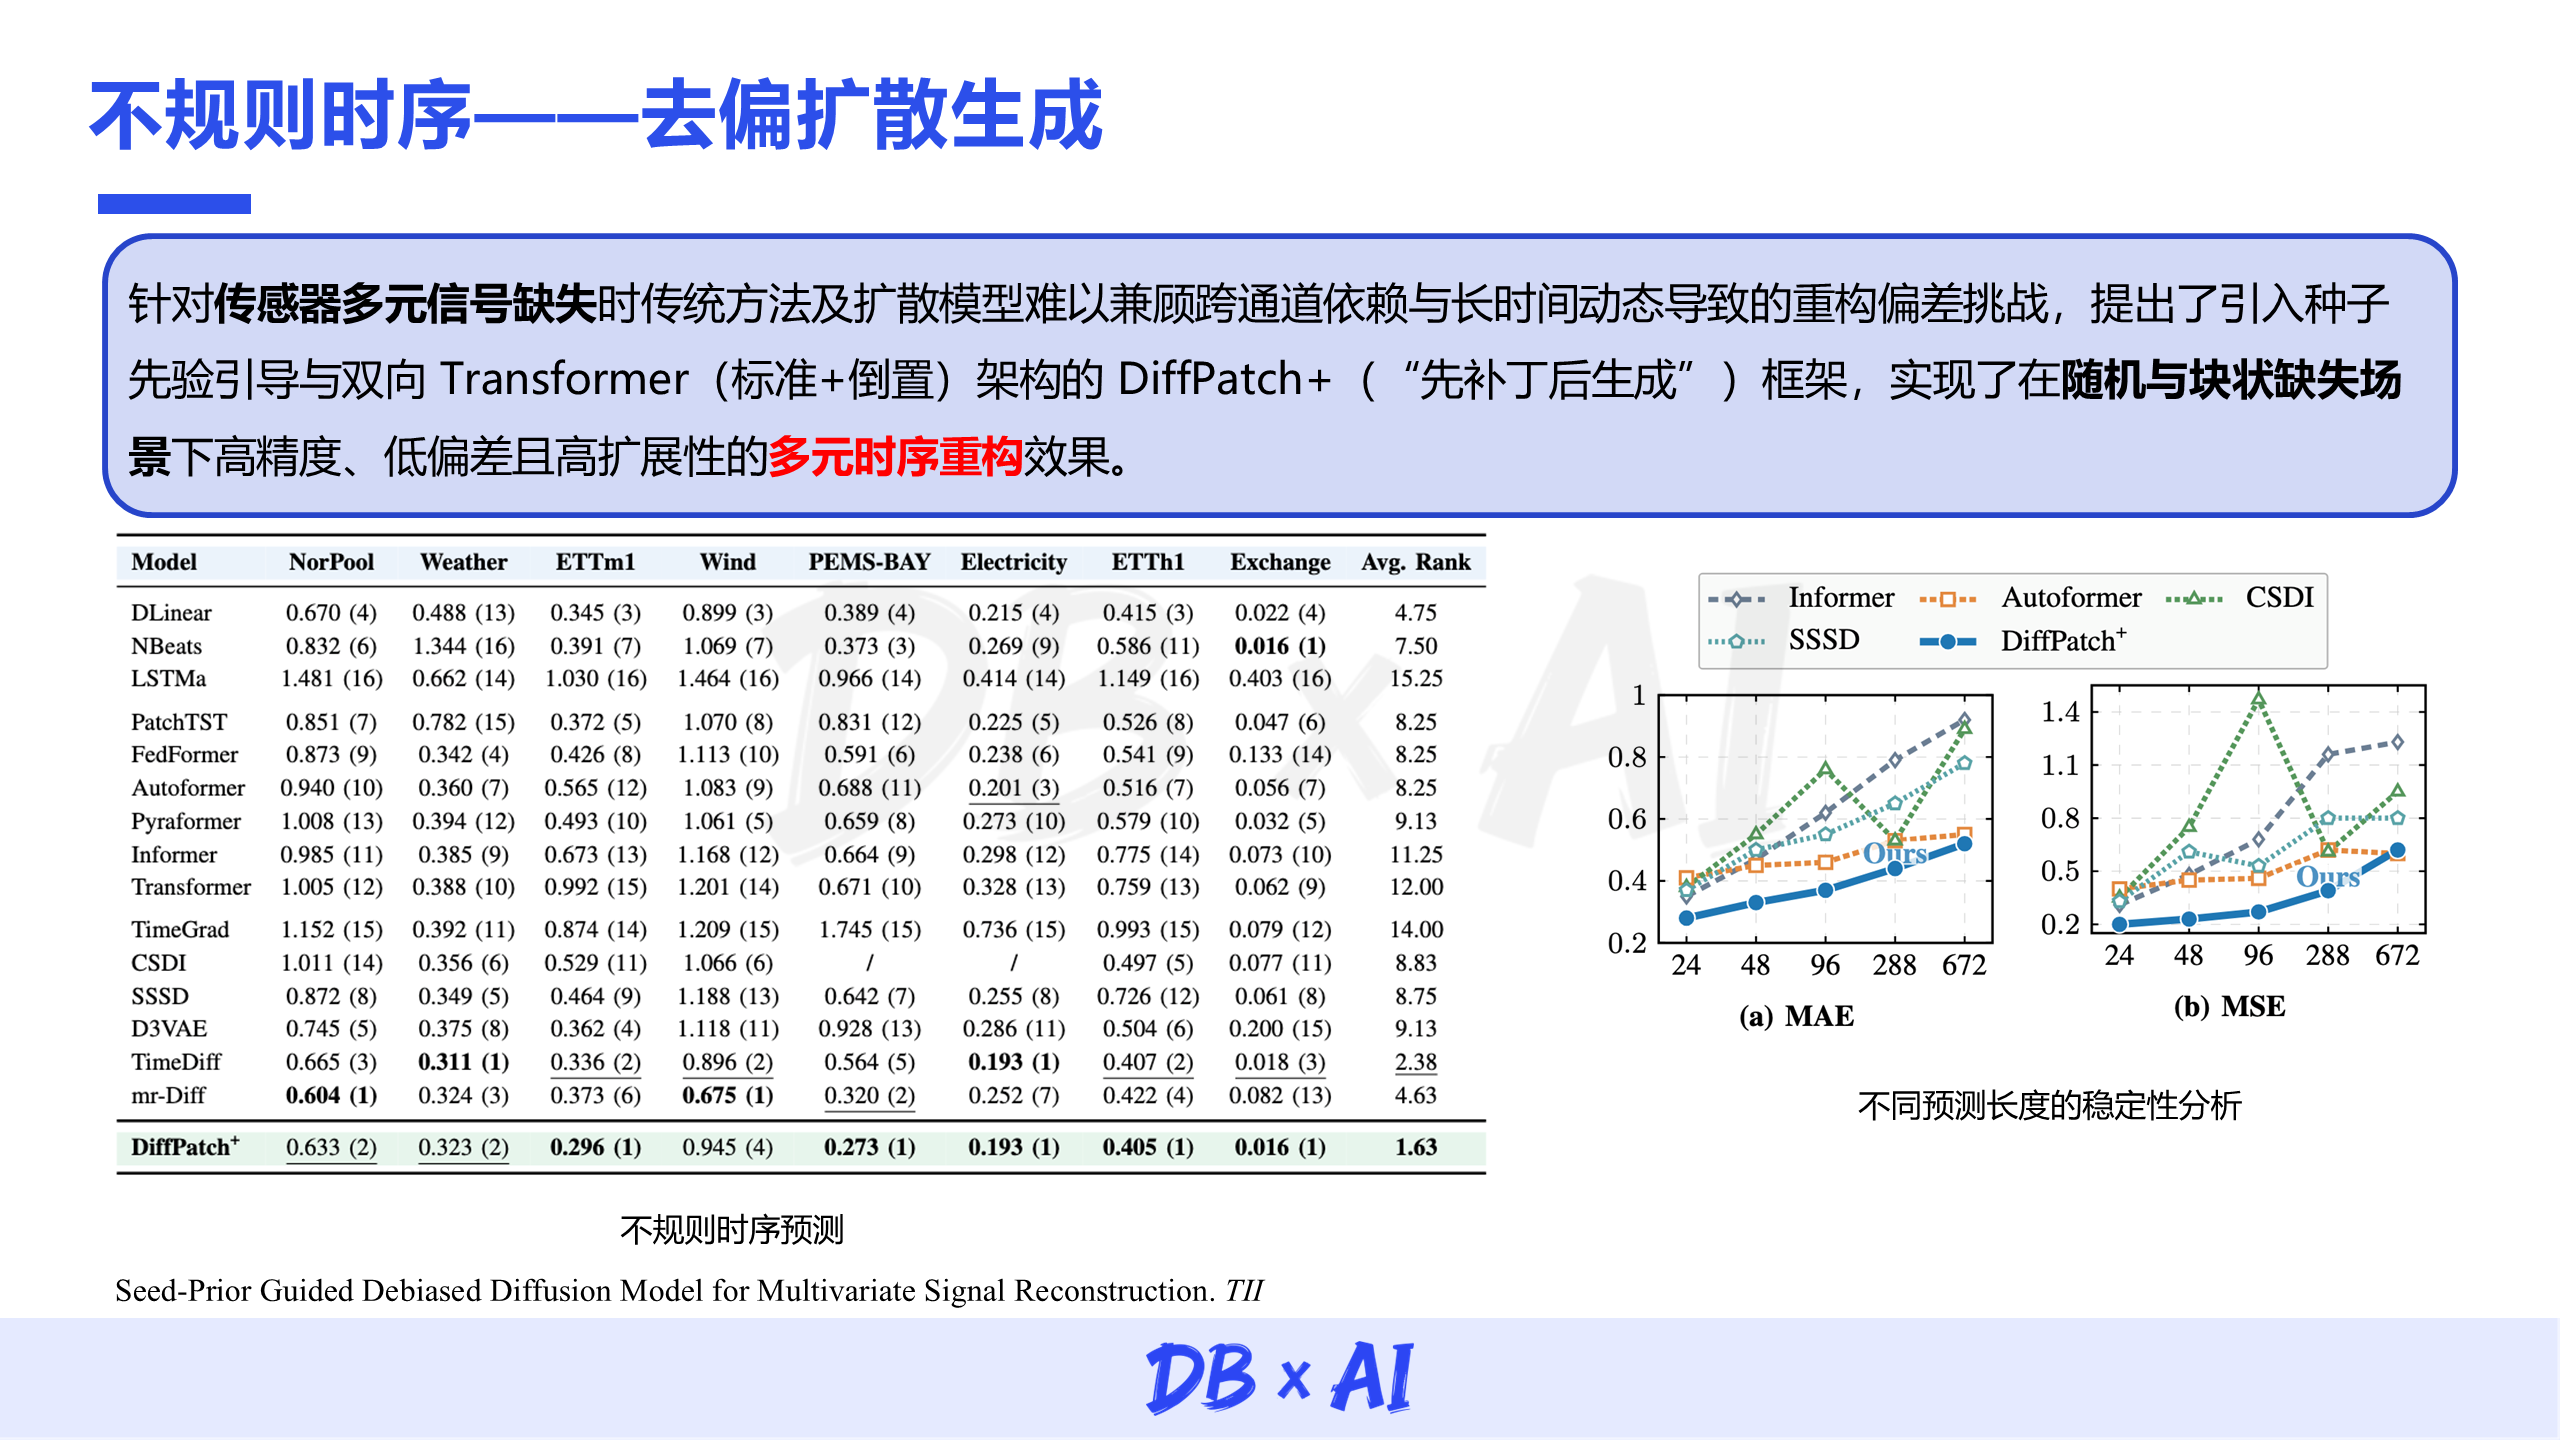
总体来看,围绕不规则时序数据,当前的技术探索主要包括原生不规则时序建模,以及基于生成式插值的缺失数据处理方法。这两类方法分别从原生建模和数据重构的角度,为复杂时序数据处理提供了不同选择。与前面介绍的持续学习和时空建模研究一起,共同体现了团队在通用时序模型应用适配方面的探索。
时序大模型应用案例:结构响应预测与电池异常预警
除了上述技术研究,林丽还分享了团队在实际场景中的两项应用探索,分别涉及海上支撑结构响应预测和电池组异常预警。
第一个案例是海上支撑结构的响应预测。团队基于Timer 2.0,引入海上风、浪、流等环境观测数据作为协变量,并利用约一个月的实际工况数据进行小样本微调,对海上支撑结构的载荷及相关响应进行预测。
这一场景的难点在于需要综合利用不同时间粒度的数据,包括天级环境观测信息与毫秒级结构监测数据。在演讲展示的实验中,经过协变量引入和小样本微调,模型预测误差降低至10%以内,体现了时序基础模型结合领域数据开展专业场景适配的应用潜力。
另一个案例是面向电池组的异常预警。团队将基于时序分类数据预训练的模型适配到实际异常检测任务中,并设计了可调节的预警窗口,使模型能够根据不同异常类型和业务需求,设置不同的提前预警时间。在演讲介绍的实验中,模型在提前5分钟以上的预警窗口下,取得了平均85%以上的异常预警准确率。
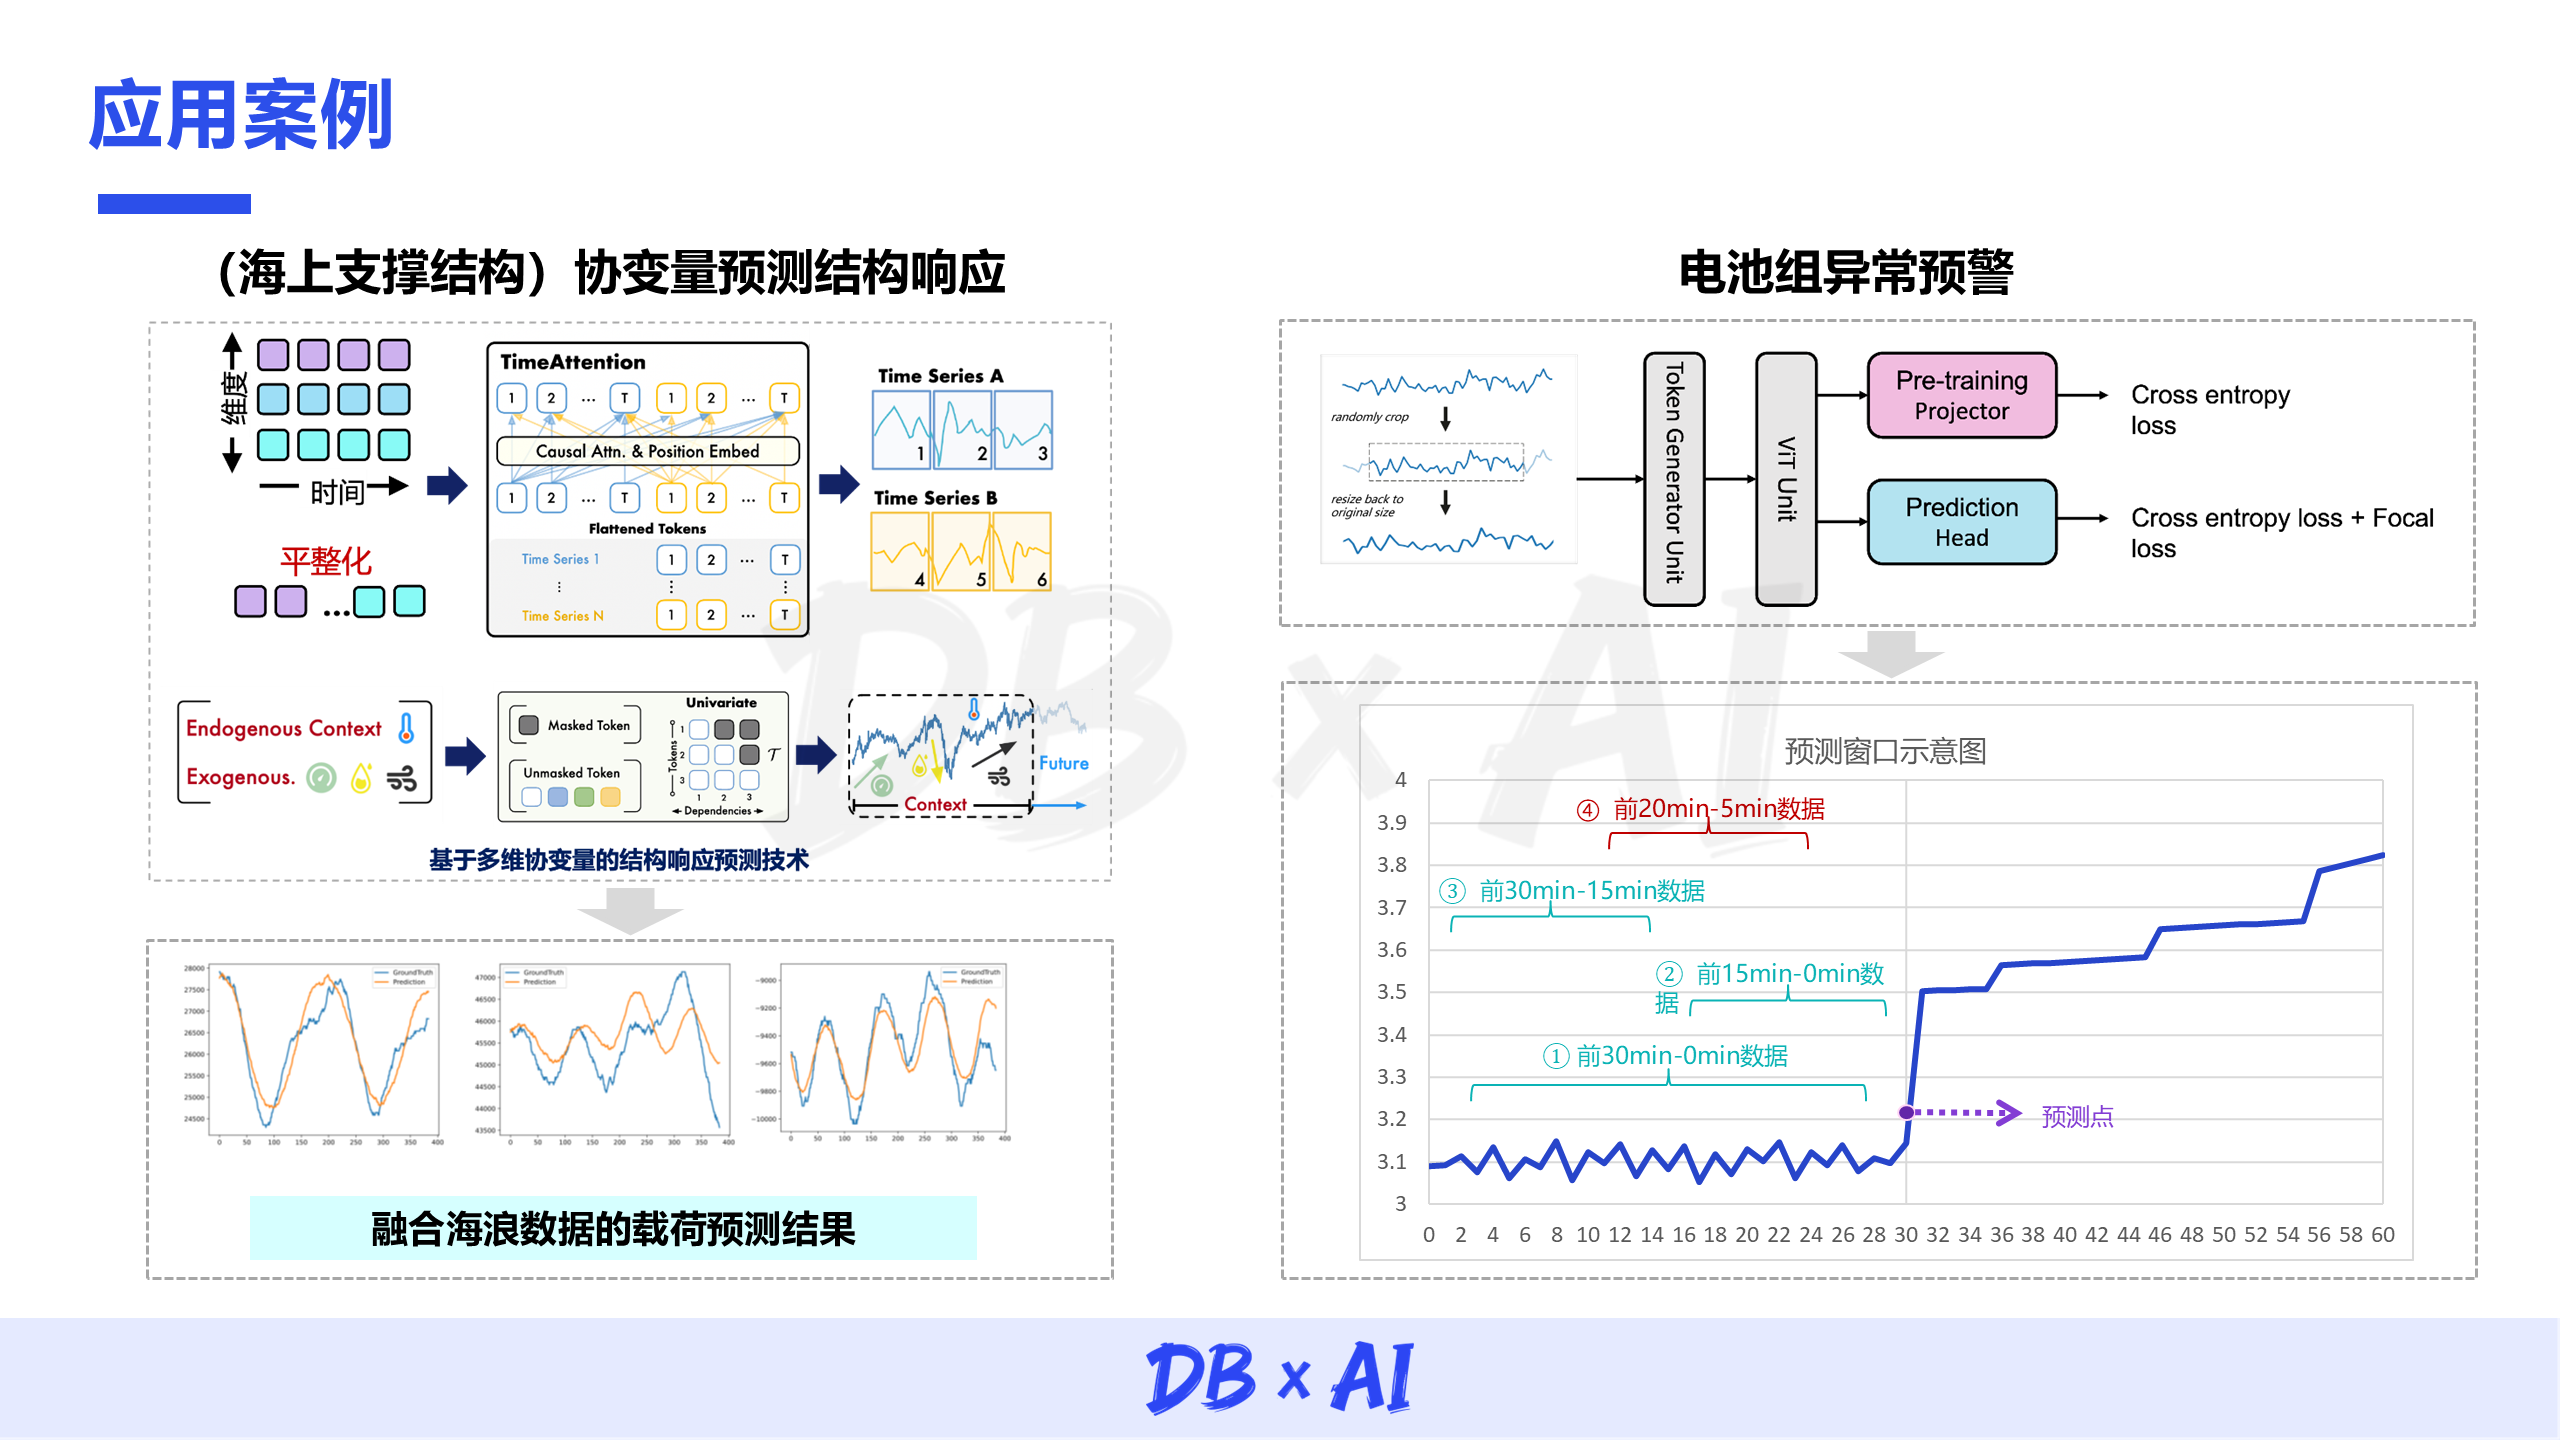
海上支撑结构预测与电池异常预警的初步实践,展示了相关技术在工业应用中的潜力。随着时序基础模型能力不断发展,如何进一步降低场景适配成本、增强模型对真实数据复杂性的适应能力,让企业在生产环境中把时序数据预测的价值充分发挥出来,仍将是推动时序大模型应用的重要研究方向。
Reference
[1] 持续学习方法 ORTCL:Lin L, Zhang X, Zhang Q, Wang S, Xia K. ORTCL: Towards Continual Learning of Time Series Foundation Models on Streaming Data via Orthogonal Rotation[C]//Proceedings of the AAAI Conference on Artificial Intelligence. 2026, 40(28): 23541–23549.
[2] 时空预测框架 ProST:Xia K, Lin L, Wang S, Zhang Q, Wang S, He T. ProST: Prompt Future Snapshot on Dynamic Graphs for Spatio-Temporal Prediction[C]//Proceedings of the 31st ACM SIGKDD Conference on Knowledge Discovery and Data Mining V. 1. 2025: 1645–1656.
[3]时间感知大模型 UniTIMS:Lin Z, Lin L, Zhang Q, Xia K, Wang S, Qiao J. A Hybrid Attention Model Learning Unified Time-aware Patch Representation for Irregular Multivariate Time Series Forecasting[EB/OL]. 2026. arXiv:2609.22836.


