


编者按:
在 2026 时序数据技术创新大会上,来自产业一线的实践经验成为重要议题。
随着工业物联网、智能制造等场景的测点数量爆发式增长,写入吞吐和查询复杂度持续攀升,如何在写入性能、查询稳定性与资源成本之间取得平衡,成为每个数据库应用者必须直面的难题。当业务负载加了,吞吐却涨不上去;当集群节点不少,性能却卡在瓶颈——调优,到底该从何入手?
天谋科技数据库内核研发工程师、TimechoDB 项目交付负责人曹志佳,结合本人超过 5000 套项目的交付经验,从调优原理出发,分享时序数据库性能问题的定位思路与实践路径。
调优的“元问题”:加机器、调参数,还是束手无策?
今天想跟大家聊一个很“接地气”的话题——性能调优。准确地说,是 IoTDB 性能调优的底层逻辑和实战路径。
在实际项目中,有以下三类问题是客户经常反馈的:
“我都加机器了,写入性能怎么还是很慢?”
“机器配置已经很好了,写入吞吐怎么还这么差劲?”
面对查询性能问题,又应该从哪里开始排查?
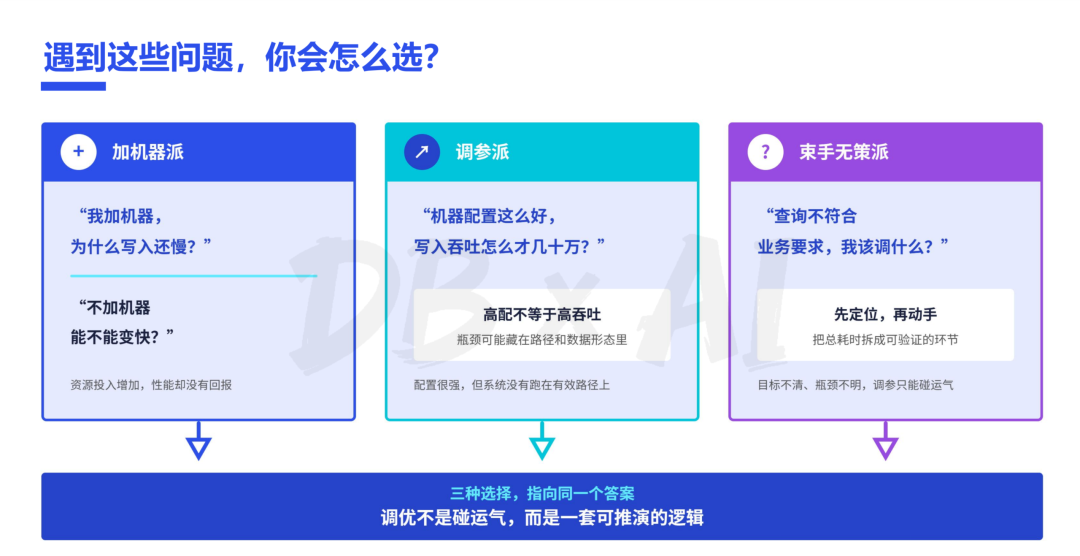
这些问题看似不同,背后却有共同规律。性能调优不是简单寻找一个“最佳参数”,而是要建立一套从现象出发、回到原理、再用验证闭环的方法。
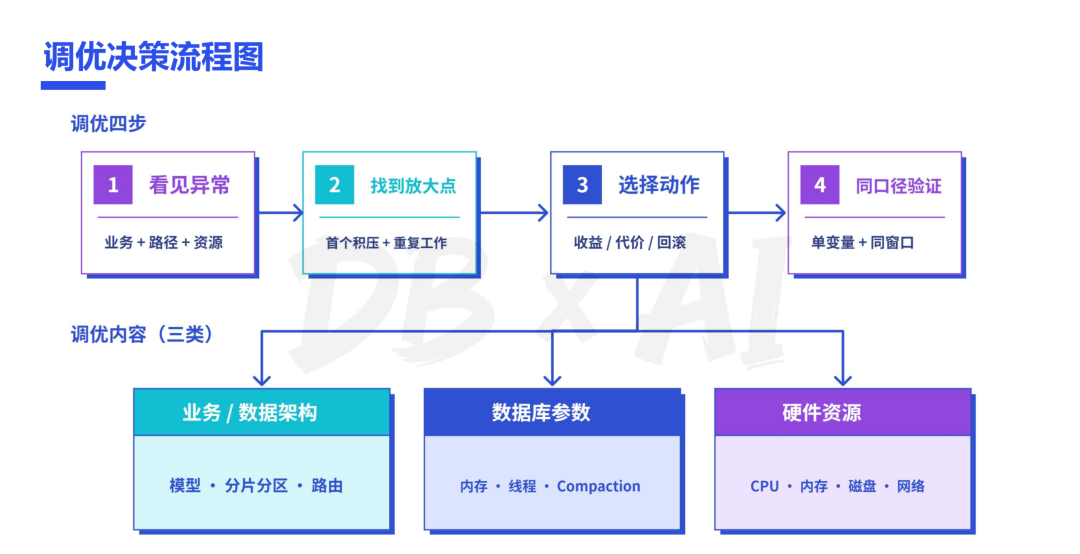
那具体要怎么梳理呢?我替大家整理了一套关于调优决策的流程图,在这里我把其归纳为两个问题:怎么调,以及调什么。
怎么调,可以概括为四个步骤:
发现异常——从业务视角(写入延迟升高)或资源视角(磁盘告警、CPU告警)捕捉信号。
找到拐点——几乎所有性能问题都有一个“拐点”,系统从平稳突然恶化,那个时间点就是关键线索。
选择动作——决定采用哪种调整手段。
控制变量验证——一次只改一个变量,看是否达到预期。
调什么,通常包含三类:
调业务/数据架构——比如建模是否合理?
调数据库参数——通用参数不可能适配所有场景。
调资源——前两者都没问题,那是不是资源达到瓶颈了?
从工作负载到硬件资源,建立分层判断
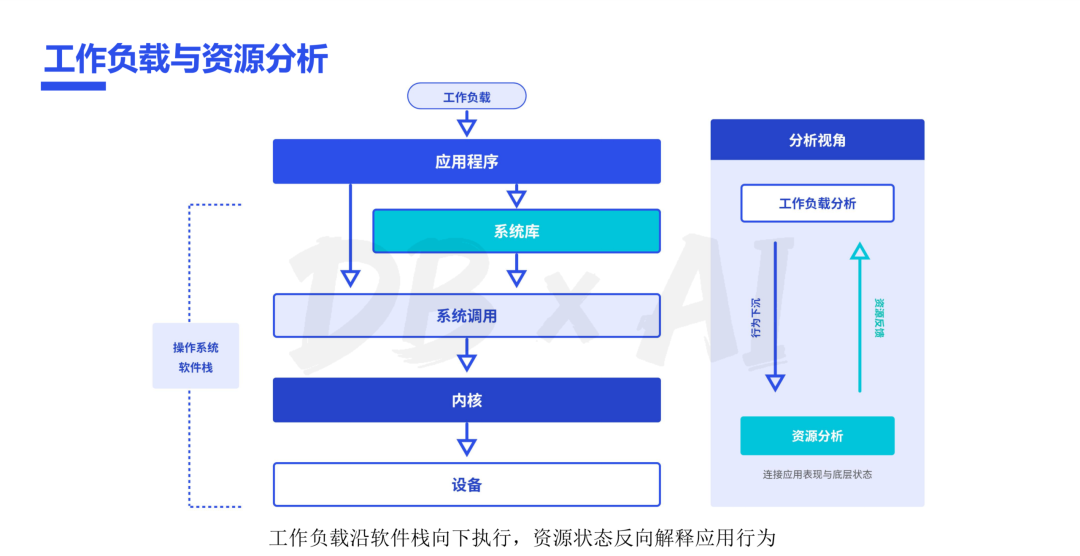
无论架构多复杂,都可以抽象成一层关系:工作负载 → 应用程序→ 系统调用 → 硬件设备。
工作负载是沿着软件栈自上而下流动的,而资源的状态可以反向解释应用的行为。调架构,本质是调工作负载;调参数,是在应用程序侧调查询引擎和存储引擎;调资源,就是调底层的CPU、磁盘、内存、带宽。
将工作负载和应用程序的小模块再往下拆,我们可以把交付简化为客户端-服务端模型。
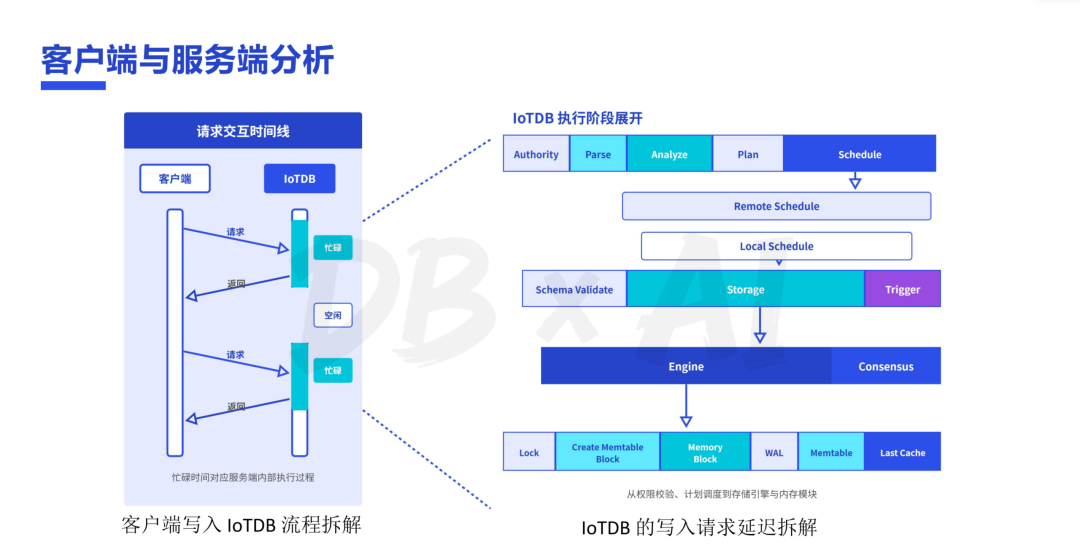
这种时候有两种情况:
如果客户端大部分时间空闲,服务端一直繁忙,那瓶颈大概率在服务端。此时我建议优先从资源入手——先看硬件有没有瓶颈,硬件没问题再反向分析软件。反过来,如果客户端本身有瓶颈,就去优化客户端的代码或资源。
怎么判断硬件有没有瓶颈?四个监控维度
我们官方提供了配套的监控工具,可以从四个维度看关键资源:
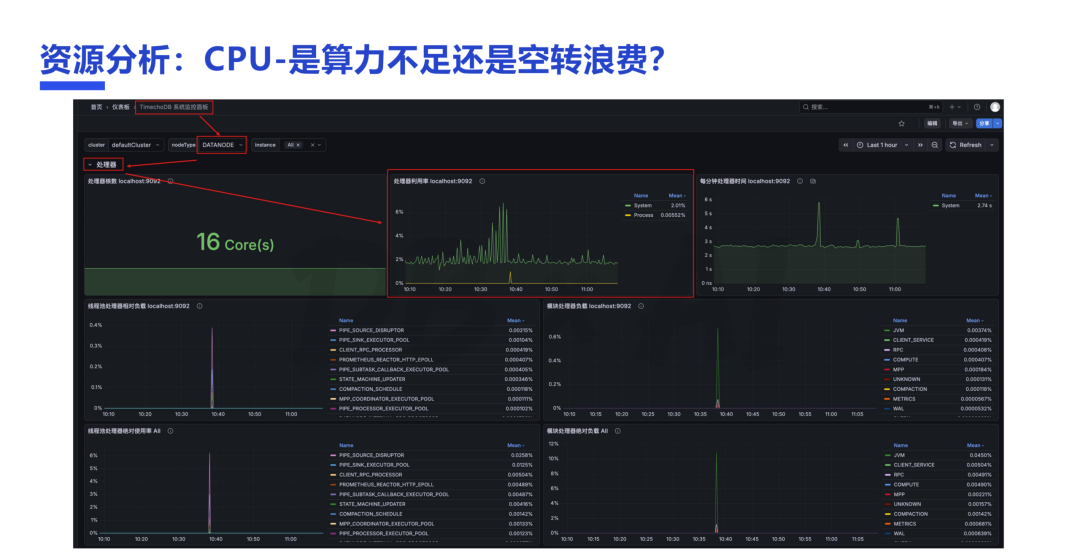
CPU:系统资源面板里的处理器利用率,如果长期超过 80% 甚至 90%,基本可以断定 CPU 触顶。
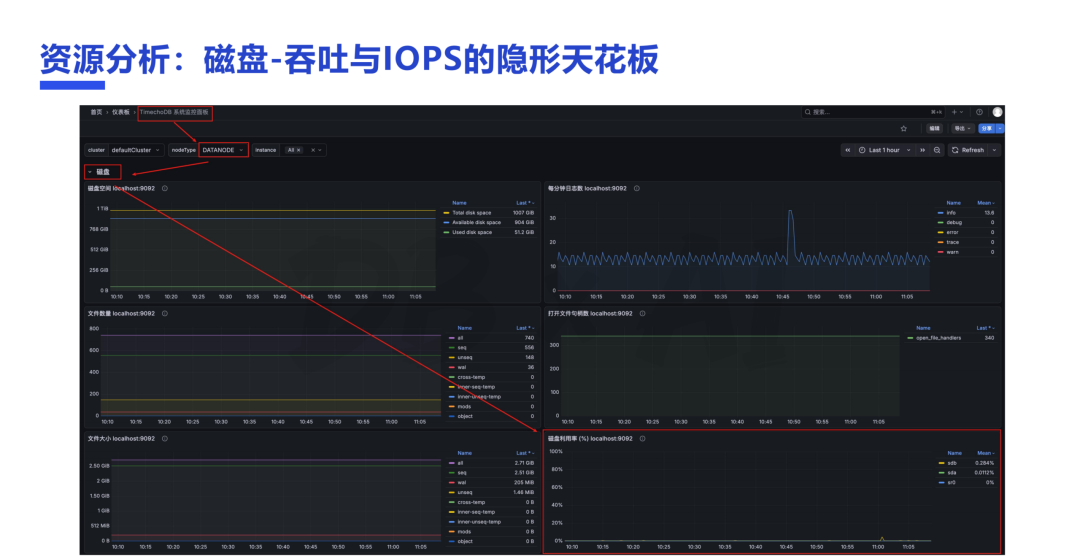
磁盘:这是最容易出现问题的模块。磁盘利用率持续高于 80% 或 90% 时,写入和查询性能会直接下滑。
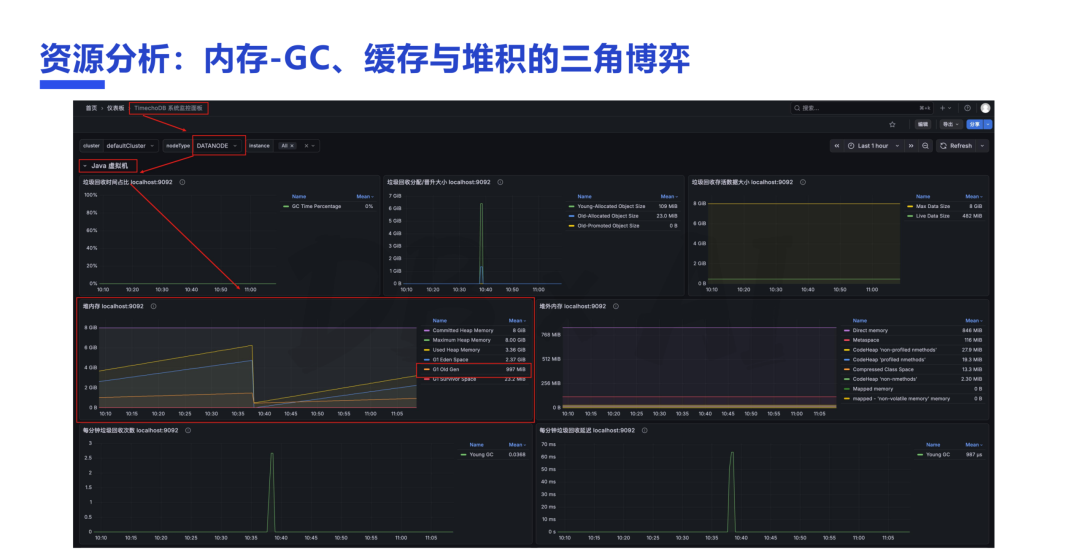
内存:IoTDB 是 Java 生态的软件,所以要看 JVM。重点观察 JVM 老年代水位线——持续低位算正常;如果持续高位且 GC 非常频繁,就该想办法调整内存参数。
带宽:这是最容易被忽略的。如果业务场景“读也大、写也大”,一定要评估带宽秒级吞吐是否满足要求。带宽出问题,后果很隐蔽但很严重。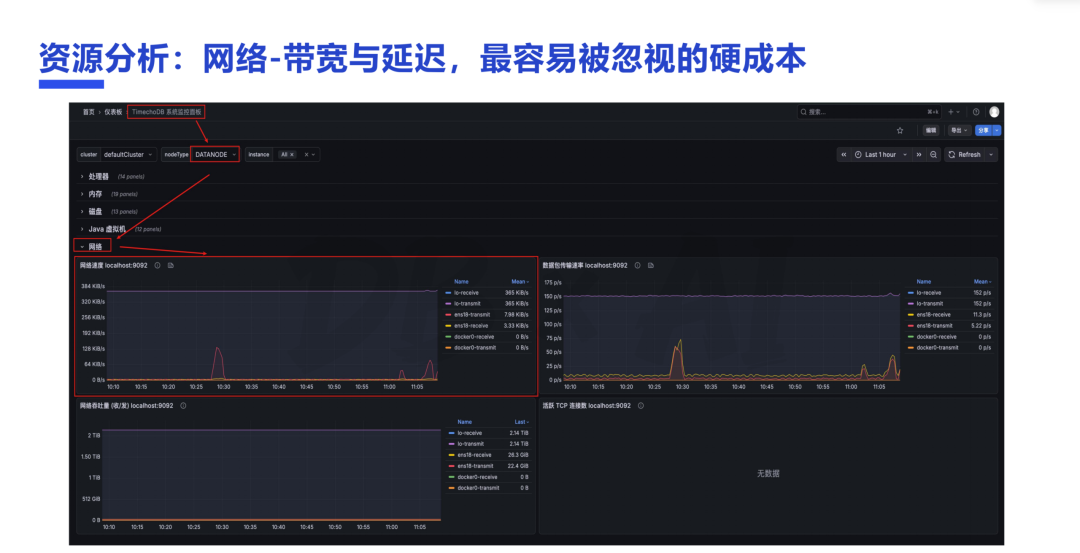
实战沙盘:调业务、调参数、调资源的三维战场
这个章节带大家感受一下实战的原理,通过不同的场景,看看怎么分析。
案例一:负载加了,吞吐为什么不涨?
在一个项目中,MQTT 作为数据源,向 IoTDB 写入数据,数据经过网闸、防火墙传到办公网。业务不断增加负载,但吞吐上不去,延迟堆了好久,通过排查监控发现,对外内存也在持续上涨,而这个点就是一个异常的拐点。
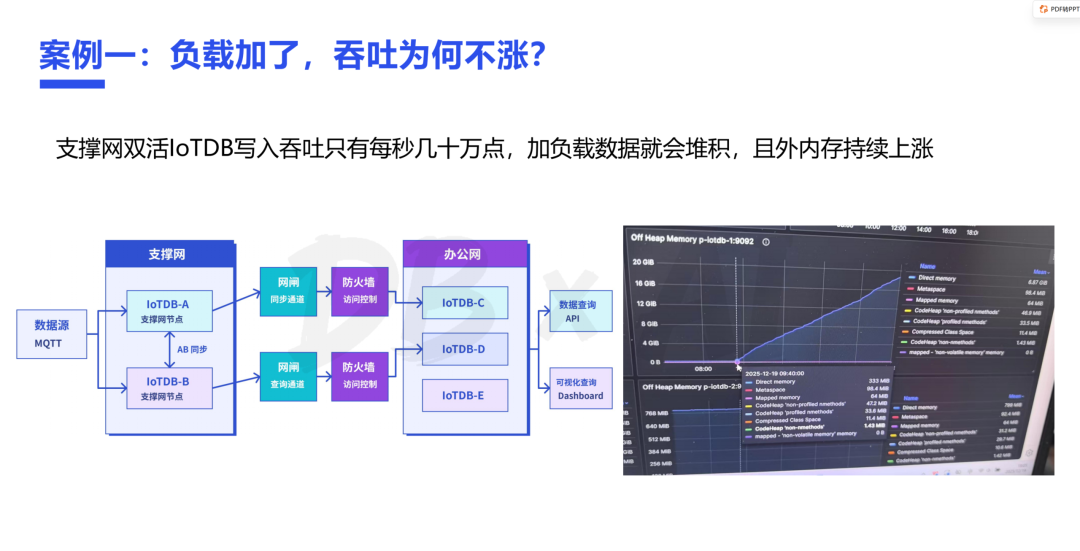
怎么分析?MQTT 底层是一个无界队列,请求数据占用的就是对外内存。对外内存持续上涨,首先考虑消费能力跟不上生产能力。但当我们将 MQTT 的消费线程调到非常高(如 32 并发)还不行,那就只能怀疑数据库本身了。
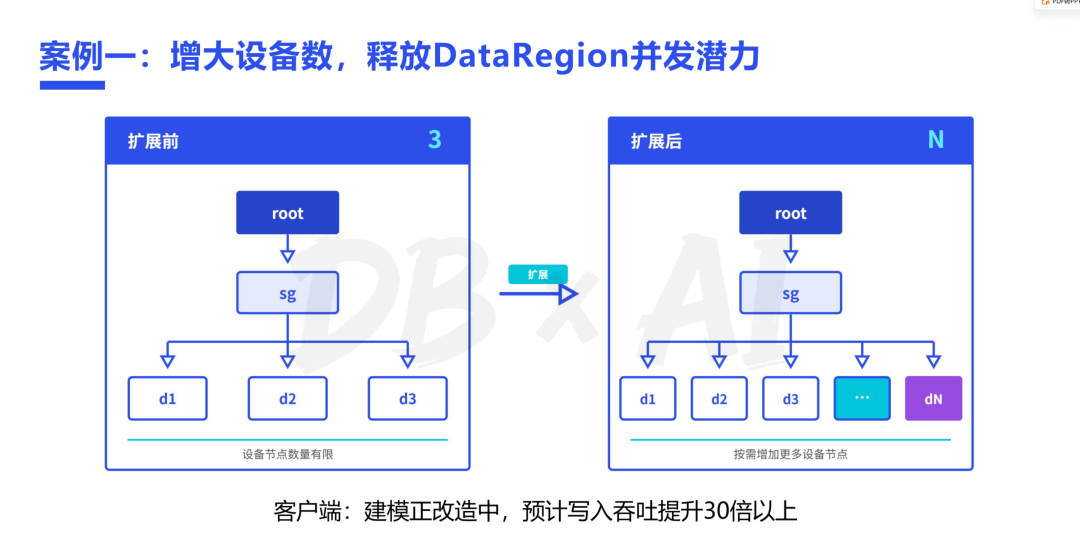
这里引出 IoTDB 的一个关键概念——数据分区(DateRegion)。它是 IoTDB 并发读写的原子单元,分区越多,并发读写能力越高。所以,我们首先想到的是 DateRegion 太少了,后来经过验证也确实如此。我们发现客户用数据模引擎建模,10 万个传感器只建出了 3 个设备。
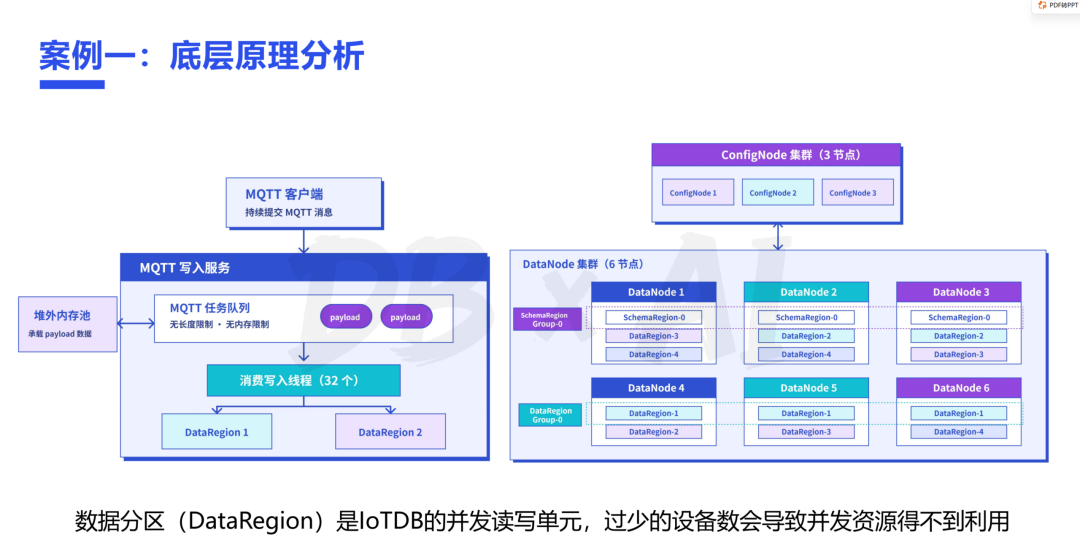
而这也涉及第三个知识点:设备数量与 DateRegion 数量是成比例关系的——3 个设备最多只有 3 个分区,即便数据库有 192 核,能发挥的并发也只有 3 。
优化方案:改建模——把设备数量从 3 个提升到 100 甚至 1000 个。并发能力上来后,写入吞吐预计能提升 30 倍以上。这就是典型的调业务架构。
案例二:三节点集群,吞吐为什么只有50万?
这也是一个典型的写入调优问题。一个架构的三节点 IoTDB 集群,配了多级存储,写入链路有 Kafka 实时写入和 OTS 离线迁移。离线数据转成 TsFile 后加载入库。
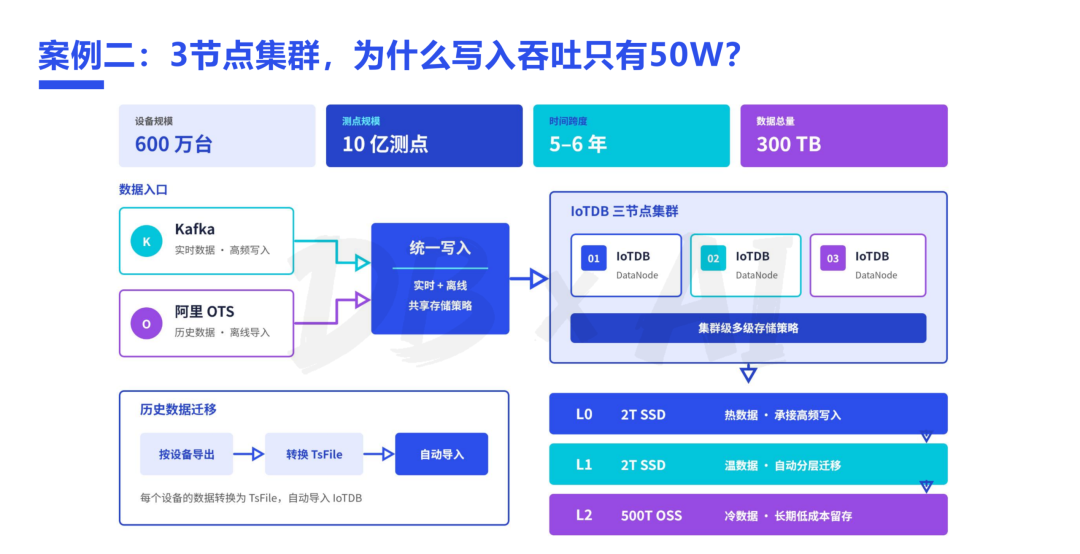
问题来了:离线数据开始迁移后,文件数指数级上涨,几天就超过 1500 万,操作系统都快扛不住了;同时 Full GC 超长,平均一分钟大概有十几秒甚至 20 秒的负 GC。系统基本不可用。
我们追根溯源:文件数太多,本质是 TsFile 太多。TsFile 由存储引擎触发 Flush 产生——内存持有率达到一定数值(如默认为 85% 时)刷盘。又一个知识点:刷盘生成的文件个数,与存储引擎中同时活跃的时间分区有关。客户迁移场景会跨越数年数据,而 IoTDB 默认时间分区是 7 天,于是迁几年大概会有上千个活跃分区,每次刷盘生成几千个文件,这也是产生文件过多的原因。
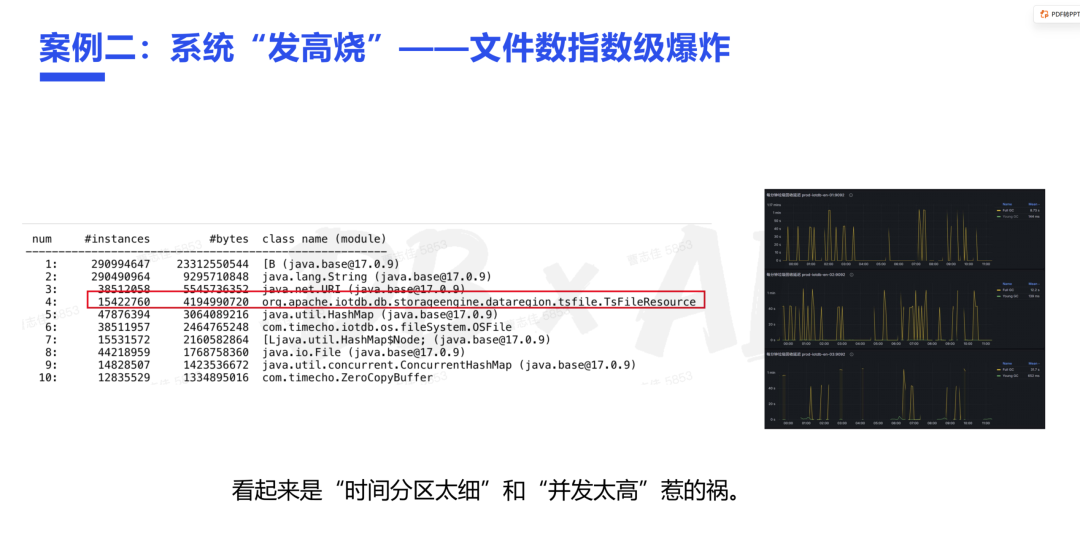
基于此,我们做了两个优化点:
调大时间分区——从 7 天调到 1 个月甚至更长,分区数量降下来,文件数减少数倍。
加速合并(Compaction) ——让系统把小文件合成大文件。
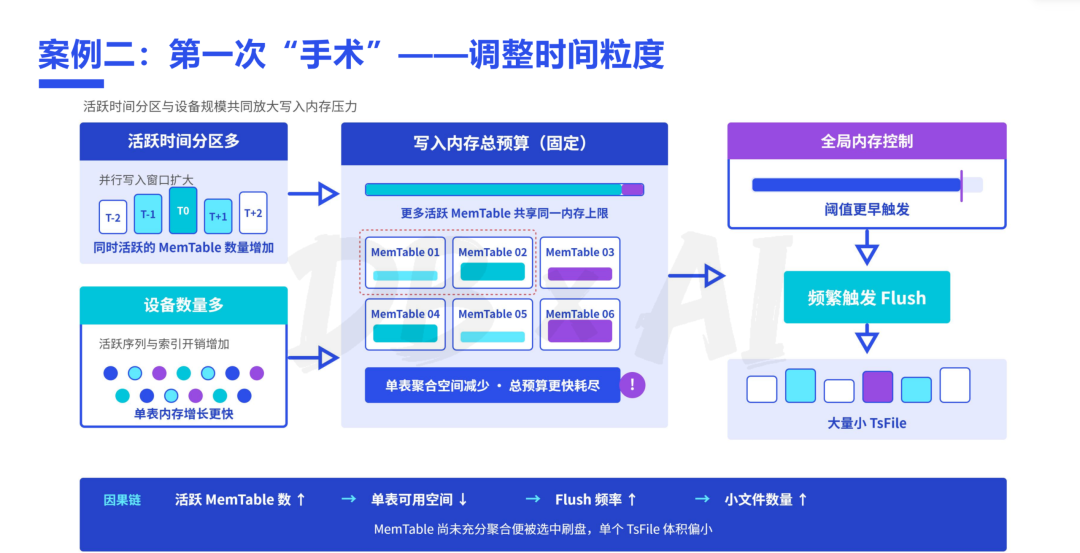
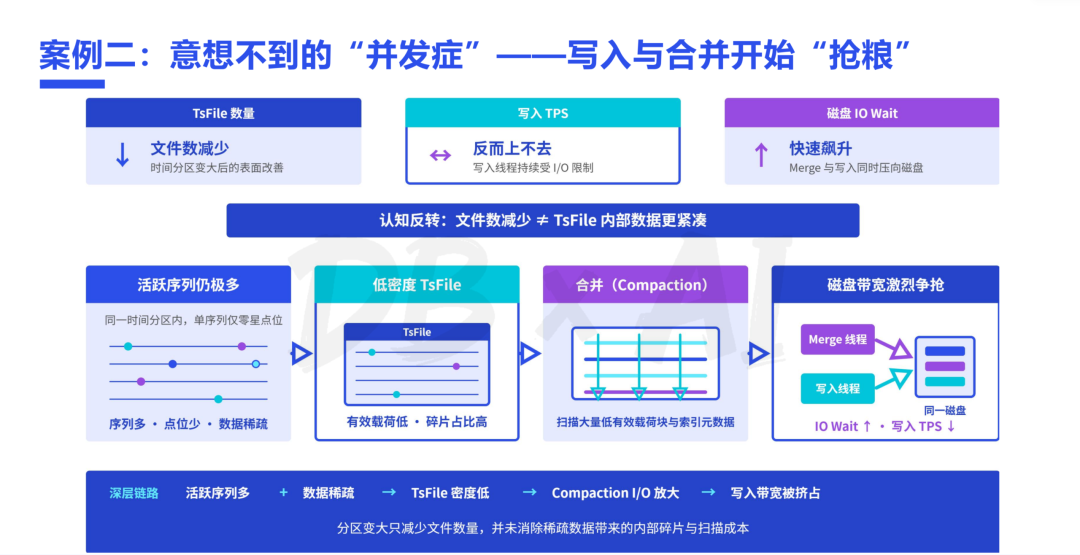
但调整后吞吐反而更差了。我们回到资源分析,发现磁盘 I/O 被打满,利用率接近 100%。谁在抢资源?合并在占。更糟的是,合并出来的文件有效信息比极低。TsFile 包含数据区和索引区,合并后数据区只有百分之几的有效信息,大部分是冗余数据。针对原因分析是大宽表场景下,每个序列只有零星几个点,刷盘时数据密度太低。
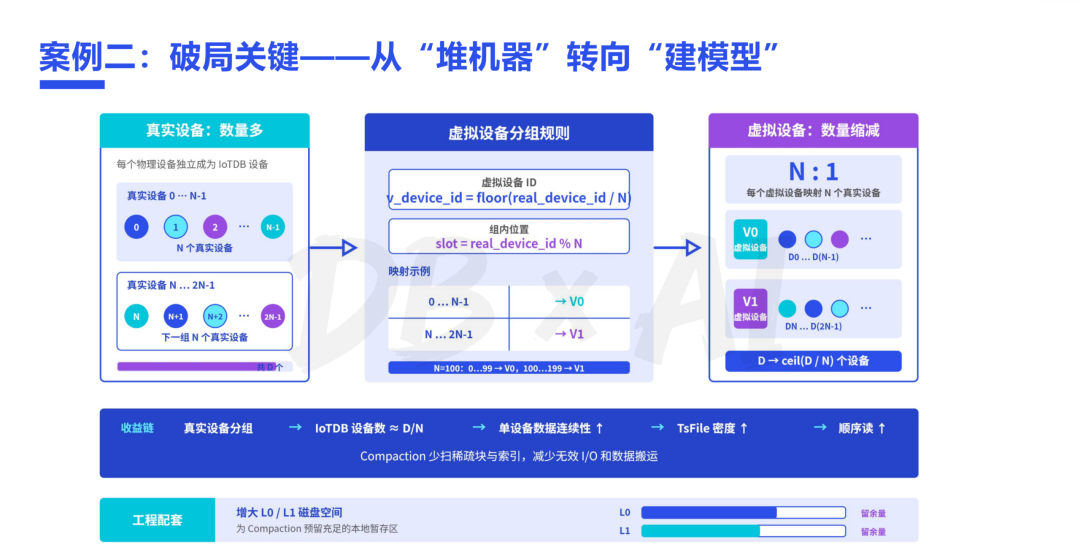
这时候我们做了核心优化——改建模即序列融合。核心理念是:把真实的物理设备的数量降下来。在系统内部维护一个虚拟设备,让一个虚拟设备对应一批真实物理设备(比如1:100),真实设备数量下降 100 倍,刷盘时 TsFile 的有效信息比大幅提升。这一招让吞吐从几十万直接飙升到 2000 万左右。
但这还没完。多级存储(两层SSD+一层OSS)下,客户离线数据有几百 T,但前两级存储只有 4 个节点,伴随着迁移速度快,文件可能还没来得及合并就被卸载到第三级,小文件依然很多。
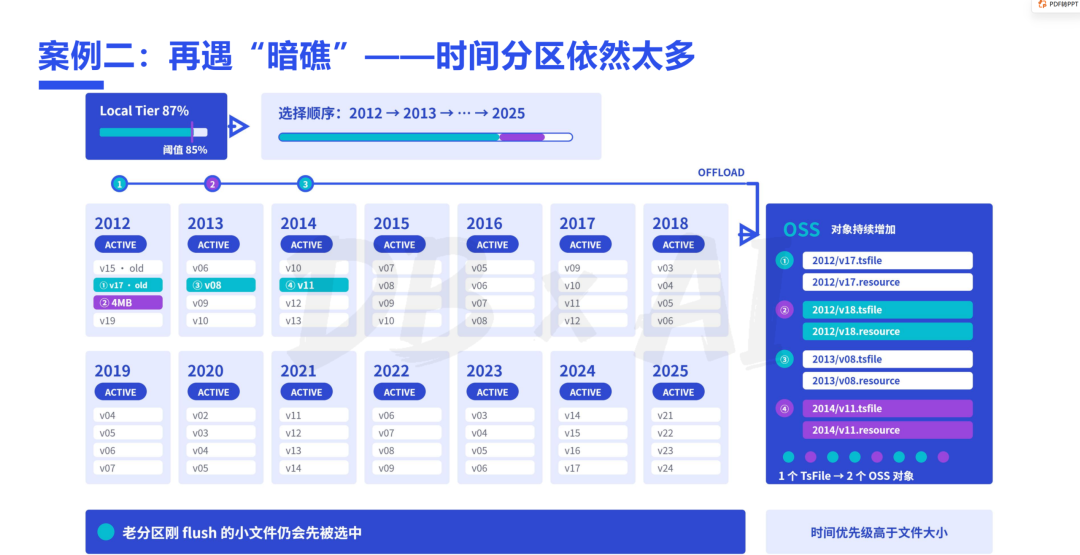
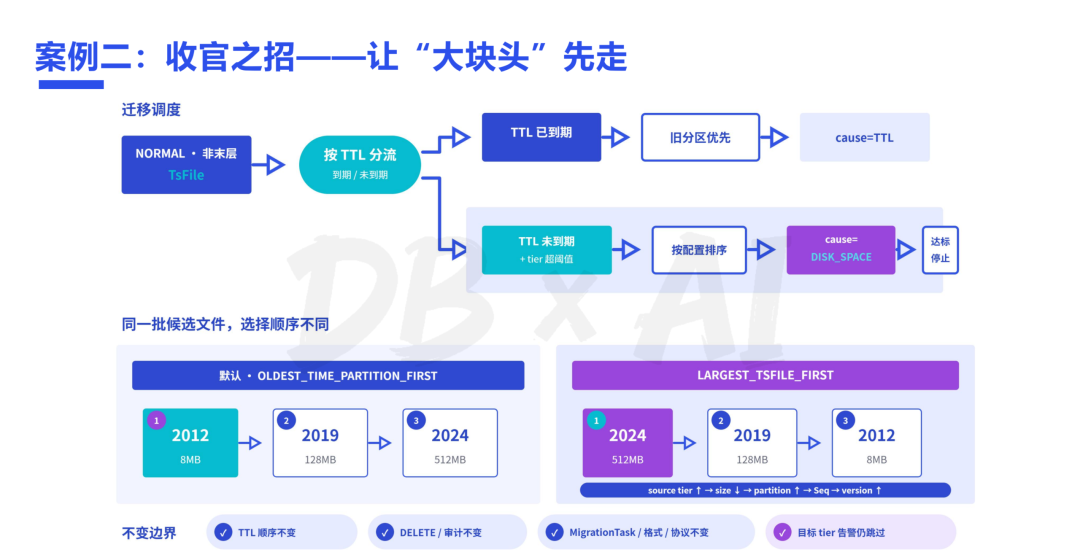
我们又调整了卸载策略——优先卸载大文件,同时调整合并策略,优先合并老时间分区的数据,让 TsFile 尽可能变大。组合拳打下来,最终吞吐从最初的 55 万涨到 4000 万,文件数也进入稳定增长状态。
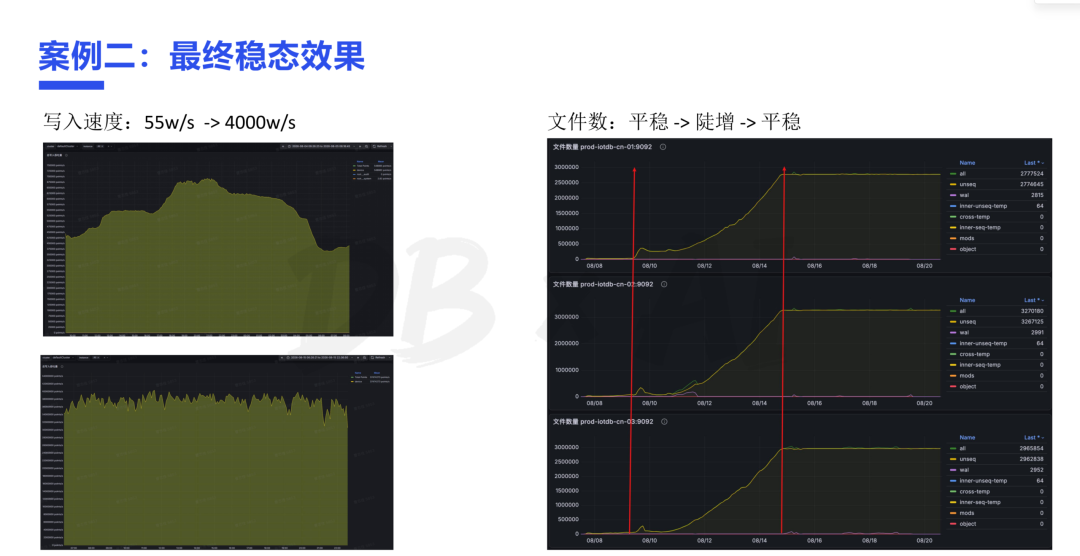
这个案例最综合——调了建模、调了参数、还调了策略。
案例三:万兆带宽,为什么 200 并发查询跑不进 2.5 秒?
最后一个案例,容易被忽略的带宽。
项目配置:万兆网卡,三节点 IoTDB,200 并发查询,业务要求 2.5 秒内返回,但成绩始终上不去。
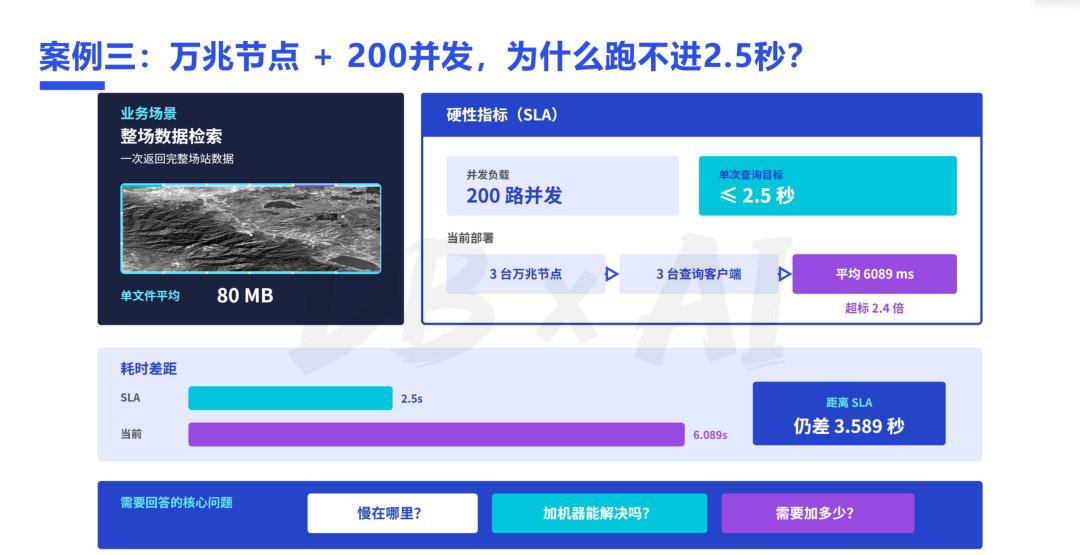
我们算了一笔账:如果说满足 200 并发,平均延迟 2.5 秒的话,每次查询返回的文件大约 80 MB,200 并发意味着原始数据量达到 16 GB/秒,数据量非常庞大。2.5 秒要拆给磁盘 IO、网络传输、客户端解码三块。即使各分 1 秒、1 秒、0.5 秒,万兆带宽(单节点约 1.25 GB/s)也远远不够——三个节点加起来才 3.75 GB/s,离 16 GB/s差太远。
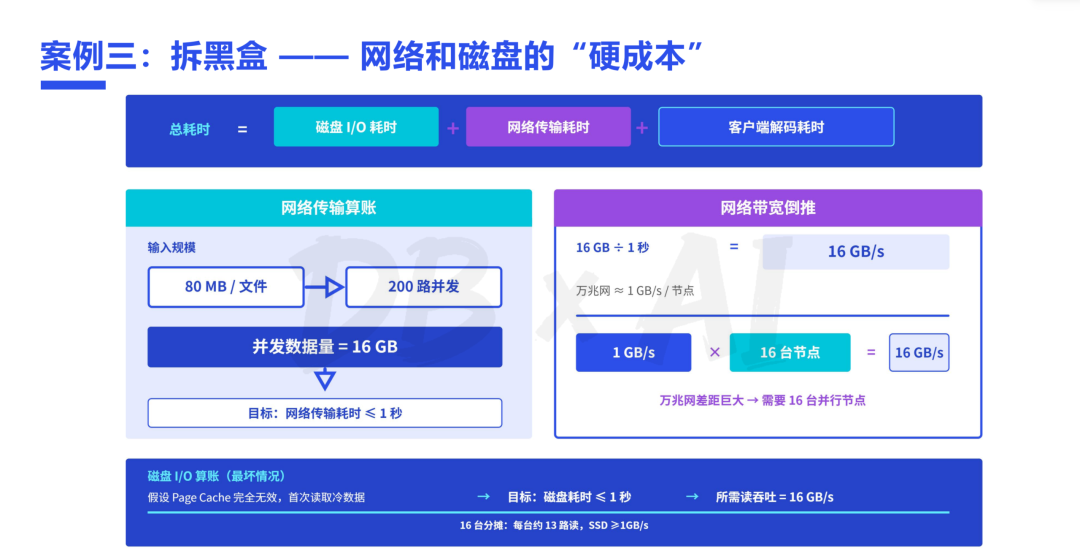
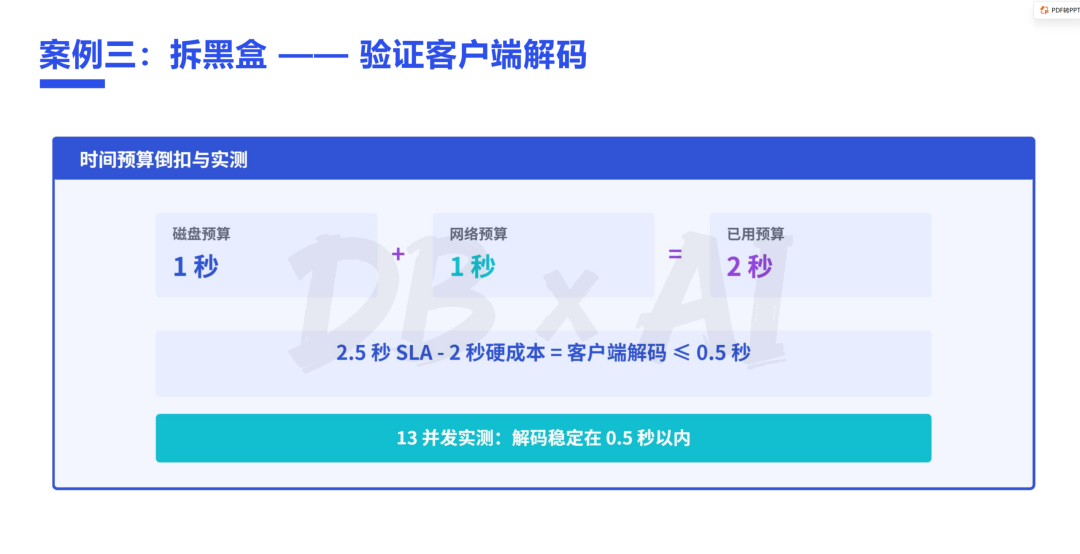 这个问题的本质是硬件先天不足,软件再怎么调也没用。最终方案就是加服务器,数据库数量也从 3 节点扩展到 16 个节点,保证带宽和磁盘性能都达标,留给客户端解码的 0.5 秒也通过实测验证稳定通过。
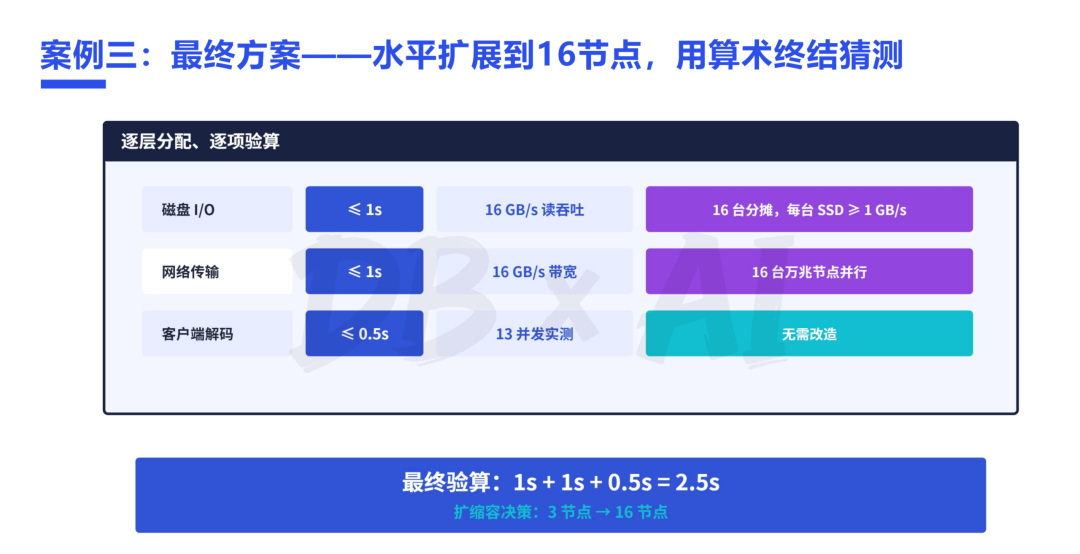
这就是典型的调资源,而且是调最容易忽略的带宽资源。
总结:调优的三板斧
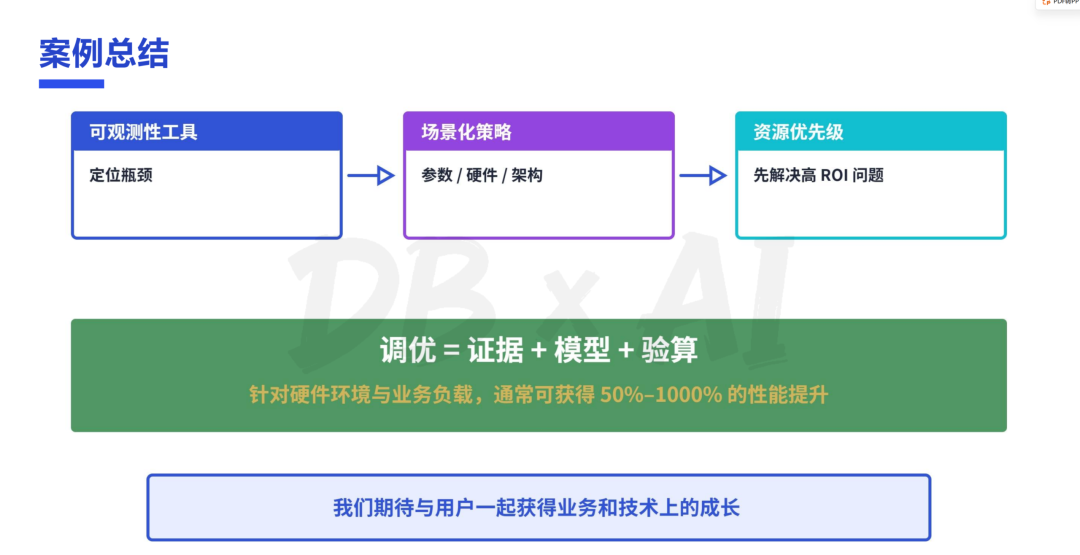
回顾以上三个案例,我们把调优方法论凝练成三个组合:
可观测性工具——帮我们精准定位瓶颈在哪儿。
对原理的理解——决定我们要制定什么样的调优策略。
资源优先级决策——有些东西改变不了,就先解决收益最高的问题。
经过这些沉淀,我们发现调优的效果可以从 50% 到 1000%,甚至更高。如果大家在真实项目中遇到性能难题,欢迎随时和我们探讨。
 我们期待与用户一起获得业务和技术上的成长。


