


编者按:
在 DB × AI 融合的浪潮之下,大模型能力飞速迭代,但很多企业却面临现实困境:AI 模型很强大,却很难真正读写、分析时序数据库中的业务数据。AI 会聊天,却用不动时序数据库。
在 2026 时序数据技术创新大会上,天谋科技全栈研发工程师、Apache IoTDB PMC Member 王旋围绕大会主题 「DB × AI」,聚焦数据库与 AI 之间的最后一公里,分享 TimechoDB、TimechoAI、TimechoCLI 智能工具的整套解决方案,直击时序数据库与 AI 结合落地的现实难题,让 AI 模型真正具备操作时序数据库的能力。
当下大模型的对话、理解能力已经达到较高水平,但在时序业务场景中,AI 却很难直接使用时序数据库内的数据。这中间横亘着三道现实的坎:尚未搭建可用数据库、拥有数据之后 AI 不懂时序业务、具备 AI 模型之后无法直接操作数据库。这三重障碍,也是 DB 与 AI 融合落地过程中最容易被忽略的现实痛点。
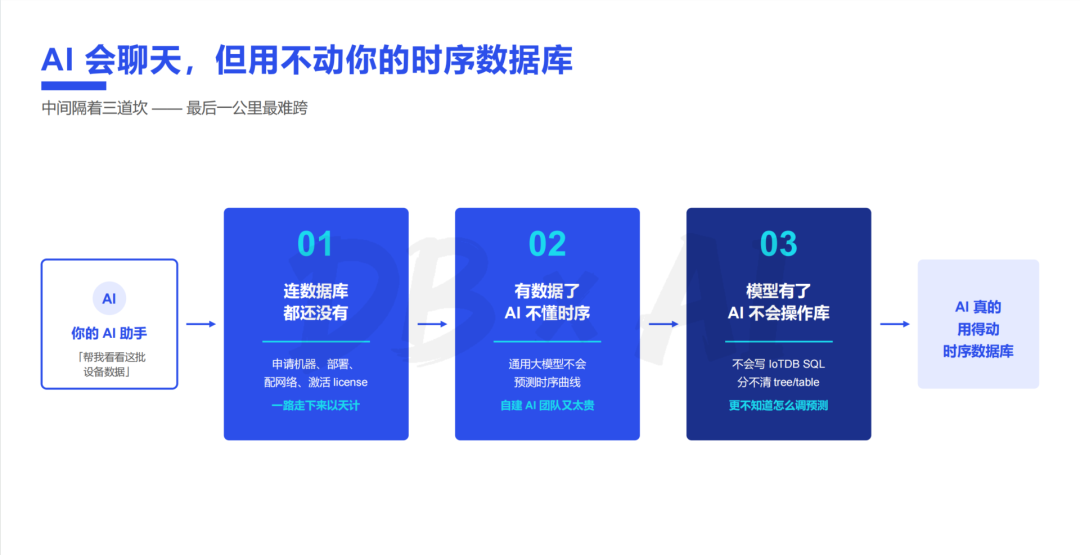
第一道坎:没有可用的数据库
过去,如果想搭建一套数据库通常需要经历申请机器、获取安装包、完成配置、申请许可证等多个环节。在部分环境中,还需要通过人工方式逐项完成部署,整个过程往往以天为单位计算。
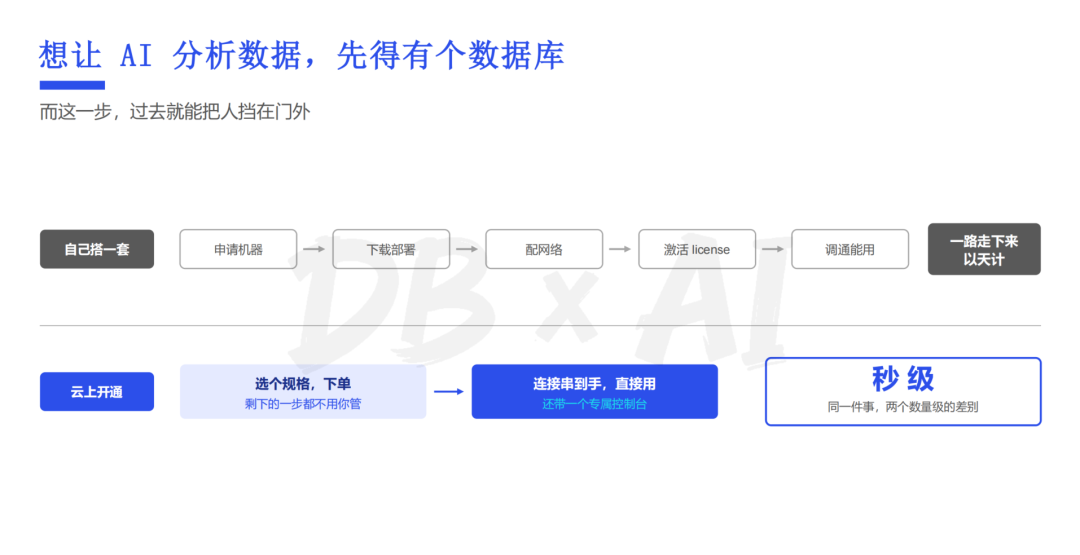
针对这一痛点,TimechoDB Cloud 版本实现了体验的革新。用户仅需要选择业务所需规格完成下单,系统自动化完成后续全部流程,半分钟以内即可完成一套 TimechoDB 实例的创建。实例创建、初始化、License 激活全部自动化完成,无需人工干预。
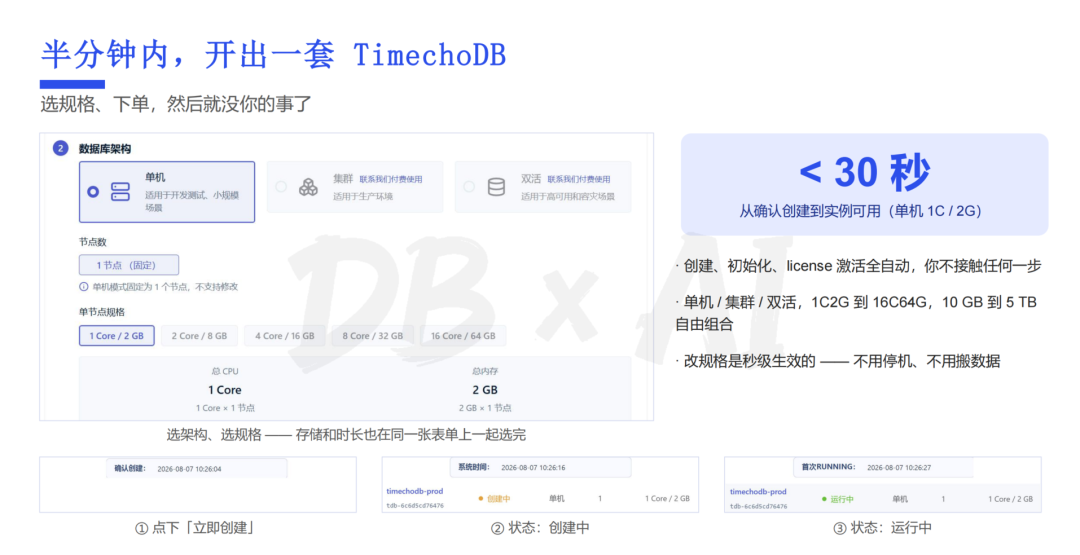
欢迎访问 db.timecho.com 试用 TimechoDB 云服务
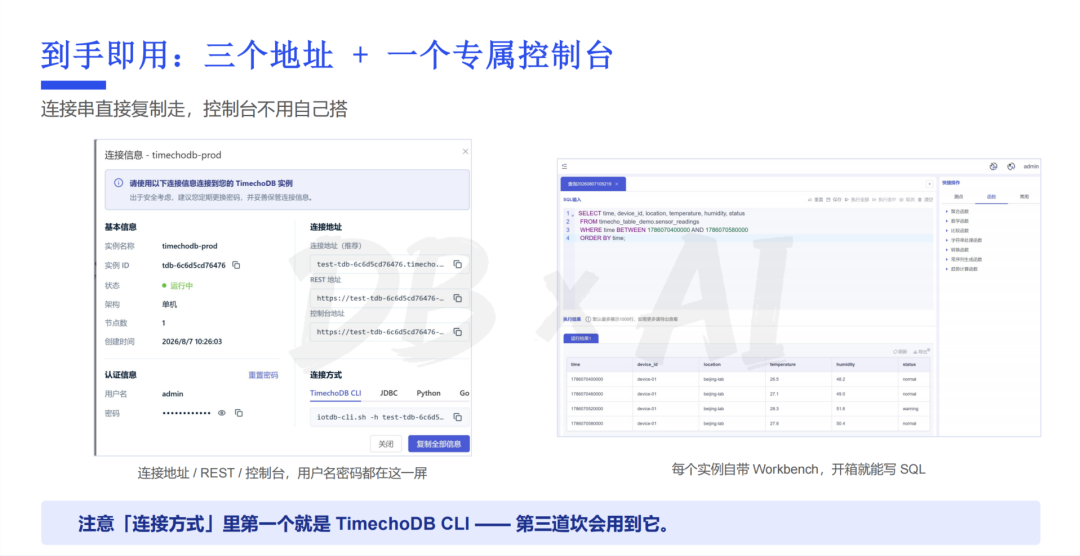
实例支持单机、双活、集群多种架构,配置规格可自由组合,从测试小规格到生产大规格均可按需选择。规格变更实现秒级生效,变更过程无需停机,不会改动原有生产数据。实例开通后,连接地址、REST 地址、控制台地址和账号密码都在同一屏,复制即可连接;每个实例自带专属 Workbench,开箱就能写 SQL。
针对云版本,用户可能会想我的数据安不安全,会不会存在和别人共享的问题呢?这正是我想分享的:
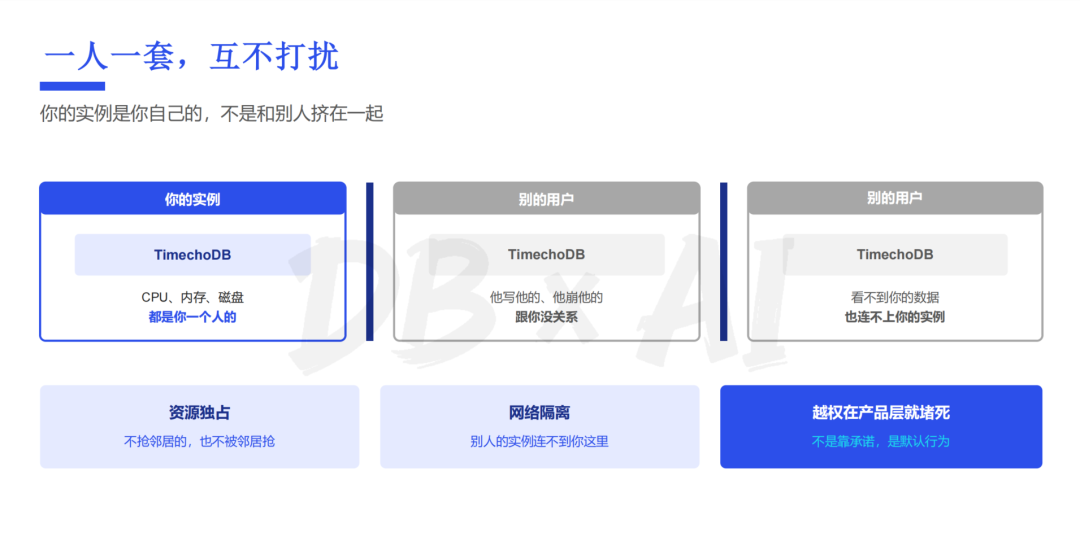
👉 安全层面,云上实例实现完整的资源独占。CPU、内存、磁盘资源完全归属于用户自身,不会与其他用户抢占资源;
👉 网络层面实现相互隔离,其他用户实例无法访问到本实例;
👉 产品底层逻辑上就完成权限隔离,这并非是我们的承诺,而是默认行为,充分保障用户业务数据安全。
第二道坎:已有数据,但 AI 不懂时序
即便已经拥有数据库与业务时序数据,通用大模型依旧难以胜任时序预测工作。通用大模型可以解读曲线特征,对时序现象给出文字层面的合理解读,但难以输出精准的时序预测数值。
如果选择自建 AI 团队解决时序预测问题,企业需要完成数据工程处理、特征设计、基座模型选型、模型训练、上线运维全链路工作,人力与时间成本高昂。同时模型存在场景局限性,更换测点、切换业务场景之后,原有模型效果往往失效,需要全部重新迭代。
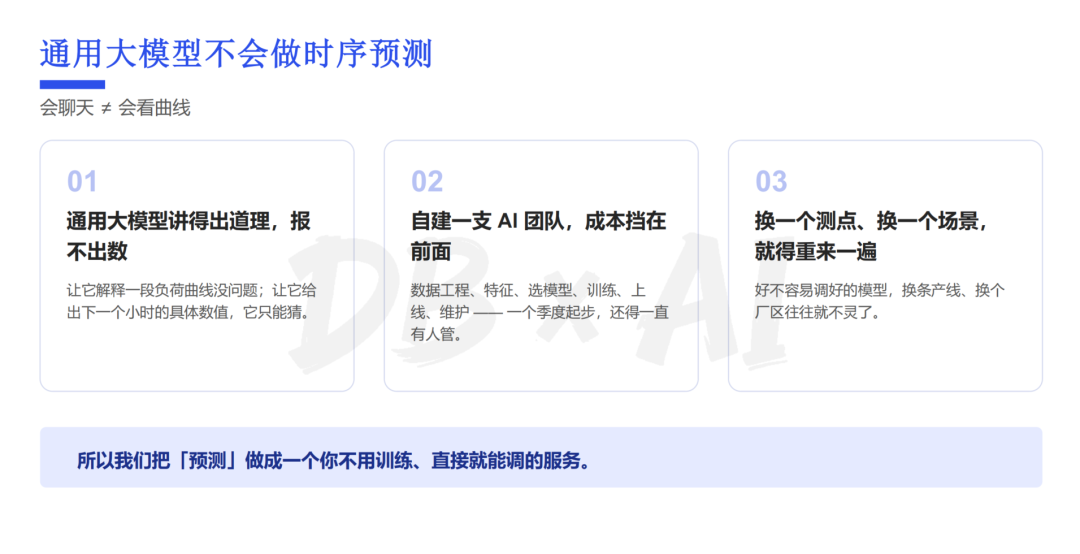
为此 TimechoAI 将时序预测封装为开箱即用的服务,支持零样本预测,无需训练、无需调参,输入数据即可输出预测结果。
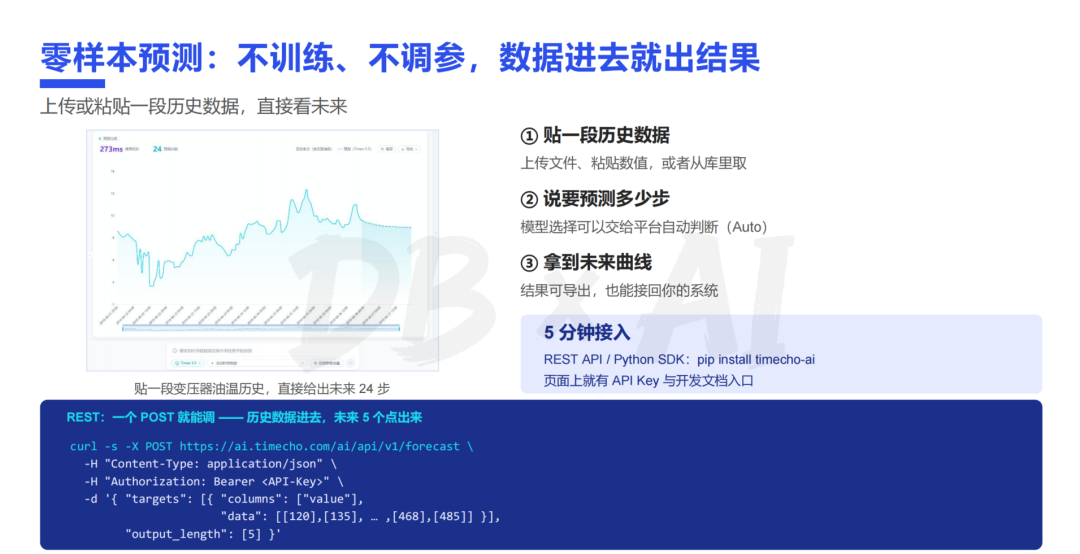
云版支持上传文件或粘贴历史数据;私有化部署下还可以直接从库里取数。模型既可以由平台自动择优选择,也支持用户手动指定;预测完成后,预测曲线可直接导出,也可以回写接入自有业务系统。API 接入流程简单,熟练情况下五分钟即可完成整套接入,通过简单的接口请求,传入鉴权信息与时序数据,就能够获取预测输出。
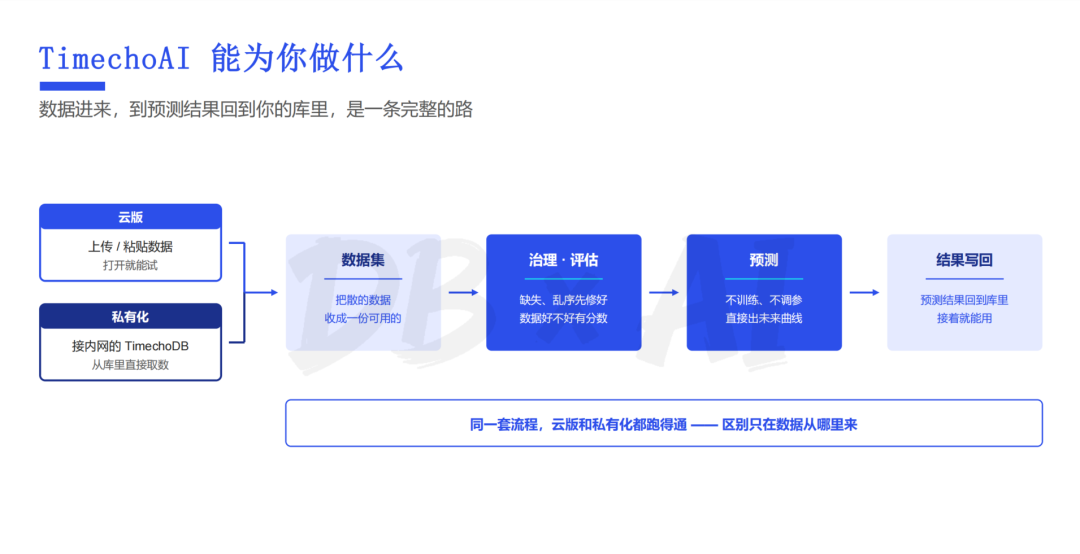
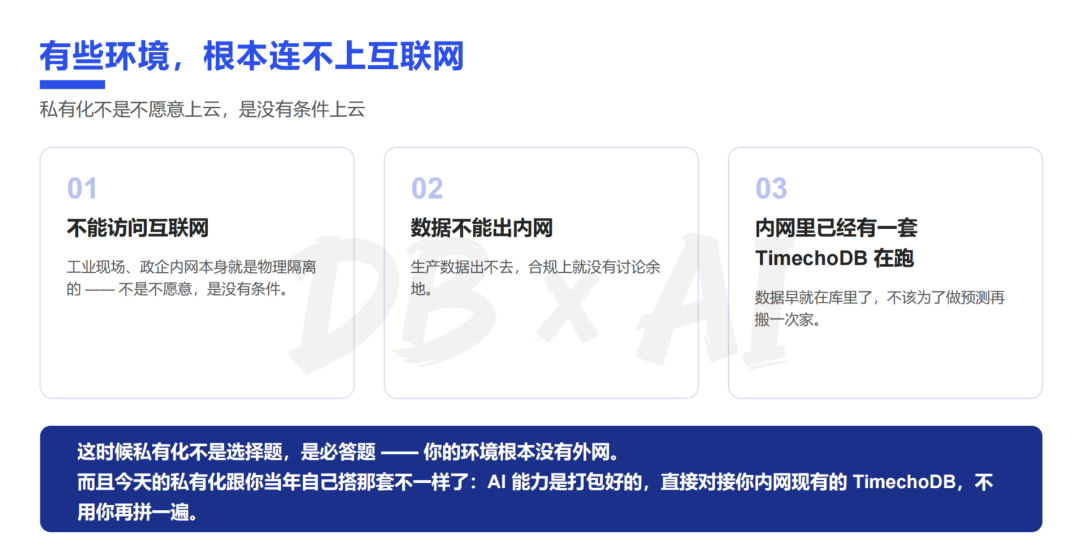
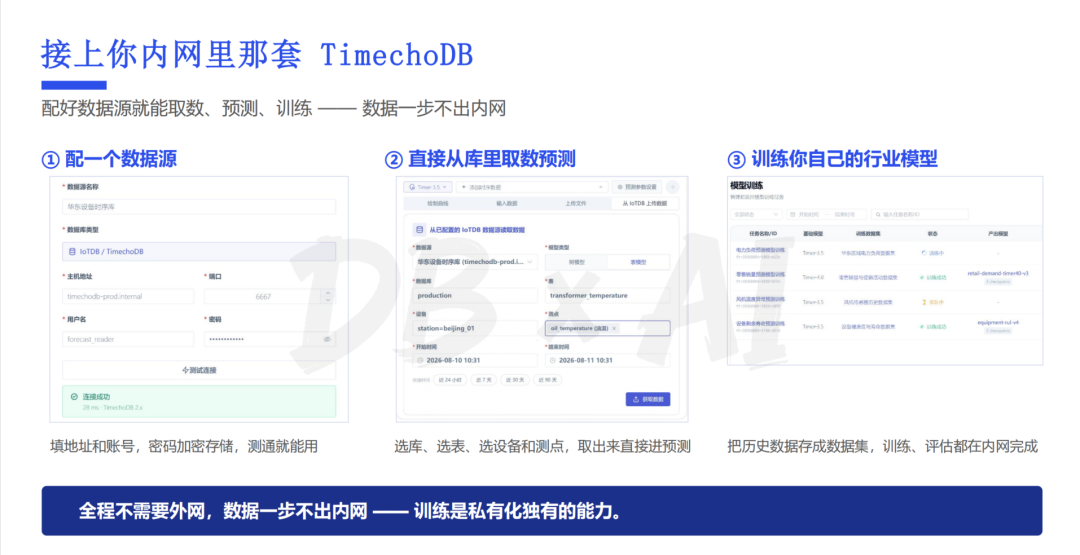
以上我们说的是云版本,但是在一些无法连接互联网的工业内网、政务网络和其他物理隔离环境中,用户不是不愿意上云,而是没有条件上云。此时私有化版本不是选择题,而是必答题。我们的私有化 AI 能力已打包好,直接对接内网现有的 TimechoDB,安装即可使用,无需拼接。用户可以在配好的数据源中直接取数、预测、训练,数据全程不出内网。
若零样本效果不完全满足需求,你也可以利用自有数据集,在内网训练专属于自己的模型——所有数据和外网无任何交互。
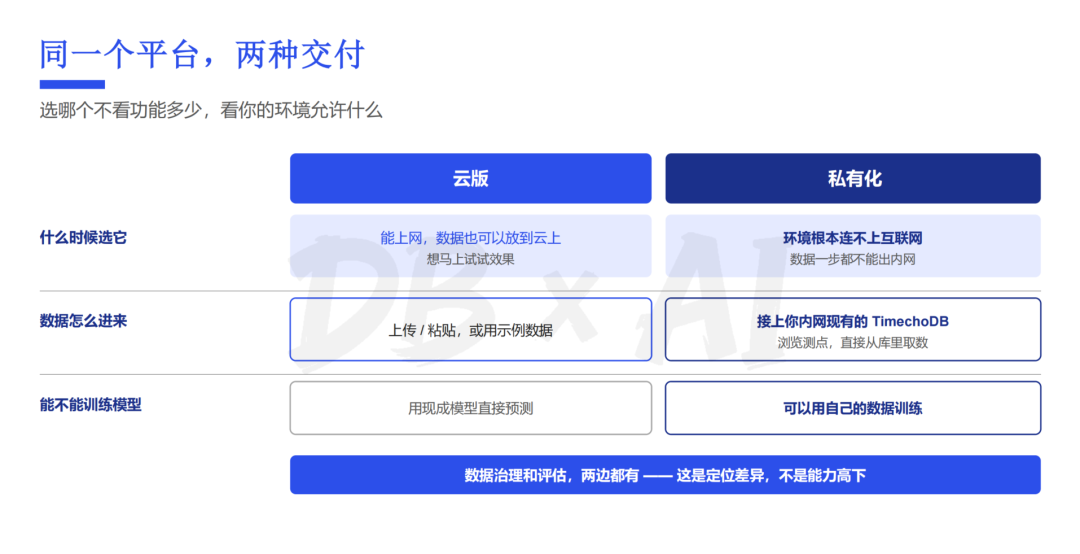
综上,云版与私有化版是同一平台 TimechoAI 的两种交付形式,其中模型训练为私有化独有。而选择云版还是私有化,这不取决于能力高下,而是由业务网络环境、数据安全要求等不同定位差异决定。两套版本均内置数据集治理与评估能力,能够自动识别并修复缺失、乱序时序数据。
第三道坎:已有模型,AI 不会操作数据库
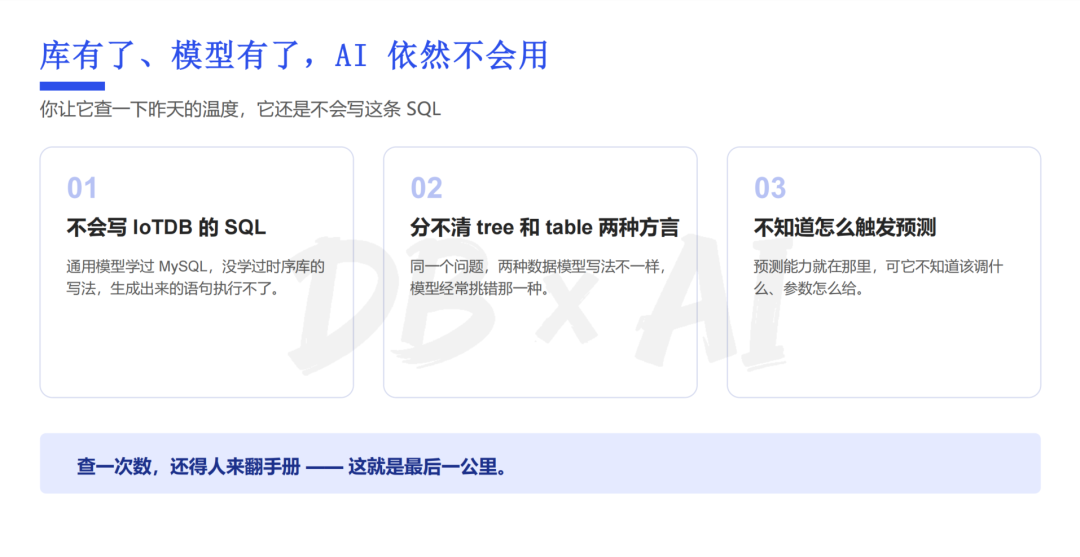
现在,数据库有了,预测能力也有了。但 AI 本身——尤其是通用大模型,并不知道如何操作时序库。你让它查“昨天的温度”,它可能生成一段 MySQL 或 PG 语法,在 IoTDB 上根本无法执行;它也分不清树模型与表模型的差别,更不知道如何触发预测。依靠人工查阅手册、拼接语句的方式,难以满足高频、稳定的生产使用需求。查一次数,还得人来翻手册——这就是最后一公里。
为此,我们推出 TimechoCLI。这是一条命令即可安装的工具,支持集成到 Codex、Claude Code、WorkBuddy 等当前主流的 Agent 中。安装仅需几十秒,之后你的 Agent 就拥有了连接 TimechoDB 和 TimechoAI 的精准能力。我们已内置数十个技能,覆盖部署、运维配置、查询、预测等日常操作。
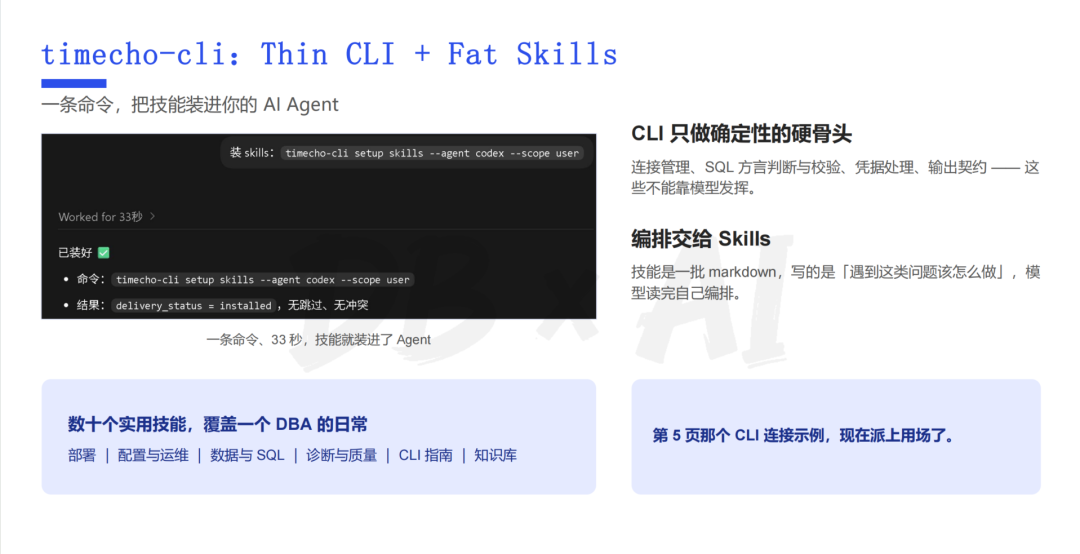
与传统的 CLI 不同,TimechoCLI 是面向 Agent 调用的中间层,负责连接管理(支持多套生产库)、SQL 方言判断(tree / table 两种方言)、数据处理以及凭据安全——密码存入系统钥匙串(keychain),不会出现在 Shell 历史或上下文里。
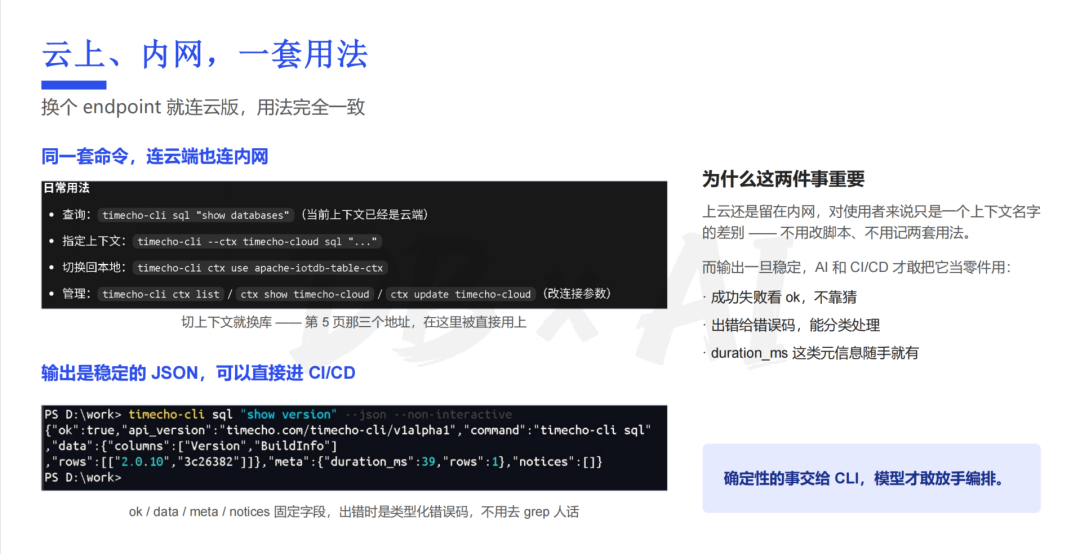
更重要的是,CLI 会对 AI 生成的 SQL 做前置校验,不合法则让大模型重新生成,避免“试错式”执行消耗 Token。同时,CLI 以稳定的 JSON 格式输出结果,并规范错误码,让大模型能精准分类处理——确定性的工作交给 CLI,模型只负责编排。
来看两个实例:
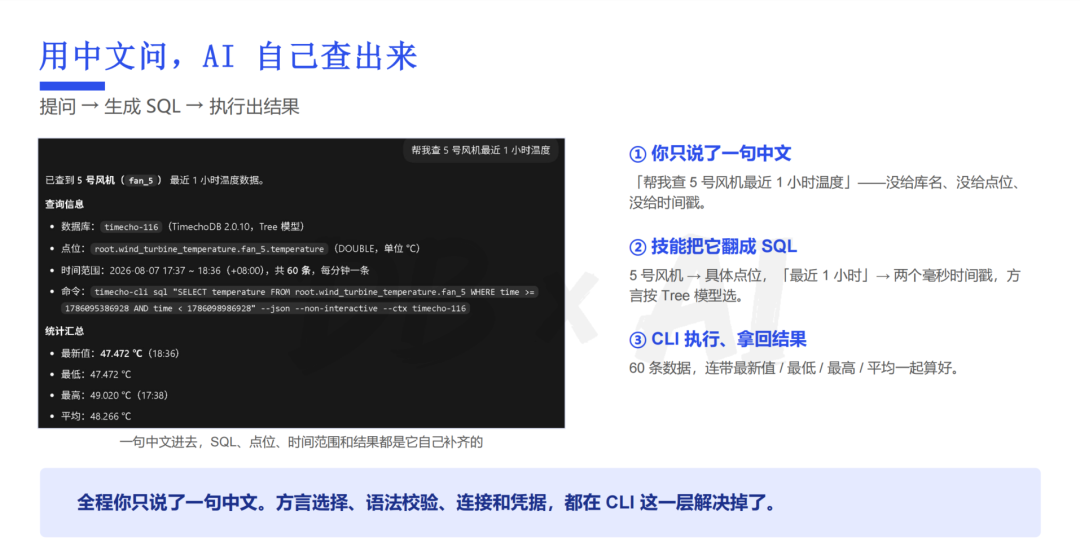
1、输入中文“帮我查 5 号风机最近 1 小时温度”,Agent 依据技能自动补齐库表、点位与时间范围,生成 SQL;CLI 校验通过后执行,返回 60 条数据及最新值、最低、最高、平均值。全程只需一句中文。
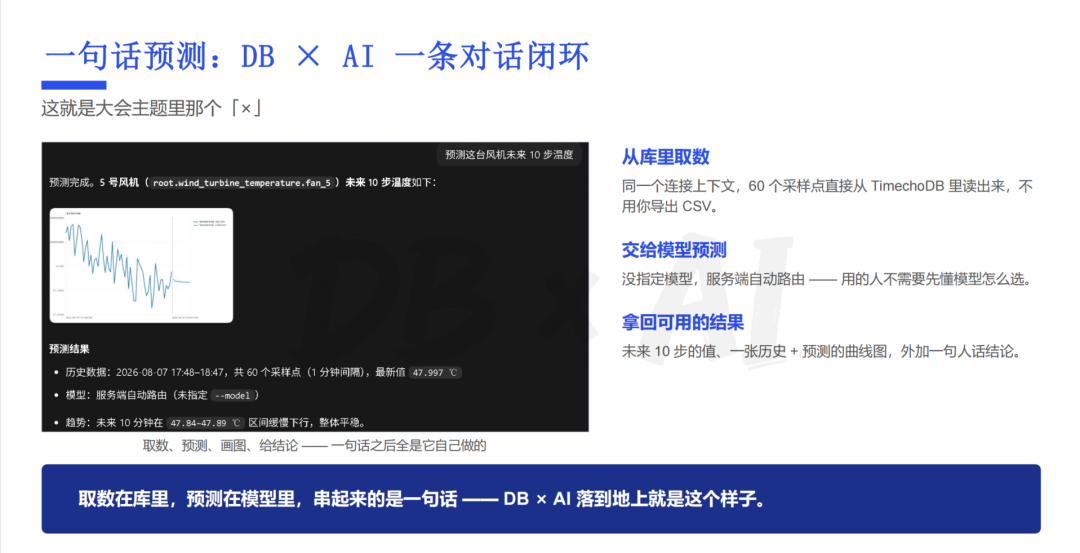
2、输入中文“预测这台风机未来 10 步温度”,Agent 通过 CLI 从库里取出 60 个采样点,调用 TimechoAI 预测(未指定模型,服务端自动路由),再画出历史 + 预测曲线并给出一句结论。
这就是“DB × AI”中那个“ × ”的具象化——DB 提供数据,TimechoAI 提供时序预测,通用大模型提供自然语言交互,CLI 作为可靠桥梁。
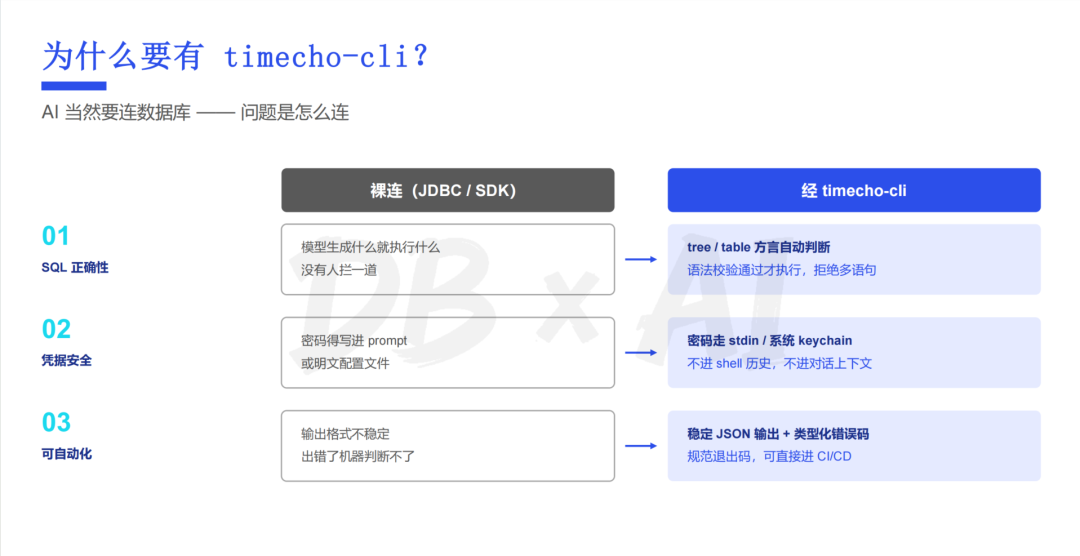
为什么需要独立的 TimechoCLI,而不是直接让 AI 调用 JDBC 或者 SDK?主要出于三点考量:
保障 SQL 正确性:CLI 完成 SQL 前置校验,提前拦截错误语句,减少反复试错,提升执行效率。
保障凭据安全:数据库凭据可以由系统钥匙串(keychain)统一管理,避免密码进入提示词、明文配置文件、命令历史或模型上下文。
保障输出可自动化:统一输出标准化 JSON 格式,规范错误码,让模型能够准确判断执行状态,并继续完成后续编排。
TimechoCLI 实现云上、内网环境一套用法。仅切换 endpoint 配置,同一套命令就可以对接云实例或者内网私有化实例,支持多套数据库实例管理切换,确定性的执行交给 CLI,大模型专注上层业务编排。
跨越三道门槛,完成 DB × AI 的闭环
TimechoDB Cloud 解决 “没有数据库” 的第一道门槛;TimechoAI 解决 “AI 不懂时序” 的第二道门槛,提供零样本时序预测,兼顾云与私有化部署;TimechoCLI 跨过 “AI 不会操作数据库” 的最后一关,让大模型可以用自然语言驱动时序数据库读写与 AI 预测。
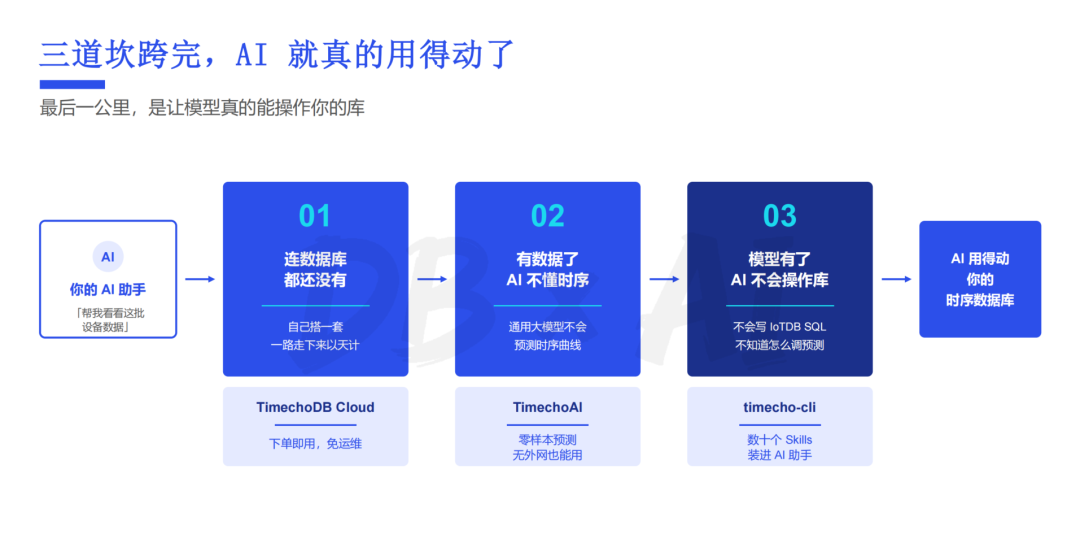
三道坎全部跨越之后,AI 才真的能够用的动你的时序数据库。
模型已经会聊天了,我们要做的,便是让它能真正地动手!
(欢迎访问 Timecho 官网获取更多产品信息与使用手册)


