2026 年 10 月 23 日,阿里云 InfluxDB® 版将正式退市。
真正的迁移难点,不只是一条"导出命令"
时序数据的迁移看起来像"把数据从 A 复制到 B",实则复杂。以下是迁移过程中可能遇到的几个关键难点:
1结构映射
如何确保 measurement、tag、field 等数据结构与目标数据库的表、列相对应,且字段类型不会丢失?
2大数据量处理
如何高效迁移大量数据,避免一次性查询导致的超时或内存溢出,以及迁移中断后的恢复问题?
3结果确认
如何确认迁移产物完整、行数一致,并保留可追溯的迁移记录?
4源实例不可用
若源实例已下线,只剩一份 line protocol 备份,是否还有离线迁移的解决方案?
5后续使用
迁出的数据如何以标准化文件长期保存,并方便后续重新加载和分析?
influxdb2tsfile:面向 influxDB 历史数据导出的开源工具
◎ 项目地址:https://github.com/TimechoLab/influxdb2tsfile
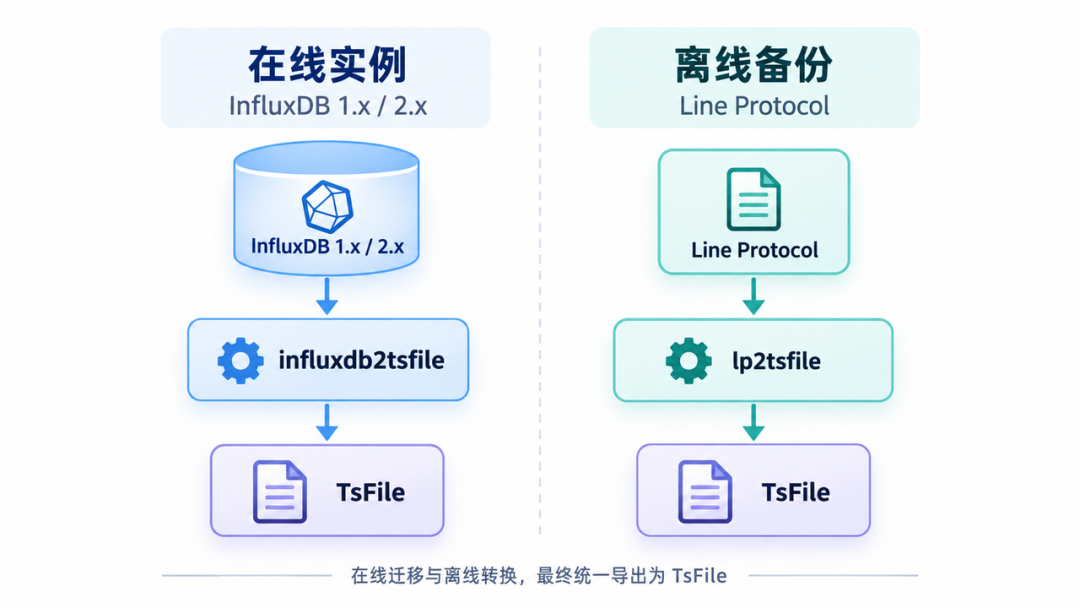
◆ 兼容 InfluxDB 1.x 与 2.x
无论是旧版本的 InfluxDB 1.x 还是新版本的 InfluxDB 2.x,influxdb2tsfile 都能提供支持。1.x 可使用用户名/密码认证,2.x 可使用 API Token;两种版本共用同一套命令和参数。工具只以只读方式查询源库,不会修改源端数据。
◆ Schema 自动识别和映射
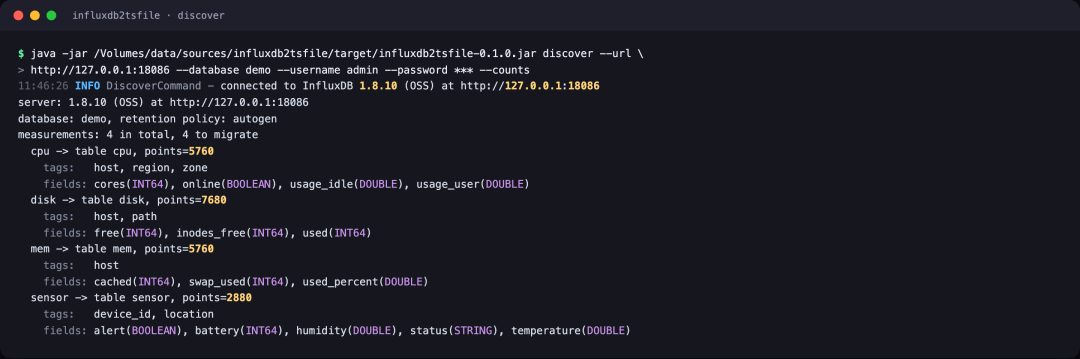
自动识别 InfluxDB 中的 measurement、tag、field 及其类型,并将其转换为 TsFile 表模型。迁移前可先运行 discover 看清结构,用 --dry-run 打印迁移计划,不读取、不写入任何数据。
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
◆ 大数据量可切片、并行、断点续跑
将迁移任务拆分为多个小单元,支持并行执行和断点续传。以"measurement × 时间切片"为一个工作单元,靠 --time-slice 与 --parallel 切片并行,内存占用更可控。相同参数重复执行是幂等的;--resume 只补做缺失、失败或失效的单元。
◆ 每批数据都有记录,迁完还能校验
迁移过程中生成 manifest.json,逐单元记录文件、行数、设备数、时间范围和列映射。结束后 --verify 回读比对;也可事后运行 inspect --manifest 独立校验。行数不一致时退出码为 1,便于脚本和 CI 自动判断。
◆ 实例下线了,也能离线转换
对于已经无法连接的实例,可以使用 lp2tsfile,把 influxd export / influx export 产生的 line protocol 文件或标准输入转换成 TsFile。在线迁移和离线迁移两条路,覆盖退市过程中的不同时间窗口。
使用前需要了解的几个边界
· 工具只迁移时序数据;用户、看板、连续查询、订阅、任务等元数据不在范围内。
· 默认只读取 InfluxDB 1.x 的默认保留策略,其他 RP 需通过 --rp 单独迁移。
· 多个 database / bucket 写入同一目录时,应使用 --table-prefix 区分表名。
· 同一字段存在多种类型时,可使用 --type-conflict text 转为字符串,或在源端先修复。
· --verify 校验的是回读行数与 manifest 是否一致,属于迁移完整性校验,不等同于逐值比对。
· 工具提供命令行,不提供 Web 界面;运行环境需要 JDK 17 及以上。
· 生成的 TsFile 是开放列式时序文件,可通过 TsFile SDK 直接读取,也可后续加载到 TimechoDB、Apache IoTDB 等系统中继续存储和分析。
迁移步骤
-
1. 下载并解压 下载并解压 influxdb2tsfile 的发行包,确保 Java 环境符合要求。
2. 探查 schema 使用 discover 命令探查 InfluxDB 中的数据结构。
3. 正式迁移 使用 migrate 命令执行迁移,可根据需要调整时间切片和并发数。
4. 校验结果 使用 inspect 命令校验迁移结果,确认行数与 manifest 一致。
-
迁移命令 · Shell
# 1. 下载并解压发行包(需要 JDK 17+)

tar xzf influxdb2tsfile-1.0.0-bin.tar.gz

cd influxdb2tsfile-1.0.0

export JAVA_HOME=/path/to/jdk-17


# 2. 探查 schema 与 TsFile 映射

bin/influxdb2tsfile discover \

  --url http://127.0.0.1:8086 --database telegraf \

  --username admin --password secret --counts


# 3. 正式迁移;执行前可额外加 --dry-run 查看计划

bin/influxdb2tsfile migrate \

  --url http://127.0.0.1:8086 --database telegraf \

  --username admin --password secret \

  --time-slice 1d --parallel 4 \

  -o ./tsfile-out --resume --verify


# 4. 回读产物,并与 manifest 校验

bin/influxdb2tsfile inspect \

  ./tsfile-out --manifest ./tsfile-out/manifest.json
InfluxDB 2.x 只需将用户名/密码替换为 --token <api-token>。对于仍在线、数据量较大的实例,建议先做 --dry-run,再根据查询压力和存储空间逐步调整时间切片与并发数。
完整跑通一次迁移:23,520 个数据点,0 个失败单元
● 16 个工作单元全部完成,失败数为 0;
● 生成 16 个 TsFile 分片,合计约 210.35 KB;
● --verify 回读校验通过,4 张表的行数与 manifest 一致;
● 同时保留 manifest.json,可追溯每个分片的行数、设备数和时间范围。
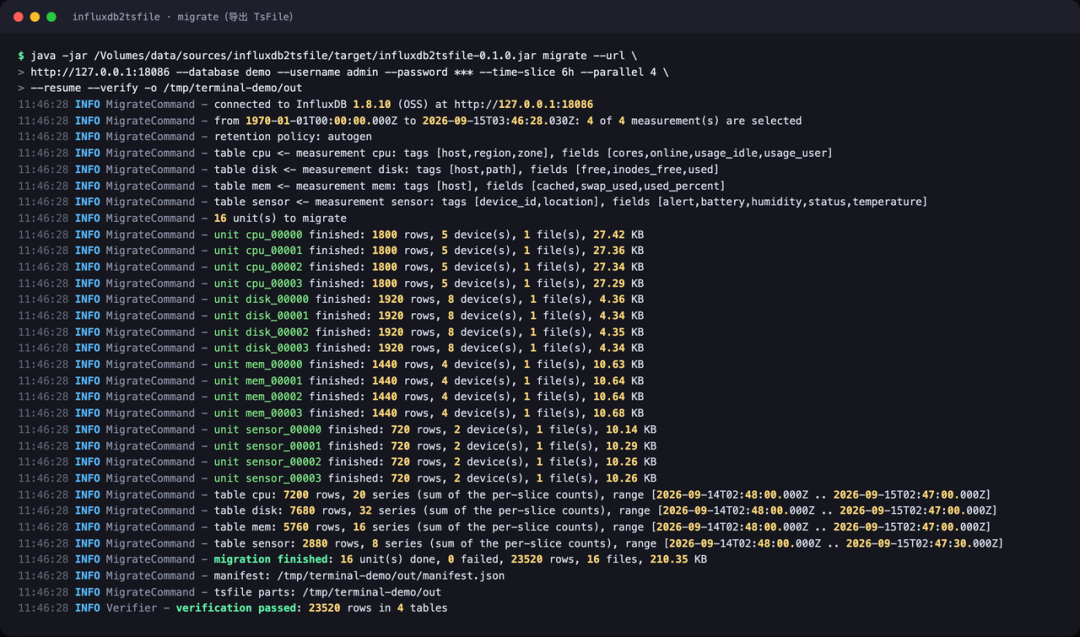
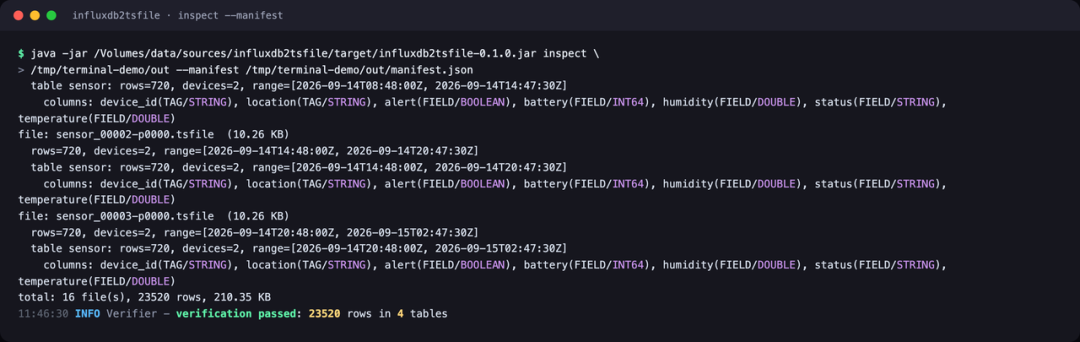
这是一组小规模功能验证数据,不代表生产环境的性能上限,但它完整跑通了"探查—迁移—续跑—校验"的关键路径。
退市不是终点,数据应当继续可用
▸ 项目地址:https://github.com/TimechoLab/influxdb2tsfile
▸ 下载 v1.0.0:https://github.com/TimechoLab/influxdb2tsfile/releases/tag/v1.0.0
▸ 中文用户手册:https://github.com/TimechoLab/influxdb2tsfile/blob/main/docs/%E7%94%A8%E6%88%B7%E6%89%8B%E5%86%8C.md
▸ 开源协议:Apache License 2.0